Web Scraping dans Cursor : Un Guide Complet
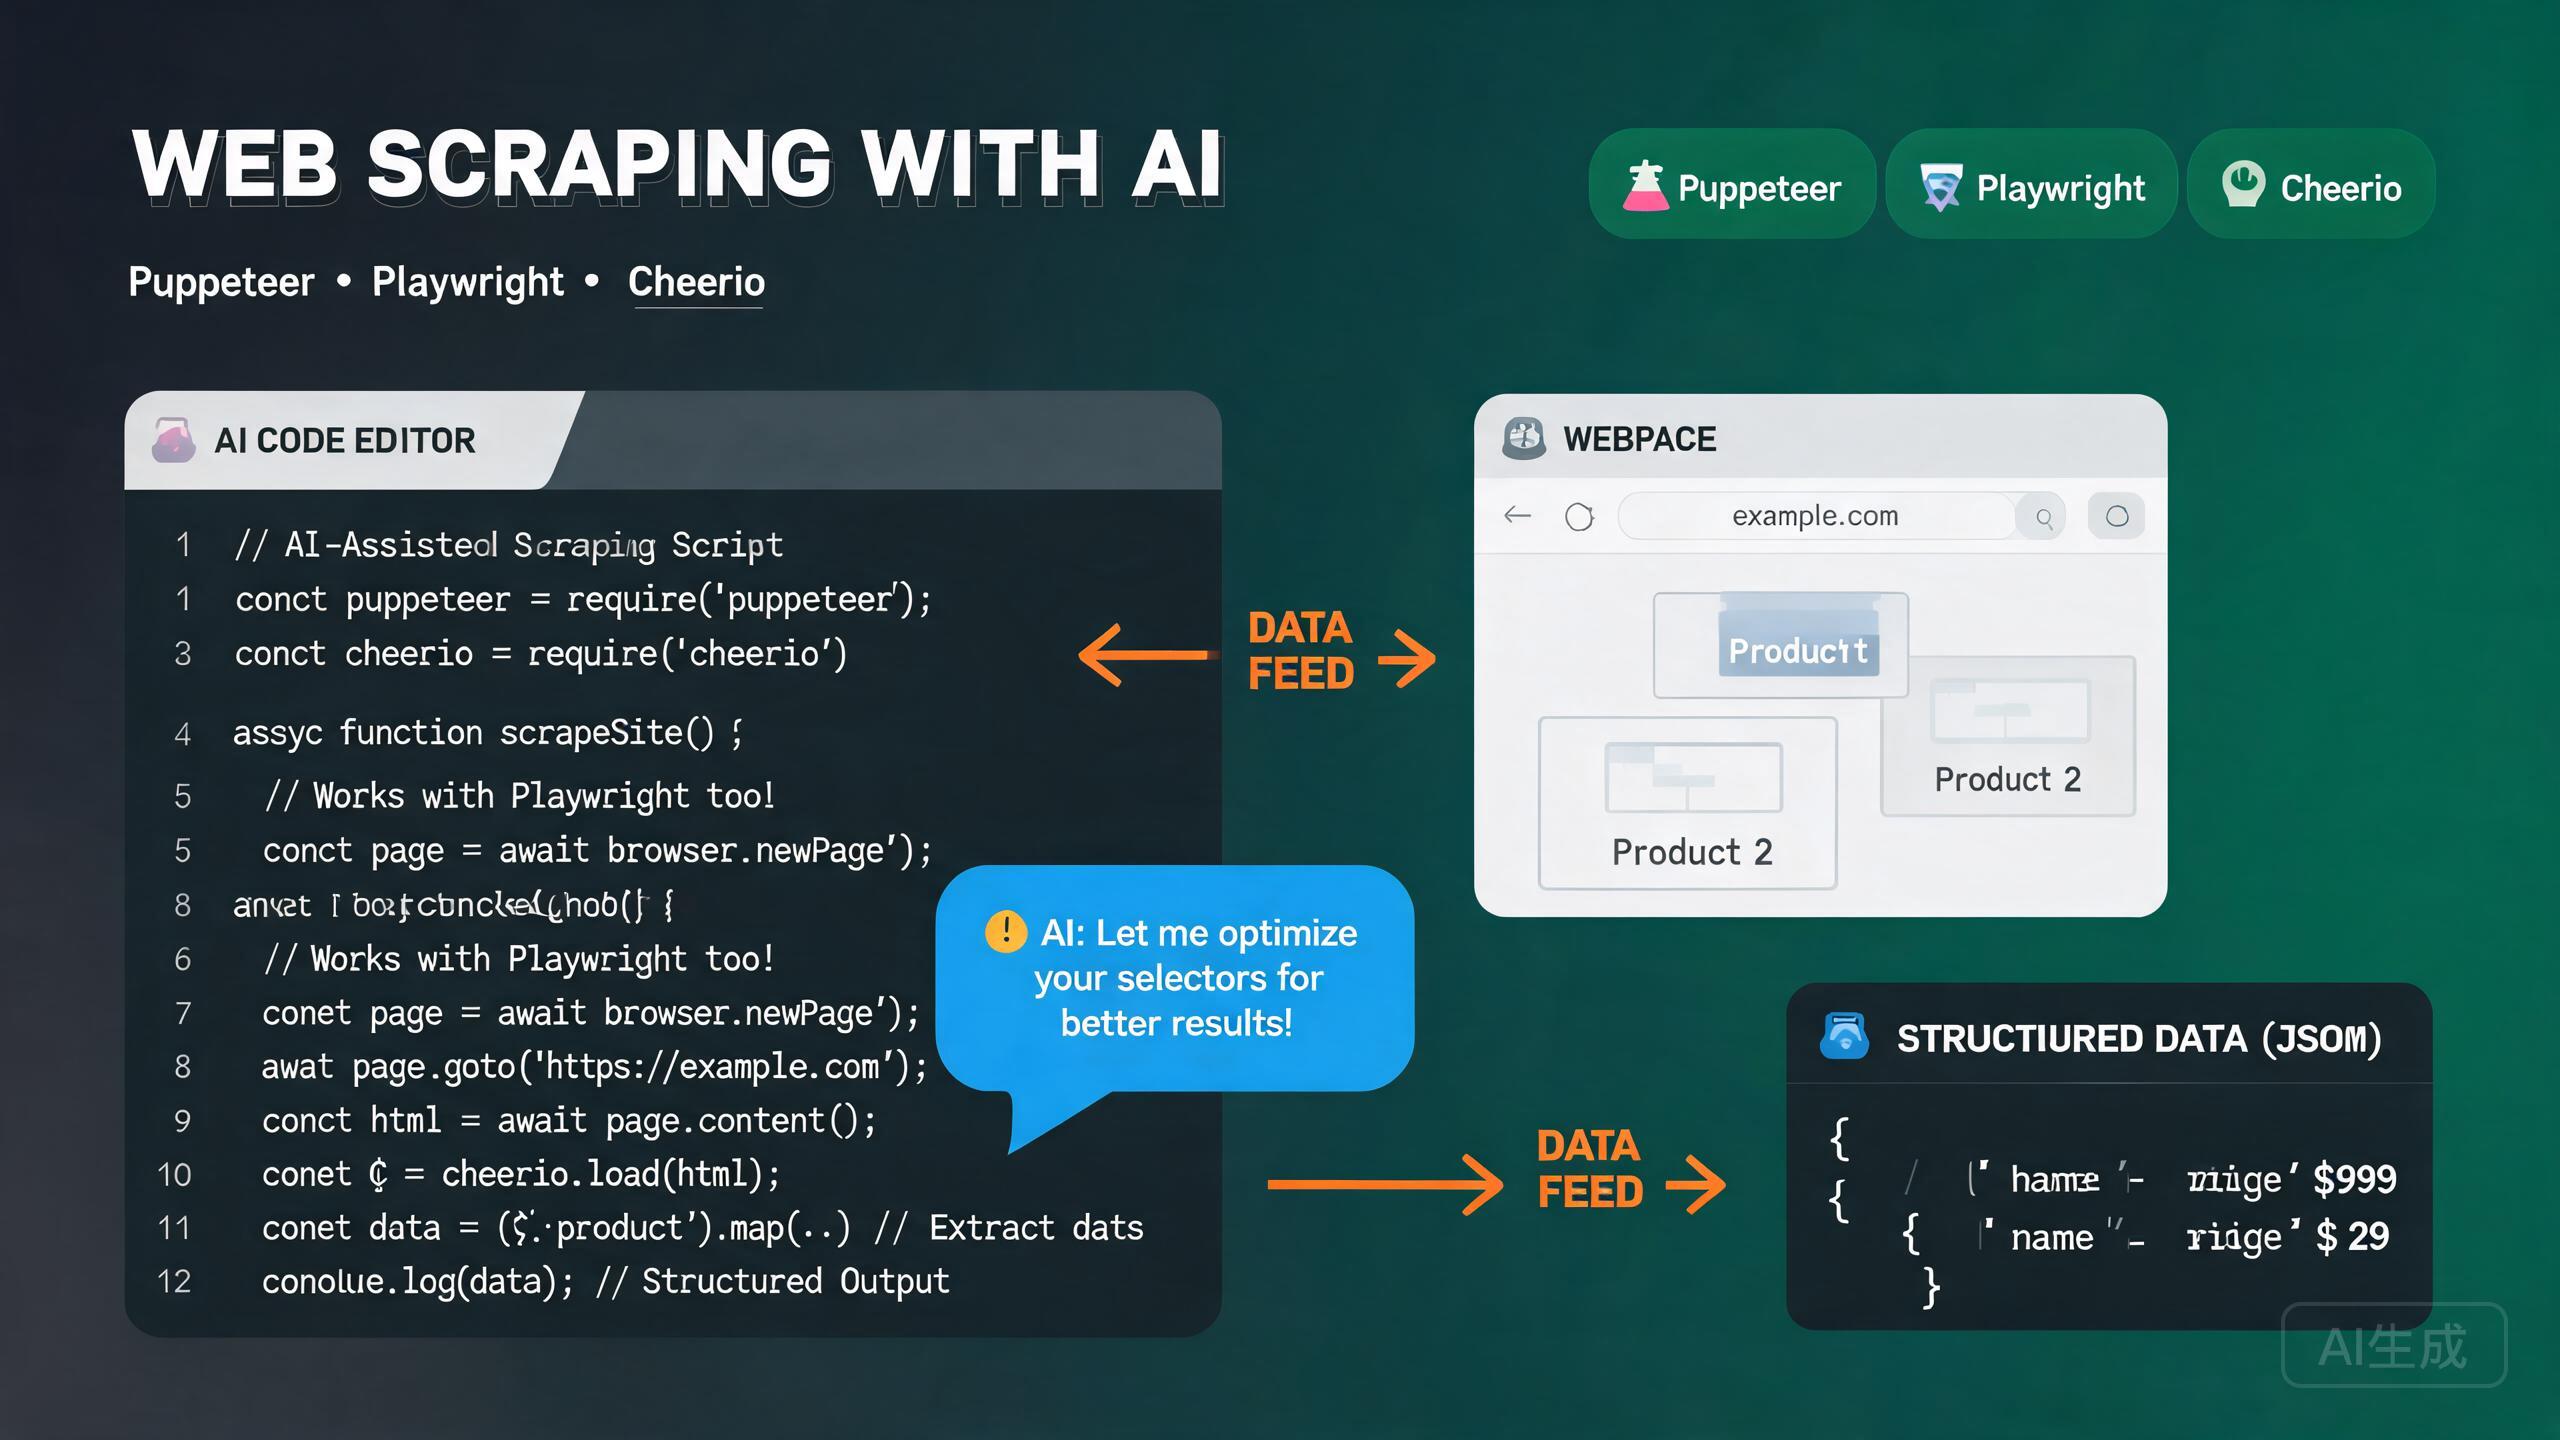
Le web scraping est le processus d'extraction programmatique de données à partir de sites web. Il alimente la surveillance des prix, la génération de leads, l'agrégation de nouvelles, la recherche de marché et la collecte de données pour l'apprentissage automatique. L'écosystème Node.js offre trois outils dominants : Puppeteer pour l'automatisation Chrome headless, Playwright pour l'automatisation cross-browser et Cheerio pour l'analyse HTML rapide. Cursor, avec son assistant IA intégré et son serveur de langage TypeScript intégré, est un excellent éditeur pour les projets de scraping -- il fournit l'IntelliSense pour les API navigateur, l'autocomplétion des chaînes de sélecteurs et peut générer une logique d'extraction à partir de descriptions en langage naturel de pages web.
Ce guide couvre le flux de travail complet de web scraping dans Cursor : le choix du bon outil, la configuration de Puppeteer et Playwright, l'analyse HTML avec Cheerio, l'implémentation de motifs d'extraction, le contournement des mesures anti-bot et l'exploitation de l'extraction assistée par IA.
Choisir le Bon Outil
Chaque outil de scraping a des forces distinctes. Comprendre quand utiliser chacun est le fondement d'une stratégie de scraping efficace.
| Outil | Idéal pour | Navigateur | Vitesse | Complexité |
|---|---|---|---|---|
| Cheerio | HTML statique, analyse rapide | Aucun | Très rapide | Faible |
| Puppeteer | Pages rendues par JS dynamique | Chrome/Chromium | Moyenne | Moyenne |
| Playwright | Cross-browser, SPA modernes | Chrome, Firefox, WebKit | Moyenne | Moyenne-Élevée |
| Puppeteer + Cheerio | Approche hybride | Chrome | Rapide | Moyenne |
Demandez à Cursor : "Je dois scraper un site web. Les données dont j'ai besoin sont rendues par JavaScript après le chargement de la page. Quel outil devrais-je utiliser et pourquoi ?" Cursor recommandera Puppeteer ou Playwright et expliquera pourquoi Cheerio seul ne peut pas capturer le contenu rendu dynamiquement.
Configuration d'un Projet de Scraping dans Cursor
Initialisation du Projet
mkdir web-scraper && cd web-scraper
npm init -y
npm install typescript tsx @types/node --save-dev
npx tsc --init
Utilisez tsx pour exécuter directement des scripts de scraping TypeScript sans étape de build séparée. Exécutez npx tsx scraper.ts depuis le terminal intégré de Cursor (Ctrl+`) pour tester les scripts immédiatement.
Installation de Puppeteer
npm install puppeteer
Puppeteer télécharge un Chromium groupé par défaut. Vérifiez l'installation :
// test-puppeteer.ts
import puppeteer from 'puppeteer';

const browser = await puppeteer.launch({ headless: true });
const page = await browser.newPage();
await page.goto('https://example.com');
console.log(await page.title());
await browser.close();
Installation de Playwright
npm install playwright
npx playwright install  # Downloads browser binaries
Vérifiez :
// test-playwright.ts
import { chromium } from 'playwright';

const browser = await chromium.launch({ headless: true });
const page = await browser.newPage();
await page.goto('https://example.com');
console.log(await page.title());
await browser.close();
Installation de Cheerio
npm install cheerio
Cheerio analyse les chaînes HTML sans navigateur, ce qui en fait l'option la plus rapide pour les pages statiques :
// test-cheerio.ts
import * as cheerio from 'cheerio';

const html = '<div class="item"><h2>Title</h2><span class="price">$9.99</span></div>';
const $ = cheerio.load(html);
console.log($('.item h2').text());     // "Title"
console.log($('.item .price').text());  // "$9.99"
Cheerio ne peut pas exécuter JavaScript. Si la page cible rend le contenu dynamiquement via JS côté client (React, Vue, etc.), Cheerio ne verra que le squelette HTML initial. Utilisez Puppeteer ou Playwright pour ces sites.
Scraping avec Puppeteer
Puppeteer fournit une API de haut niveau pour contrôler Chrome ou Chromium. Il est idéal pour scraper des pages rendues par JavaScript, gérer les connexions et interagir avec les éléments de page.
Scrapage de Page de Base
// scrape-products-puppeteer.ts
import puppeteer from 'puppeteer';
import * as cheerio from 'cheerio';

interface Product {
  name: string;
  price: string;
  rating: string;
  url: string;
}

async function scrapeProducts(): Promise<Product[]> {
  const browser = await puppeteer.launch({
    headless: true,
    args: ['--no-sandbox', '--disable-setuid-sandbox'],
  });

  try {
    const page = await browser.newPage();

    // Set a realistic viewport
    await page.setViewport({ width: 1920, height: 1080 });

    // Set a realistic user agent
    await page.setUserAgent(
      'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36'
    );

    // Navigate and wait for the product grid to render
    await page.goto('https://example-store.com/products', {
      waitUntil: 'networkidle2',
      timeout: 30000,
    });

    // Wait for the product cards to appear
    await page.waitForSelector('.product-card', { timeout: 10000 });

    // Scroll to trigger lazy-loaded content
    await autoScroll(page);

    // Extract data from the page
    const products = await page.evaluate(() =>
      Array.from(document.querySelectorAll('.product-card')).map((card) => ({
        name: card.querySelector('.product-name')?.textContent?.trim() ?? '',
        price: card.querySelector('.product-price')?.textContent?.trim() ?? '',
        rating: card.querySelector('.product-rating')?.textContent?.trim() ?? '',
        url: card.querySelector('a')?.href ?? '',
      }))
    );

    return products;
  } finally {
    await browser.close();
  }
}

async function autoScroll(page: puppeteer.Page) {
  await page.evaluate(async () => {
    await new Promise<void>((resolve) => {
      let totalHeight = 0;
      const distance = 100;
      const timer = setInterval(() => {
        window.scrollBy(0, distance);
        totalHeight += distance;
        if (totalHeight >= document.body.scrollHeight) {
          clearInterval(timer);
          resolve();
        }
      }, 100);
    });
  });
}

const products = await scrapeProducts();
console.log(`Scraped ${products.length} products`);
console.log(products[0]);
La fonction autoScroll est essentielle pour les pages à défilement infini. De nombreux sites chargent les produits paresseusement au défilement. Sans défilement, Puppeteer ne capture que les éléments initialement chargés.
Gestion de la Pagination
async function scrapeAllPages(baseUrl: string): Promise<Product[]> {
  const browser = await puppeteer.launch({ headless: true });
  const page = await browser.newPage();
  const allProducts: Product[] = [];
  let currentPage = 1;
  let hasNextPage = true;

  try {
    while (hasNextPage) {
      await page.goto(`${baseUrl}?page=${currentPage}`, { waitUntil: 'networkidle2' });
      await page.waitForSelector('.product-card', { timeout: 10000 });

      const products = await page.evaluate(() =>
        Array.from(document.querySelectorAll('.product-card')).map((card) => ({
          name: card.querySelector('.product-name')?.textContent?.trim() ?? '',
          price: card.querySelector('.product-price')?.textContent?.trim() ?? '',
          rating: card.querySelector('.product-rating')?.textContent?.trim() ?? '',
          url: card.querySelector('a')?.href ?? '',
        }))
      );
      allProducts.push(...products);

      hasNextPage = await page.evaluate(
        () => document.querySelector('.pagination .next:not(.disabled)') !== null
      );
      currentPage++;
      await new Promise((r) => setTimeout(r, 2000));
    }
  } finally {
    await browser.close();
  }
  return allProducts;
}
Ajoutez toujours des délais entre les requêtes de page. Un scrapage trop rapide peut déclencher une limitation de débit, des bannissements d'IP ou des défis CAPTCHA. Un délai de 1-3 secondes entre les requêtes est un bon point de départ. Pour les crawls plus importants, utilisez un service de rotation de proxy.
Gestion des Pages Protégées par Connexion
async function scrapeLoggedInPage(email: string, password: string) {
  const browser = await puppeteer.launch({ headless: false }); // Show browser for debugging
  const page = await browser.newPage();

  try {
    await page.goto('https://example.com/login', { waitUntil: 'networkidle2' });
    await page.type('#email', email, { delay: 50 });
    await page.type('#password', password, { delay: 50 });

    await Promise.all([
      page.waitForNavigation({ waitUntil: 'networkidle2' }),
      page.click('#submit'),
    ]);

    // Verify login success
    const isLoggedIn = await page.evaluate(() => !document.querySelector('.login-error'));
    if (!isLoggedIn) throw new Error('Login failed');

    // Scrape the protected page
    await page.goto('https://example.com/dashboard', { waitUntil: 'networkidle2' });
    return await page.evaluate(() => document.querySelector('.dashboard-data')?.textContent);
  } finally {
    await browser.close();
  }
}
Scraping avec Playwright
Playwright est l'outil d'automatisation cross-browser de Microsoft. Il prend en charge Chromium, Firefox et WebKit, et a une API plus moderne que Puppeteer.
Scrapage Playwright de Base
// scrape-playwright.ts
import { chromium } from 'playwright';

interface Article {
  title: string;
  author: string;
  date: string;
  summary: string;
  url: string;
}

async function scrapeArticles(): Promise<Article[]> {
  const browser = await chromium.launch({ headless: true });
  const context = await browser.newContext({
    userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
    viewport: { width: 1920, height: 1080 },
  });

  const page = await context.newPage();

  try {
    await page.goto('https://example-blog.com', {
      waitUntil: 'domcontentloaded',
      timeout: 30000,
    });

    // Wait for articles to load
    await page.waitForSelector('.article-card', { timeout: 10000 });

    const articles = await page.$$eval('.article-card', (cards) =>
      cards.map((card) => ({
        title: card.querySelector('.article-title')?.textContent?.trim() ?? '',
        author: card.querySelector('.article-author')?.textContent?.trim() ?? '',
        date: card.querySelector('.article-date')?.textContent?.trim() ?? '',
        summary: card.querySelector('.article-summary')?.textContent?.trim() ?? '',
        url: card.querySelector('a')?.href ?? '',
      }))
    );

    return articles;
  } finally {
    await browser.close();
  }
}
Scraping de SPA avec Interception Réseau
Playwright peut intercepter les requêtes réseau pour capturer directement les réponses API, évitant le besoin d'analyser le HTML rendu :
async function scrapeViaAPI() {
  const browser = await chromium.launch({ headless: true });
  const context = await browser.newContext();
  const page = await context.newPage();

  const apiResponses: any[] = [];

  // Intercept API responses
  page.on('response', async (response) => {
    if (response.url().includes('/api/products') && response.status() === 200) {
      const json = await response.json();
      apiResponses.push(json);
    }
  });

  await page.goto('https://example-store.com', { waitUntil: 'networkidle' });

  await browser.close();

  // Now you have the raw JSON data, no HTML parsing needed
  return apiResponses;
}
L'interception réseau est le moyen le plus fiable de scraper les SPA modernes. Au lieu d'analyser le HTML rendu, vous capturez les réponses JSON de l'API que la page récupère. Demandez à Cursor : "Intercepte les requêtes XHR sur cette page et extrais les données produits de la réponse API." Cursor générera l'écouteur de réponse Playwright.
Analyse HTML avec Cheerio
Cheerio fournit une API de type jQuery pour analyser les chaînes HTML. Il est 10-100 fois plus rapide que le scraping basé sur navigateur car il ne rend pas les pages ni n'exécute JavaScript.
Récupération et Analyse
// scrape-cheerio.ts
import * as cheerio from 'cheerio';

interface Book {
  title: string;
  price: number;
  availability: string;
  rating: number;
}

async function scrapeBooks(): Promise<Book[]> {
  const response = await fetch('https://books.toscrape.com/', {
    headers: {
      'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
    },
  });

  const html = await response.text();
  const $ = cheerio.load(html);

  const books: Book[] = [];

  $('.product_pod').each((_, element) => {
    const $el = $(element);
    const title = $el.find('h3 a').attr('title') ?? '';
    const priceText = $el.find('.price_color').text();
    const price = parseFloat(priceText.replace(/[^0-9.]/g, ''));
    const availability = $el.find('.instock').text().trim();

    // Parse rating from class name (e.g., "star-rating Three" -> 3)
    const ratingClass = $el.find('.star-rating').attr('class') ?? '';
    const ratingMap: Record<string, number> = {
      One: 1, Two: 2, Three: 3, Four: 4, Five: 5,
    };
    const ratingWord = ratingClass.split(' ')[1];
    const rating = ratingMap[ratingWord] ?? 0;

    books.push({ title, price, availability, rating });
  });

  return books;
}
Motifs de Sélecteur Cheerio
Cheerio utilise des sélecteurs de type jQuery : $('.class') pour les classes, $('#id') pour les ID, $('a[href*="/product/"]') pour la correspondance d'attribut, et des méthodes comme .parent(), .siblings(), .children(), .text(), .html() et .attr() pour le parcours et l'extraction DOM.
Si vous connaissez les sélecteurs jQuery, vous connaissez Cheerio. Demandez à Cursor : "Écris une chaîne de sélecteur Cheerio pour extraire tous les noms de produits, prix et URL d'images de cette structure HTML" et collez le HTML. Cursor générera les bons sélecteurs.
Motifs d'Extraction de Données
Extraction de Données Structurées à partir de Tableaux
async function scrapeTable(): Promise<Record<string, string>[]> {
  const response = await fetch('https://example.com/data-table');
  const html = await response.text();
  const $ = cheerio.load(html);

  // Get headers
  const headers: string[] = [];
  $('table thead th').each((_, el) => {
    headers.push($(el).text().trim().toLowerCase().replace(/\s+/g, '_'));
  });

  // Extract rows
  const rows: Record<string, string>[] = [];
  $('table tbody tr').each((_, rowEl) => {
    const cells: string[] = [];
    $(rowEl).find('td').each((_, cellEl) => {
      cells.push($(cellEl).text().trim());
    });

    const row: Record<string, string> = {};
    headers.forEach((header, index) => {
      row[header] = cells[index] ?? '';
    });
    rows.push(row);
  });

  return rows;
}
Extraction de Données JSON-LD
De nombreux sites web intègrent des données structurées au format JSON-LD. C'est la méthode d'extraction la plus fiable lorsqu'elle est disponible :
import * as cheerio from 'cheerio';

async function scrapeJsonLd(url: string) {
  const response = await fetch(url);
  const html = await response.text();
  const $ = cheerio.load(html);

  const jsonLdData: any[] = [];

  $('script[type="application/ld+json"]').each((_, el) => {
    try {
      const data = JSON.parse($(el).contents().text());
      if (Array.isArray(data)) {
        jsonLdData.push(...data);
      } else {
        jsonLdData.push(data);
      }
    } catch (e) {
      console.warn('Failed to parse JSON-LD:', e);
    }
  });

  return jsonLdData;
}

// Usage
const structuredData = await scrapeJsonLd('https://example.com/product/123');
// structuredData[0] might contain: { "@type": "Product", "name": "...", "offers": { "price": "..." } }
JSON-LD est le moyen le plus simple et le plus fiable d'extraire des données structurées. Demandez à Cursor : "Vérifie si cette page a des données structurées JSON-LD et extrais les informations produit." Si le site utilise le balisage schema.org, Cursor l'analysera sans sélecteurs CSS fragiles.
Sauvegarde des Données Extraites
import { writeFileSync } from 'fs';

// Save to JSON
function saveToJson(data: any[], filename: string) {
  writeFileSync(filename, JSON.stringify(data, null, 2));
  console.log(`Saved ${data.length} records to ${filename}`);
}

// Save to CSV
function saveToCsv(data: Record<string, any>[], filename: string) {
  if (data.length === 0) return;
  const headers = Object.keys(data[0]);
  const csvLines = [
    headers.join(','),
    ...data.map((row) =>
      headers.map((h) => `"${String(row[h] ?? '').replace(/"/g, '""')}"`).join(',')
    ),
  ];
  writeFileSync(filename, csvLines.join('\n'));
}
Techniques de Contournement Anti-Bot
Les sites web modernes déploient une protection anti-bot (Cloudflare, reCAPTCHA, Datadome, PerimeterX) pour détecter et bloquer le scraping automatisé. Voici des stratégies pour contourner les protections courantes.
Définition d'En-Têtes Réalistes
const headers = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36',
  'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
  'Accept-Language': 'en-US,en;q=0.9',
  'Accept-Encoding': 'gzip, deflate, br',
  'Connection': 'keep-alive',
  'Upgrade-Insecure-Requests': '1',
};

const response = await fetch(url, { headers });
Utilisation de Puppeteer-Stealth
npm install puppeteer-extra puppeteer-extra-plugin-stealth
import puppeteer from 'puppeteer-extra';
import StealthPlugin from 'puppeteer-extra-plugin-stealth';

puppeteer.use(StealthPlugin());

const browser = await puppeteer.launch({ headless: true });
const page = await browser.newPage();

// The stealth plugin patches common detection vectors:
// - navigator.webdriver = false
// - chrome.runtime object
// - permissions API
// - plugins array
// - languages array
// - WebGL vendor/renderer

await page.goto('https://bot-protected-site.com');
Les plugins furtifs aident mais ne sont pas une solution miracle. Les services anti-bot sophistiqués comme Cloudflare Turnstile utilisent l'empreinte TLS, l'analyse comportementale et des mécanismes de défi-réponse qui vont au-delà des simples vérifications de propriétés navigator. Pour le scraping en production de sites fortement protégés, envisagez des services proxy commerciaux avec résolution CAPTCHA intégrée.
Utilisation de Proxies
// Puppeteer with proxy
const browser = await puppeteer.launch({
  headless: true,
  args: [
    `--proxy-server=http://${proxyHost}:${proxyPort}`,
    '--no-sandbox',
  ],
});

await page.authenticate({
  username: proxyUsername,
  password: proxyPassword,
});

// Playwright with proxy
const browser = await chromium.launch({
  headless: true,
  proxy: {
    server: `http://${proxyHost}:${proxyPort}`,
    username: proxyUsername,
    password: proxyPassword,
  },
});
Rotation des User Agents
const userAgents = [
  'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125.0.0.0 Safari/537.36',
  'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36',
  'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:126.0) Gecko/20100101 Firefox/126.0',
  'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.5 Safari/605.1.15',
];

const randomUA = userAgents[Math.floor(Math.random() * userAgents.length)];
await page.setUserAgent(randomUA);
Gestion des Délais et Comportement de Type Humain
async function humanLikeScroll(page: puppeteer.Page) {
  const totalHeight = await page.evaluate(() => document.body.scrollHeight);
  let scrolled = 0;
  while (scrolled < totalHeight) {
    const scrollAmount = Math.floor(Math.random() * 200) + 100;
    await page.evaluate((y) => window.scrollBy(0, y), scrollAmount);
    scrolled += scrollAmount;
    await new Promise((r) => setTimeout(r, Math.random() * 1500 + 500));
  }
}

async function randomMouseMovement(page: puppeteer.Page) {
  await page.mouse.move(Math.random() * 800, Math.random() * 600);
  await new Promise((r) => setTimeout(r, Math.random() * 500 + 200));
  await page.mouse.move(Math.random() * 800, Math.random() * 600);
}
Demandez à Cursor : "Rends mon scraper Puppeteer plus comme un humain. Ajoute des mouvements de souris aléatoires, des vitesses de défilement variables et des délais aléatoires entre les actions." Cursor générera les fonctions d'imitation comportementale et les intégrera dans votre flux de scraping.
Extraction Assistée par IA dans Cursor
L'assistant IA de Cursor peut générer une logique de scraping à partir de descriptions de pages, identifier des sélecteurs à partir d'extraits HTML et déboguer les extractions échouées.
Génération de Sélecteurs à partir de HTML
Ouvrez Cursor Chat (Ctrl+L) et collez un extrait HTML :
Here is a product card's HTML structure:

<div class="product-item" data-id="123">
  <img src="/img/product.jpg" alt="Product Name" />
  <h3 class="product-title">Product Name</h3>
  <span class="price-current">$29.99</span>
  <span class="price-original">$49.99</span>
  <span class="rating" data-rating="4.5">4.5 stars</span>
  <span class="stock">In Stock</span>
</div>

Generate a Cheerio extraction function with a typed interface.
Include: productId, name, currentPrice, originalPrice, rating, stockStatus, imageUrl.
Cursor générera :
interface ScrapedProduct {
  productId: string;
  name: string;
  currentPrice: number;
  originalPrice: number;
  rating: number;
  stockStatus: string;
  imageUrl: string;
}

function extractProduct($: cheerio.CheerioAPI, element: any): ScrapedProduct {
  const $el = $(element);
  const parsePrice = (sel: string) =>
    parseFloat($el.find(sel).text().replace(/[^0-9.]/g, '')) || 0;

  return {
    productId: $el.attr('data-id') ?? '',
    name: $el.find('.product-title').text().trim(),
    currentPrice: parsePrice('.price-current'),
    originalPrice: parsePrice('.price-original'),
    rating: parseFloat($el.find('.rating').attr('data-rating') ?? '0') || 0,
    stockStatus: $el.find('.stock').text().trim(),
    imageUrl: $el.find('img').attr('src') ?? '',
  };
}
Lorsque vous demandez à Cursor de générer des sélecteurs, collez toujours un échantillon HTML représentatif. Cela garantit que les sélecteurs correspondent à la structure DOM réelle plutôt qu'à une estimation. Cursor identifiera également les cas limites comme les champs optionnels manquants et ajoutera des solutions de repli.
Débogage Assisté par IA
Lorsque votre scraper renvoie des résultats vides, demandez à Cursor de l'aide :
My Puppeteer scraper is returning an empty array. The selector
".product-card" should match elements but page.evaluate returns [].
Here is my code. The page loads successfully and I can see the elements
in the browser. What could be wrong?
Cursor identifiera les problèmes courants :
- Le sélecteur peut être dans un Shadow DOM.
- Le contenu peut être dans un iframe.
- La page peut utiliser un sélecteur différent après une refonte récente.
- L'option
waitUntilpeut être insuffisante.
Les sites web changent fréquemment leur structure HTML. Un scraper qui fonctionne aujourd'hui peut cesser demain. Construisez vos scrapers de manière défensive : utilisez plusieurs sélecteurs de repli, journalisez les échecs d'extraction et mettez en place une surveillance pour détecter quand les sélecteurs cessent de correspondre.
Bonnes Pratiques et Éthique
Respecter le robots.txt
async function checkRobotsTxt(url: string): Promise<boolean> {
  const robotsUrl = `${new URL(url).origin}/robots.txt`;
  try {
    const robotsTxt = await (await fetch(robotsUrl)).text();
    const path = new URL(url).pathname;
    for (const line of robotsTxt.split('\n')) {
      if (line.trim().toLowerCase().startsWith('disallow:')) {
        const disallowed = line.split(':')[1].trim();
        if (disallowed && path.startsWith(disallowed)) return false;
      }
    }
    return true;
  } catch {
    return true; // If robots.txt doesn't exist, assume allowed
  }
}
Vérifiez toujours robots.txt avant de scraper. C'est le protocole standard permettant aux sites web de déclarer quelles pages peuvent être scrapées. Violer le robots.txt peut entraîner des bannissements d'IP et des problèmes juridiques. Utilisez la fonction checkRobotsTxt ci-dessus avant toute opération de scraping.
Limitation de Débit
async function rateLimitedDelay() {
  const delay = Math.random() * 2000 + 1000; // 1-3 second delay
  await new Promise((r) => setTimeout(r, delay));
}

// Usage: call between each page request
await rateLimitedDelay();
Conclusion
Le web scraping dans Cursor combine la puissance de Puppeteer, Playwright et Cheerio avec la génération de code assistée par IA. Cheerio est votre choix de prédilection pour l'analyse HTML statique rapide, Puppeteer gère les pages rendues par JavaScript avec l'automatisation Chrome, et Playwright offre le support cross-browser et l'interception réseau pour les SPA modernes. Les techniques anti-bot -- plugins furtifs, rotation de proxy et comportement de type humain -- vous aident à accéder aux sites protégés, tandis que l'assistant IA de Cursor génère des sélecteurs à partir d'extraits HTML, débogue les extractions échouées et écrit des pipelines de scraping complets à partir de descriptions en langage naturel. Commencez par choisir le bon outil pour votre cible, construisez de manière défensive avec des sélecteurs de repli et une limitation de débit, respectez toujours le robots.txt, et laissez Cursor générer la logique d'extraction afin que vous puissiez vous concentrer sur la qualité des données et la fiabilité du pipeline.