Développement Drizzle ORM dans Cursor : Un Guide Complet
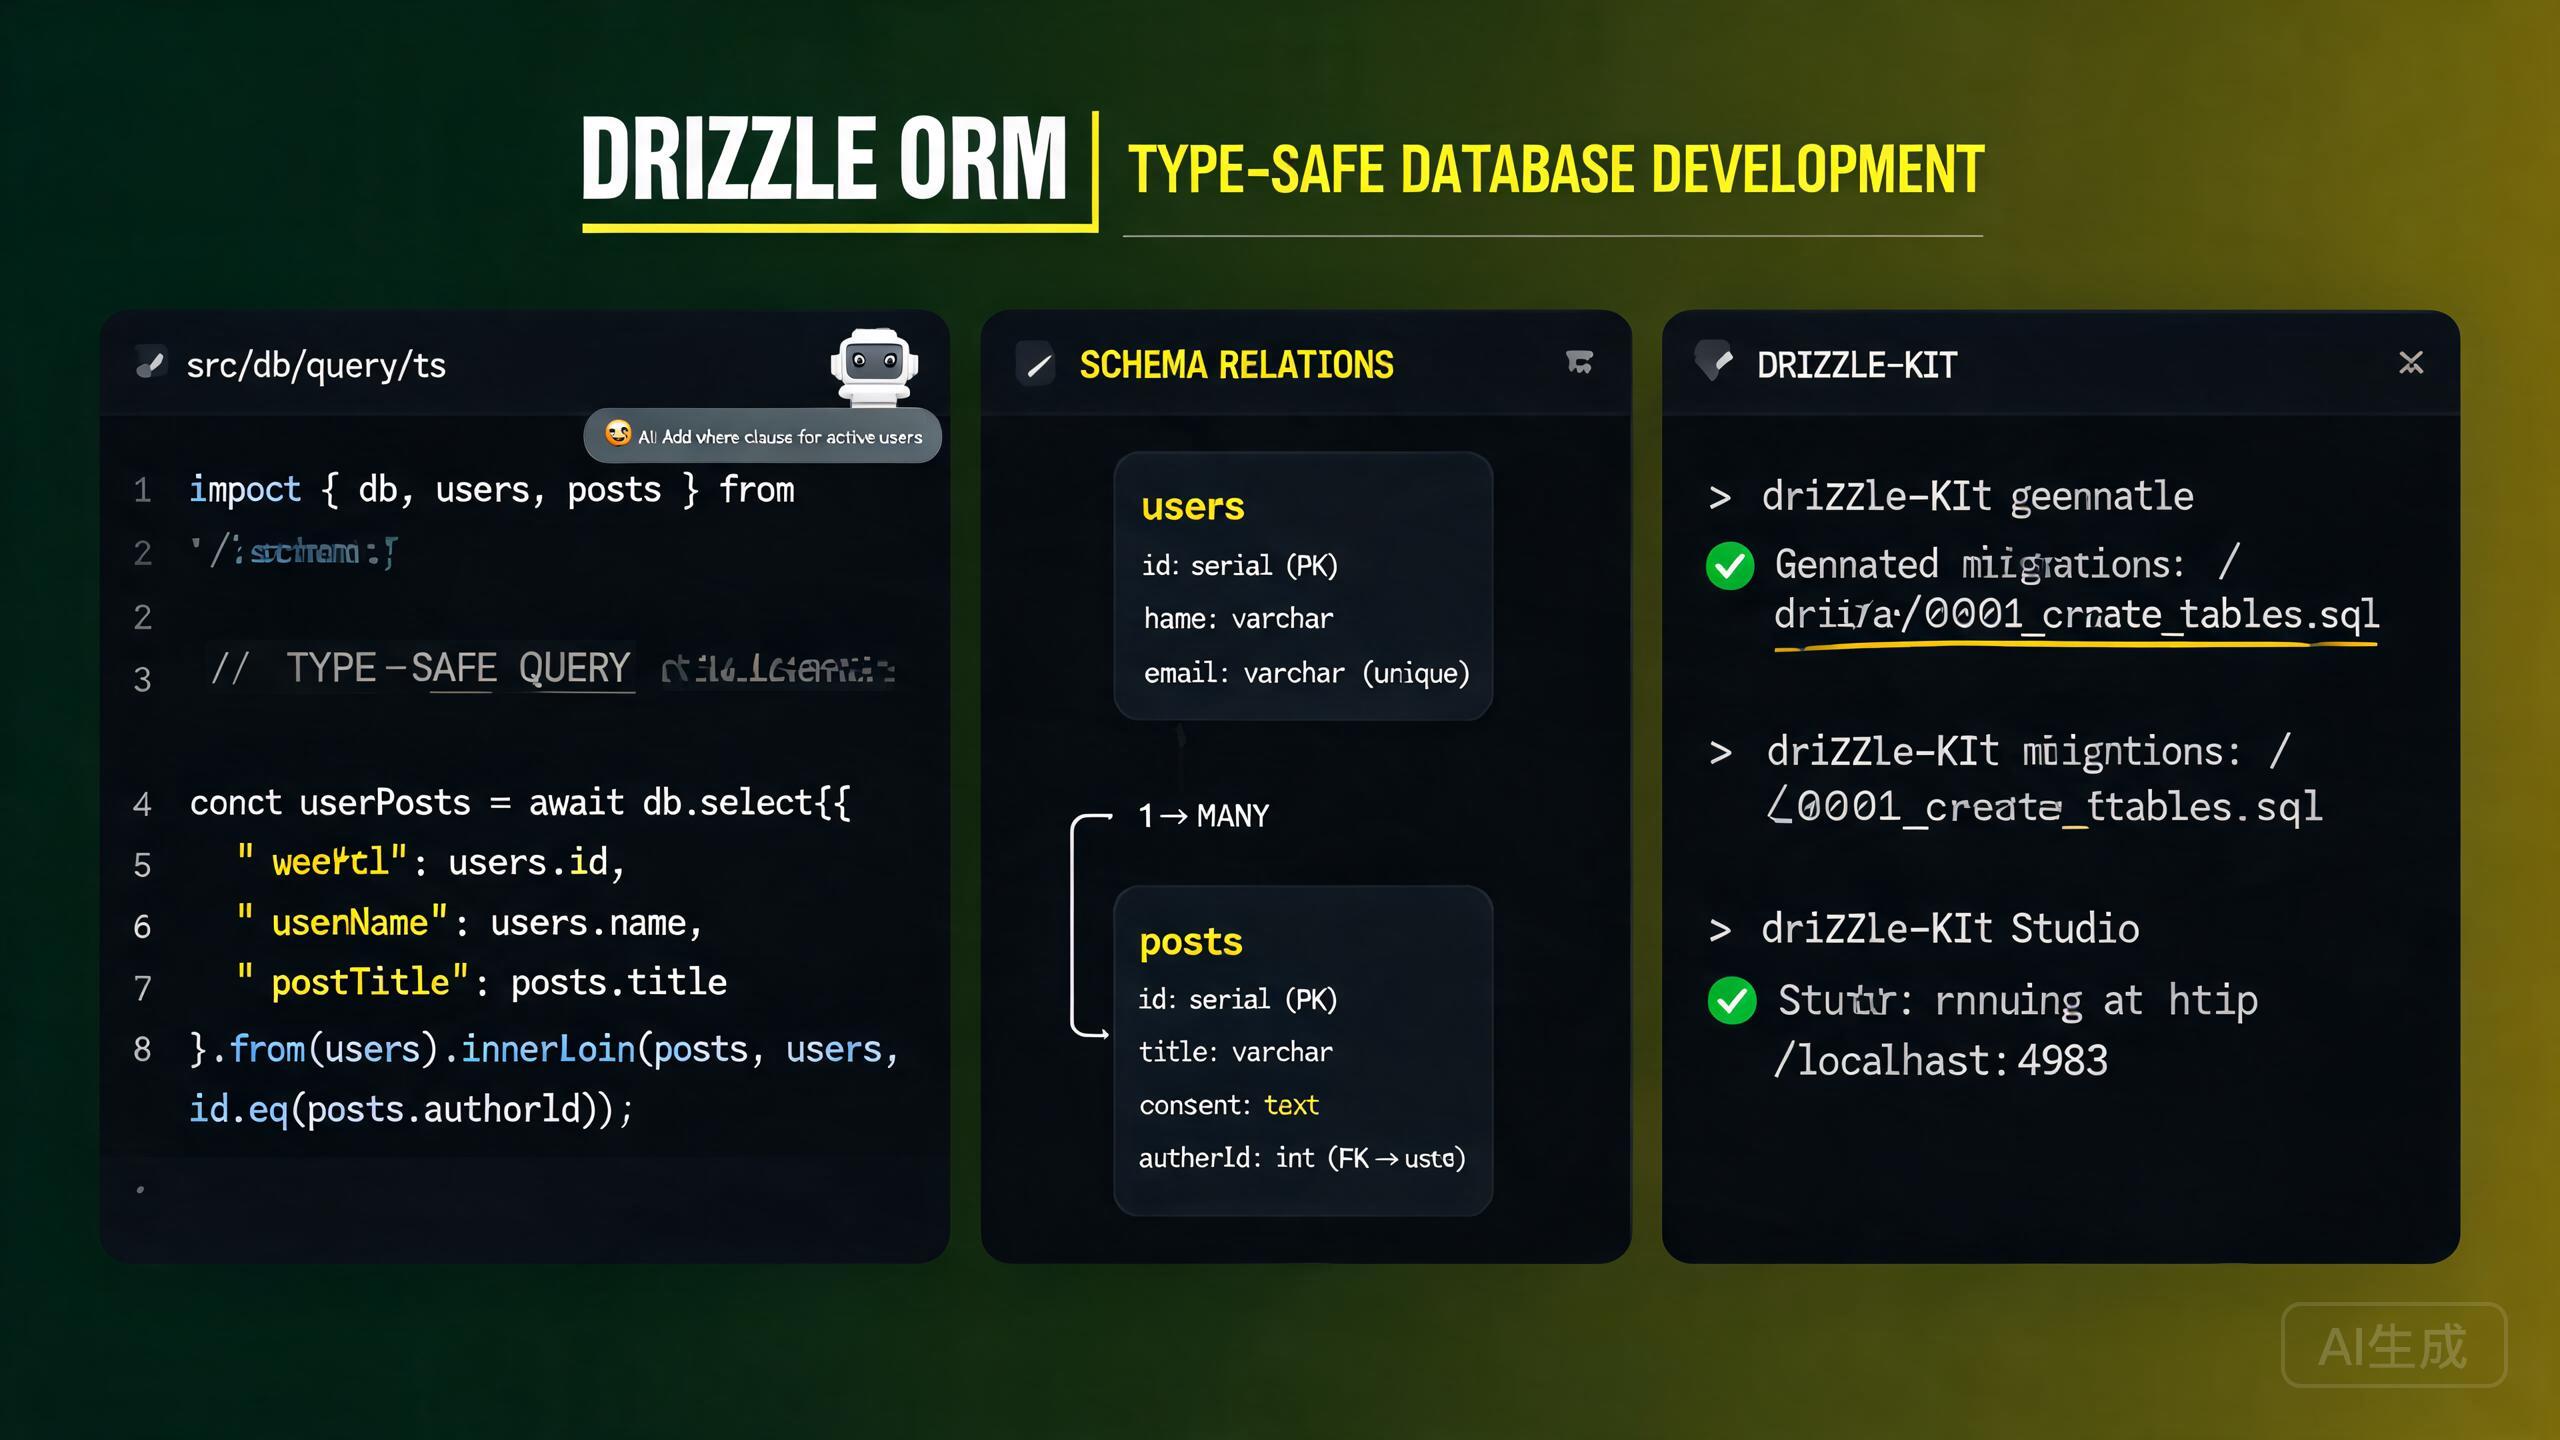
Drizzle ORM est un ORM léger, TypeScript-first, qui fournit des requêtes SQL type-safe sans le surcoût d'un runtime lourd. Contrairement aux ORM traditionnels, Drizzle vous donne un contrôle SQL complet tout en maintenant une sécurité de type complète au moment de la compilation. Drizzle prend en charge PostgreSQL, MySQL et SQLite avec une surface d'API unifiée. Cursor, avec son assistant IA intégré et son serveur de langage TypeScript intégré, est un éditeur idéal pour le développement Drizzle -- il fournit une IntelliSense complète pour les définitions de schéma, l'autocomplétion des constructeurs de requêtes et peut générer des schémas et des requêtes complets à partir de descriptions en langage naturel.
Ce guide couvre le flux de travail complet de développement Drizzle dans Cursor : installation et configuration, définition de schéma, migrations avec drizzle-kit, requêtes type-safe, relations et construction de requêtes assistée par IA.
Installation et Configuration de Drizzle dans Cursor
Prérequis
Drizzle nécessite Node.js 18 ou plus récent et fonctionne avec PostgreSQL, MySQL ou SQLite. Vérifiez votre version de Node.js :
node --version
Le serveur de langage TypeScript intégré de Cursor fournit une vérification de type en temps réel pour les schémas et les requêtes Drizzle. Vous voyez les erreurs de type en ligne avant même d'exécuter votre code, ce qui est particulièrement précieux pour les constructeurs de requêtes fortement typés de Drizzle.
Installation des Dépendances
Installez Drizzle ORM et l'outil CLI drizzle-kit :
# For PostgreSQL
npm install drizzle-orm pg
npm install drizzle-kit --save-dev

# For MySQL
npm install drizzle-orm mysql2
npm install drizzle-kit --save-dev

# For SQLite (better-sqlite3)
npm install drizzle-orm better-sqlite3
npm install drizzle-kit --save-dev

# For SQLite (libSQL/Turso)
npm install drizzle-orm @libsql/client
npm install drizzle-kit --save-dev
Définissez votre chaîne de connexion à la base de données dans .env :
# .env
DATABASE_URL="postgresql://user:password@localhost:5432/mydb"
Configuration de drizzle-kit
Créez un fichier drizzle.config.ts à la racine de votre projet :
// drizzle.config.ts
import { defineConfig } from 'drizzle-kit';

export default defineConfig({
  schema: './src/db/schema.ts',
  out: './drizzle',
  dialect: 'postgresql',
  dbCredentials: {
    url: process.env.DATABASE_URL!,
  },
  verbose: true,
  strict: true,
});
Si vous utilisez MySQL, définissez dialect: 'mysql' dans la configuration. Si vous utilisez SQLite, définissez dialect: 'sqlite'. Le champ dialect détermine quelle saveur de SQL drizzle-kit génère pour les migrations. Un dialecte incorrect produira des fichiers de migration qui échoueront sur votre base de données.
Création du Client de Base de Données
// src/db/client.ts
import { drizzle } from 'drizzle-orm/node-postgres';
import { Pool } from 'pg';
import * as schema from './schema';

const pool = new Pool({
  connectionString: process.env.DATABASE_URL!,
});

export const db = drizzle(pool, { schema });
export type DB = typeof db;
Importez et transmettez toujours votre objet schéma au constructeur drizzle(). Cela active l'API de requête relationnelle (db.query.users.findMany()) qui fournit la récupération de données imbriquées avec une sécurité de type complète.
Définition de Schéma
Les schémas Drizzle sont définis dans des fichiers TypeScript à l'aide de fonctions de construction. Chaque fonction correspond à un type de colonne SQL.
Définition de Tables
// src/db/schema.ts
import {
  pgTable,
  uuid,
  varchar,
  text,
  boolean,
  integer,
  timestamp,
  enum,
  pgEnum,
} from 'drizzle-orm/pg-core';
import { relations } from 'drizzle-orm';

// Enums
export const userRoleEnum = pgEnum('user_role', ['admin', 'member', 'viewer']);

// Users table
export const users = pgTable('users', {
  id: uuid('id').defaultRandom().primaryKey(),
  email: varchar('email', { length: 255 }).notNull().unique(),
  name: varchar('name', { length: 100 }),
  role: userRoleEnum('role').default('member').notNull(),
  avatarUrl: text('avatar_url'),
  createdAt: timestamp('created_at').defaultNow().notNull(),
  updatedAt: timestamp('updated_at').defaultNow().notNull(),
});

// Posts table
export const posts = pgTable('posts', {
  id: uuid('id').defaultRandom().primaryKey(),
  title: varchar('title', { length: 200 }).notNull(),
  content: text('content'),
  published: boolean('published').default(false).notNull(),
  viewCount: integer('view_count').default(0).notNull(),
  authorId: uuid('author_id').references(() => users.id, { onDelete: 'cascade' }),
  createdAt: timestamp('created_at').defaultNow().notNull(),
  updatedAt: timestamp('updated_at').defaultNow().notNull(),
});

// Profiles table
export const profiles = pgTable('profiles', {
  id: uuid('id').defaultRandom().primaryKey(),
  bio: text('bio'),
  userId: uuid('user_id').references(() => users.id, { onDelete: 'cascade' }).unique(),
  createdAt: timestamp('created_at').defaultNow().notNull(),
});
Types de Colonne Courants (PostgreSQL)
| Fonction Drizzle | Type SQL | Notes |
|---|---|---|
uuid() | UUID | Utilisez .defaultRandom() pour la génération automatique |
varchar({ length: n }) | VARCHAR(n) | Chaîne de longueur variable |
text() | TEXT | Chaîne de longueur illimitée |
integer() | INTEGER | Entier 32 bits |
boolean() | BOOLEAN | Vrai/faux |
timestamp() | TIMESTAMP | Utilisez .defaultNow() pour le remplissage auto |
jsonb() | JSONB | Données structurées |
serial() | SERIAL | Entier auto-incrémenté |
pgEnum() | ENUM | Type d'énumération PostgreSQL |
decimal() | DECIMAL | Nombre à virgule fixe |
Demandez à Cursor : "Génère un schéma Drizzle pour PostgreSQL avec des modèles User, Post, Comment et Tag. Utilise des clés primaires UUID, inclus des horodatages et configure des relations un-à-plusieurs et plusieurs-à-plusieurs." Cursor produira un schéma TypeScript validé avec des imports et des définitions de relation corrects.
Définition des Relations
Les relations Drizzle sont définies séparément des tables à l'aide de la fonction relations(). Elles n'affectent pas le schéma de base de données -- elles configurent uniquement l'API de requête relationnelle :
// src/db/schema.ts (continued)
import { relations } from 'drizzle-orm';

export const usersRelations = relations(users, ({ one, many }) => ({
  profile: one(profiles, {
    fields: [users.id],
    references: [profiles.userId],
  }),
  posts: many(posts),
}));

export const postsRelations = relations(posts, ({ one, many }) => ({
  author: one(users, {
    fields: [posts.authorId],
    references: [users.id],
  }),
  comments: many(comments),
}));

export const profilesRelations = relations(profiles, ({ one }) => ({
  user: one(users, {
    fields: [profiles.userId],
    references: [users.id],
  }),
}));

export const comments = pgTable('comments', {
  id: uuid('id').defaultRandom().primaryKey(),
  content: text('content').notNull(),
  authorId: uuid('author_id').references(() => users.id, { onDelete: 'cascade' }),
  postId: uuid('post_id').references(() => posts.id, { onDelete: 'cascade' }),
  createdAt: timestamp('created_at').defaultNow().notNull(),
});

export const commentsRelations = relations(comments, ({ one }) => ({
  author: one(users, {
    fields: [comments.authorId],
    references: [users.id],
  }),
  post: one(posts, {
    fields: [comments.postId],
    references: [posts.id],
  }),
}));
Les relations Drizzle sont purement pour l'API de requête et ne créent pas de contraintes de clé étrangère dans la base de données. La clé étrangère réelle est définie dans la définition de table à l'aide de .references(). Si vous définissez une relation dans relations() mais oubliez le .references() dans la table, la requête relationnelle fonctionnera mais la base de données n'appliquera pas l'intégrité référentielle.
Migrations avec drizzle-kit
drizzle-kit génère des fichiers de migration SQL en comparant votre définition de schéma avec l'état actuel de la base de données.
Génération de Migrations
npx drizzle-kit generate
Cela crée un fichier de migration SQL dans le répertoire drizzle/ (comme configuré dans drizzle.config.ts) :
-- drizzle/0000_initial_migration.sql
CREATE TYPE "user_role" AS ENUM('admin', 'member', 'viewer');

CREATE TABLE "users" (
  "id" uuid PRIMARY KEY DEFAULT gen_random_uuid() NOT NULL,
  "email" varchar(255) NOT NULL,
  "name" varchar(100),
  "role" "user_role" DEFAULT 'member' NOT NULL,
  "avatar_url" text,
  "created_at" timestamp DEFAULT now() NOT NULL,
  "updated_at" timestamp DEFAULT now() NOT NULL,
  CONSTRAINT "users_email_unique" UNIQUE("email")
);

CREATE TABLE "posts" (
  "id" uuid PRIMARY KEY DEFAULT gen_random_uuid() NOT NULL,
  "title" varchar(200) NOT NULL,
  "content" text,
  "published" boolean DEFAULT false NOT NULL,
  "view_count" integer DEFAULT 0 NOT NULL,
  "author_id" uuid,
  "created_at" timestamp DEFAULT now() NOT NULL,
  "updated_at" timestamp DEFAULT now() NOT NULL
);

ALTER TABLE "posts" ADD COLUMN "author_id" uuid REFERENCES "users"("id") ON DELETE CASCADE;
Application des Migrations
npx drizzle-kit migrate
Cela applique tous les fichiers de migration en attente à votre base de données dans l'ordre.
Utilisez npx drizzle-kit generate après chaque changement de schéma, puis examinez le SQL généré avant d'exécuter migrate. La génération de migrations de Drizzle est excellente mais pas parfaite -- vérifiez toujours que le SQL correspond à votre intention, en particulier pour les opérations complexes comme les renommages de colonnes ou les changements de type.
Poussée Directe des Changements de Schéma
Pour le prototypage rapide, vous pouvez pousser les changements de schéma directement vers la base de données sans générer de fichiers de migration :
npx drizzle-kit push
Cela synchronise votre schéma avec la base de données immédiatement.
drizzle-kit push contourne les fichiers de migration et applique les changements directement. C'est idéal pour le développement mais ne doit jamais être utilisé en production. Utilisez toujours generate + migrate pour les déploiements en production afin de maintenir un historique de migration versionné.
Journal de Migration
drizzle-kit maintient un fichier meta/_journal.json qui suit les migrations appliquées :
[
  {
    "version": "5",
    "idx": 0,
    "when": 1700000000000,
    "tag": "initial_migration",
    "breakpoints": true
  }
]
Requêtes Type-Safe
Le constructeur de requêtes de Drizzle est entièrement typé. Chaque requête que vous écrivez est vérifiée au moment de la compilation, et l'IntelliSense de Cursor fournit l'autocomplétion pour les noms de tables, les colonnes et les opérateurs.
Requêtes SELECT
import { eq, and, gte, lte, desc, asc, sql } from 'drizzle-orm';
import { db } from './client';
import { users, posts, profiles } from './schema';

// Select specific columns
const userEmails = await db
  .select({ id: users.id, email: users.email, name: users.name })
  .from(users);

// Select with filtering
const publishedPosts = await db
  .select()
  .from(posts)
  .where(eq(posts.published, true))
  .orderBy(desc(posts.createdAt))
  .limit(10);

// Select with multiple conditions
const recentPosts = await db
  .select()
  .from(posts)
  .where(
    and(
      eq(posts.published, true),
      gte(posts.createdAt, new Date('2024-01-01')),
      lte(posts.createdAt, new Date('2024-12-31'))
    )
  )
  .orderBy(desc(posts.viewCount), asc(posts.createdAt));
JOINs
// Inner join: posts with their authors
const postsWithAuthors = await db
  .select({
    postId: posts.id,
    title: posts.title,
    authorName: users.name,
    authorEmail: users.email,
  })
  .from(posts)
  .innerJoin(users, eq(posts.authorId, users.id))
  .where(eq(posts.published, true));

// Left join: users with optional profiles
const usersWithProfiles = await db
  .select({
    userId: users.id,
    email: users.email,
    bio: profiles.bio,
  })
  .from(users)
  .leftJoin(profiles, eq(users.id, profiles.userId));
Requêtes INSERT
// Insert a single record
const [newUser] = await db
.insert(users)
.values({
name: 'New User',
role: 'member',
})
.returning();
// Insert multiple records
const newPosts = await db
.insert(posts)
.values([
{ title: 'Post 1', content: 'Content 1', authorId: userId },
{ title: 'Post 2', content: 'Content 2', authorId: userId },
])
.returning({ id: posts.id, title: posts.title });
// Insert with conflict handling (upsert)
const [upsertedUser] = await db
.insert(users)
.onConflictDoUpdate({
target: users.email,
set: { name: 'Updated Name', updatedAt: new Date() },
})
.returning();
Demandez à Cursor : "Écris une requête upsert Drizzle qui insère un nouvel utilisateur si l'email n'existe pas, ou met à jour le nom et avatarUrl s'il existe. Retourne l'enregistrement inséré/mis à jour." Cursor générera la syntaxe onConflictDoUpdate correctement.
UPDATE et DELETE
// Update records
const [updatedPost] = await db
  .update(posts)
  .set({ title: 'Updated Title', viewCount: sql`${posts.viewCount} + 1` })
  .where(eq(posts.id, postId))
  .returning();

// Delete records
await db.delete(posts).where(eq(posts.authorId, deletedUserId));

// Delete with condition
const deletedCount = await db
  .delete(posts)
  .where(and(eq(posts.published, false), lt(posts.createdAt, thirtyDaysAgo)))
  .returning();
API de Requête Relationnelle
L'API de requête relationnelle de Drizzle fournit un moyen déclaratif de récupérer des données imbriquées :
// Fetch a user with their profile and posts
const userWithData = await db.query.users.findFirst({
with: {
profile: true,
posts: {
where: eq(posts.published, true),
orderBy: desc(posts.createdAt),
limit: 5,
with: {
comments: {
with: {
author: {
columns: { id: true, name: true, avatarUrl: true },
},
},
},
},
},
},
});
// Fetch all published posts with author and comments
const allPosts = await db.query.posts.findMany({
where: eq(posts.published, true),
orderBy: desc(posts.createdAt),
limit: 20,
with: {
author: {
columns: { id: true, name: true, email: true },
},
comments: {
orderBy: desc(comments.createdAt),
with: {
author: true,
},
},
},
});
L'API de requête relationnelle (db.query.*) nécessite que vous transmettiez votre schéma au constructeur drizzle() : drizzle(pool, { schema }). Sans le schéma, l'espace de noms db.query sera indéfini et toutes les requêtes relationnelles lanceront une erreur d'exécution.
Agrégations et GROUP BY
import { count, sql } from 'drizzle-orm';

// Count posts per author
const postCounts = await db
  .select({
    authorId: posts.authorId,
    authorName: users.name,
    postCount: count(posts.id),
  })
  .from(posts)
  .innerJoin(users, eq(posts.authorId, users.id))
  .where(eq(posts.published, true))
  .groupBy(posts.authorId, users.name)
  .orderBy(desc(count(posts.id)))
  .limit(5);

// Sum and average
const stats = await db
  .select({
    totalViews: sql<number>`sum(${posts.viewCount})`,
    avgViews: sql<number>`avg(${posts.viewCount})`,
    postCount: count(posts.id),
  })
  .from(posts)
  .where(eq(posts.published, true));
Transactions
Drizzle prend en charge les transactions basées sur callback et basées sur des instructions :
// Callback-based transaction
const result = await db.transaction(async (tx) => {
const [newUser] = await tx
.insert(users)
.returning();
const [newPost] = await tx
.insert(posts)
.values({
title: 'First Post',
content: 'Hello',
authorId: newUser.id,
published: true,
})
.returning();
await tx
.insert(profiles)
.values({ bio: 'Author bio', userId: newUser.id })
.returning();
return { user: newUser, post: newPost };
});
Demandez à Cursor : "Écris une transaction Drizzle qui crée un utilisateur, l'assigne à un workspace en tant que membre, et crée un projet par défaut. Annule en cas d'erreur." Cursor générera la transaction basée sur callback avec une propagation d'erreur appropriée.
Construction de Requêtes Assistée par IA dans Cursor
L'assistant IA de Cursor peut générer des requêtes Drizzle complexes, des définitions de schéma et des stratégies de migration à partir de descriptions en langage naturel.
Génération de Requêtes à partir de Prompts
Ouvrez Cursor Chat (Ctrl+L) et décrivez ce dont vous avez besoin :
Write a Drizzle ORM query to fetch the top 10 most-viewed published posts
from the last 30 days, including each post's author name and email, the
count of comments, and the count of likes. Order by view count descending.
Use the relational query API (db.query.posts.findMany).
const thirtyDaysAgo = new Date();
thirtyDaysAgo.setDate(thirtyDaysAgo.getDate() - 30);

const topPosts = await db.query.posts.findMany({
  where: and(
    eq(posts.published, true),
    gte(posts.createdAt, thirtyDaysAgo)
  ),
  orderBy: desc(posts.viewCount),
  limit: 10,
  with: {
    author: {
      columns: { id: true, name: true, email: true },
    },
  },
  extras: {
    commentCount: sql<number>`(
      SELECT count(*) FROM comments WHERE comments.post_id = posts.id
    )`.as('commentCount'),
    likeCount: sql<number>`(
      SELECT count(*) FROM likes WHERE likes.post_id = posts.id
    )`.as('likeCount'),
  },
});
Lorsque vous demandez à Cursor de générer des requêtes Drizzle, spécifiez si vous souhaitez l'API de constructeur de requêtes (db.select().from()) ou l'API de requête relationnelle (db.query.*.findMany()). Les deux API ont une syntaxe et des compromis différents -- le constructeur de requêtes vous donne plus de contrôle SQL tandis que l'API relationnelle est plus déclarative.
Génération de Schémas à partir de Descriptions
Generate a Drizzle schema for a multi-tenant SaaS application using
PostgreSQL. Include: Tenant, User (with tenantId), Subscription (with
plan enum: FREE/PRO/ENTERPRISE), ApiKey, and Webhook table. Use UUIDs,
timestamps, proper foreign keys with cascade delete, and add indexes on
tenantId columns.
Migration de Schéma Assistée par IA
Lors du refactor de votre schéma, demandez de l'aide à Cursor :
I need to add a "soft delete" feature to my Drizzle schema. Add a
"deleted_at" timestamp column to the posts and comments tables that is
nullable. Then update my existing queries to filter out soft-deleted
records by default. Show me how to generate the migration.
Cursor va :
- Ajouter la colonne
deletedAtaux deux tables. - Mettre à jour les requêtes SELECT pour ajouter des filtres
isNull(posts.deletedAt). - Générer la commande de migration drizzle-kit.
Lors de l'ajout de colonnes de suppression douce, les requêtes existantes qui ne filtrent pas par deletedAt renverront les enregistrements supprimés en douce. Demandez à Cursor d'auditer toutes vos requêtes après le changement de schéma pour s'assurer qu'aucune ne laisse fuir de données supprimées en douce.
Performance et Bonnes Pratiques
Stratégie d'Indexation
import { index } from 'drizzle-orm/pg-core';

export const posts = pgTable(
  'posts',
  {
    id: uuid('id').defaultRandom().primaryKey(),
    title: varchar('title', { length: 200 }).notNull(),
    authorId: uuid('author_id').references(() => users.id),
    published: boolean('published').default(false).notNull(),
    createdAt: timestamp('created_at').defaultNow().notNull(),
  },
  (table) => ({
    authorIdx: index('posts_author_id_idx').on(table.authorId),
    publishedIdx: index('posts_published_created_idx').on(
      table.published,
      table.createdAt
    ),
  })
);
Pool de Connexions
import { Pool } from 'pg';
import { drizzle } from 'drizzle-orm/node-postgres';

const pool = new Pool({
  connectionString: process.env.DATABASE_URL!,
  max: 20,
  idleTimeoutMillis: 30000,
  connectionTimeoutMillis: 2000,
});

export const db = drizzle(pool, { schema, logger: true });
Dans les environnements serverless (Vercel, AWS Lambda), utilisez un pooler de connexions comme PgBouncer ou un driver serverless comme @neondatabase/serverless. Les connexions PostgreSQL directes ne passent pas bien à l'échelle en serverless car chaque instance de fonction crée son propre pool, épuisant la limite de connexions de la base de données.
Requêtes Préparées
import { sql } from 'drizzle-orm';

const findPostsByAuthor = db
  .select()
  .from(posts)
  .where(and(eq(posts.authorId, sql.placeholder('authorId')), eq(posts.published, true)))
  .prepare('findPostsByAuthor');

const result = await findPostsByAuthor.execute({ authorId: userId });
Conclusion
Drizzle ORM associé à Cursor crée une expérience de développement de base de données puissante et type-safe. La définition de schéma native TypeScript vous donne un contrôle SQL complet tandis que le serveur de langage de Cursor intercepte les erreurs de type en temps réel. drizzle-kit fournit un flux de migration fiable avec les commandes generate et migrate pour la production, et push pour le prototypage rapide. La double API de requête -- style constructeur db.select().from() et déclaratif db.query.*.findMany() -- vous permet de choisir le bon niveau d'abstraction pour chaque requête. L'assistant IA de Cursor accélère chaque étape, de la génération de schémas complets pour des domaines complexes à l'écriture de requêtes optimisées avec des JOINs, des agrégations et des transactions. Commencez par définir votre schéma en TypeScript, configurez drizzle-kit, utilisez generate et migrate pour l'évolution du schéma, et laissez Cursor construire les requêtes type-safe afin que vous puissiez vous concentrer sur la logique de votre application.