Drizzle ORM-Entwicklung in Cursor: Ein vollständiger Leitfaden
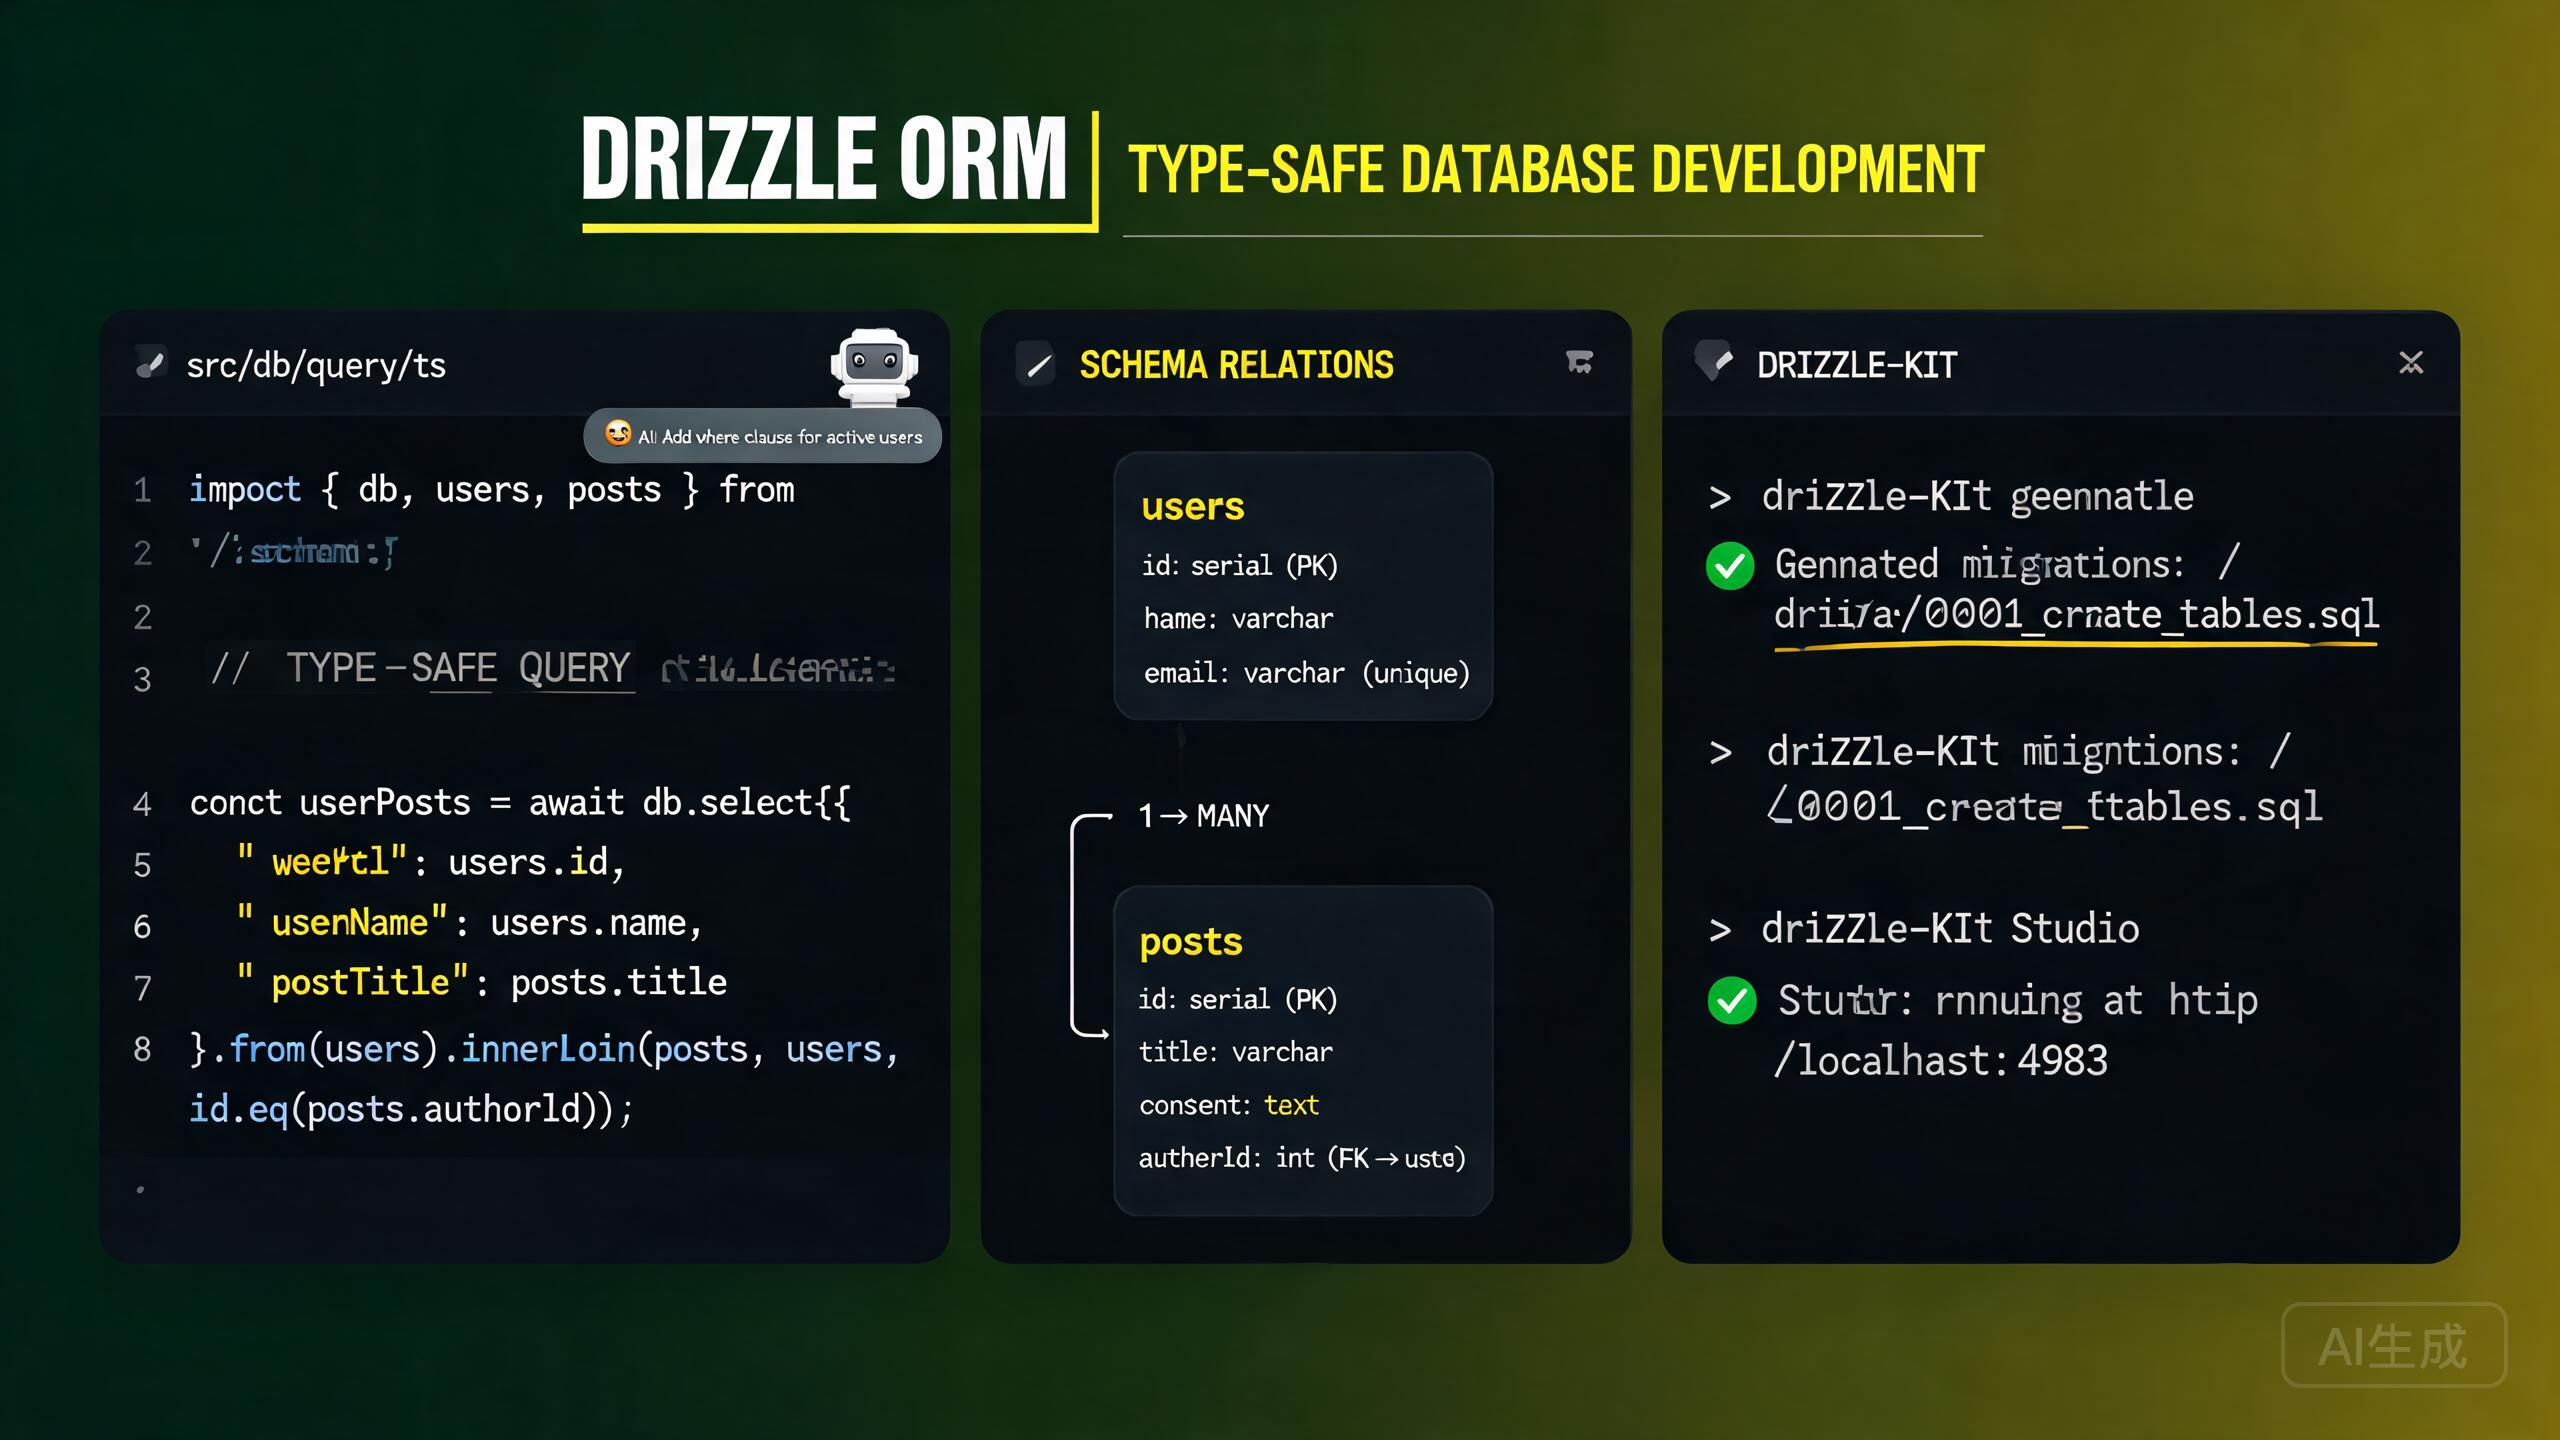
Drizzle ORM ist ein leichtgewichtiges, TypeScript-zuerst-ORM, das typsichere SQL-Abfragen ohne den Overhead einer schweren Laufzeit bietet. Im Gegensatz zu traditionellen ORMs gibt Drizzle Ihnen volle SQL-Kontrolle bei gleichzeitiger vollständiger Typsicherheit zur Kompilierzeit. Drizzle unterstützt PostgreSQL, MySQL und SQLite mit einer einheitlichen API-Oberfläche. Cursor ist mit seinem integrierten KI-Assistenten und dem eingebauten TypeScript-Language-Server ein idealer Editor für die Drizzle-Entwicklung -- er bietet vollständiges IntelliSense für Schema-Definitionen, auto-vervollständigt Query-Builder und kann vollständige Schemata und Abfragen aus natürlichsprachlichen Beschreibungen generieren.
Dieser Leitfaden behandelt den vollständigen Drizzle-Entwicklungs-Workflow in Cursor: Installation und Einrichtung, Schema-Definition, Migrationen mit drizzle-kit, typsichere Abfragen, Relationen und KI-gestütztes Query-Building.
Installation und Einrichtung von Drizzle in Cursor
Voraussetzungen
Drizzle erfordert Node.js 18 oder neuer und funktioniert mit PostgreSQL, MySQL oder SQLite. Überprüfen Sie Ihre Node.js-Version:
node --version
Der eingebaute TypeScript-Language-Server von Cursor bietet Echtzeit-Typprüfung für Drizzle-Schemata und Abfragen. Sie sehen Typfehler inline, bevor Sie Ihren Code überhaupt ausführen, was besonders wertvoll für Drizzles stark typisierte Query-Builder ist.
Abhängigkeiten installieren
Installieren Sie Drizzle ORM und das drizzle-kit CLI-Tool:
# Für PostgreSQL
npm install drizzle-orm pg
npm install drizzle-kit --save-dev

# Für MySQL
npm install drizzle-orm mysql2
npm install drizzle-kit --save-dev

# Für SQLite (better-sqlite3)
npm install drizzle-orm better-sqlite3
npm install drizzle-kit --save-dev

# Für SQLite (libSQL/Turso)
npm install drizzle-orm @libsql/client
npm install drizzle-kit --save-dev
Setzen Sie Ihren Datenbank-Verbindungsstring in .env:
# .env
DATABASE_URL="postgresql://user:password@localhost:5432/mydb"
Konfigurieren von drizzle-kit
Erstellen Sie eine drizzle.config.ts-Datei in Ihrem Projektstammverzeichnis:
// drizzle.config.ts
import { defineConfig } from 'drizzle-kit';

export default defineConfig({
  schema: './src/db/schema.ts',
  out: './drizzle',
  dialect: 'postgresql',
  dbCredentials: {
    url: process.env.DATABASE_URL!,
  },
  verbose: true,
  strict: true,
});
Wenn Sie MySQL verwenden, setzen Sie dialect: 'mysql' in der Konfiguration. Wenn Sie SQLite verwenden, setzen Sie dialect: 'sqlite'. Das Feld dialect bestimmt, welchen SQL-Dialekt drizzle-kit für Migrationen generiert. Ein falscher Dialekt erzeugt Migrationsdateien, die auf Ihrer Datenbank fehlschlagen.
Erstellen des Datenbank-Clients
// src/db/client.ts
import { drizzle } from 'drizzle-orm/node-postgres';
import { Pool } from 'pg';
import * as schema from './schema';

const pool = new Pool({
  connectionString: process.env.DATABASE_URL!,
});

export const db = drizzle(pool, { schema });
export type DB = typeof db;
Importieren und übergeben Sie immer Ihr Schema-Objekt an den drizzle()-Konstruktor. Dies aktiviert die relationale Query-API (db.query.users.findMany()), die verschachtelten Datenabruf mit vollständiger Typsicherheit bietet.
Schema-Definition
Drizzle-Schemata werden in TypeScript-Dateien mit Builder-Funktionen definiert. Jede Funktion entspricht einem SQL-Spaltentyp.
Tabellen definieren
// src/db/schema.ts
import {
  pgTable,
  uuid,
  varchar,
  text,
  boolean,
  integer,
  timestamp,
  enum,
  pgEnum,
} from 'drizzle-orm/pg-core';
import { relations } from 'drizzle-orm';

// Enums
export const userRoleEnum = pgEnum('user_role', ['admin', 'member', 'viewer']);

// Users-Tabelle
export const users = pgTable('users', {
  id: uuid('id').defaultRandom().primaryKey(),
  email: varchar('email', { length: 255 }).notNull().unique(),
  name: varchar('name', { length: 100 }),
  role: userRoleEnum('role').default('member').notNull(),
  avatarUrl: text('avatar_url'),
  createdAt: timestamp('created_at').defaultNow().notNull(),
  updatedAt: timestamp('updated_at').defaultNow().notNull(),
});

// Posts-Tabelle
export const posts = pgTable('posts', {
  id: uuid('id').defaultRandom().primaryKey(),
  title: varchar('title', { length: 200 }).notNull(),
  content: text('content'),
  published: boolean('published').default(false).notNull(),
  viewCount: integer('view_count').default(0).notNull(),
  authorId: uuid('author_id').references(() => users.id, { onDelete: 'cascade' }),
  createdAt: timestamp('created_at').defaultNow().notNull(),
  updatedAt: timestamp('updated_at').defaultNow().notNull(),
});

// Profiles-Tabelle
export const profiles = pgTable('profiles', {
  id: uuid('id').defaultRandom().primaryKey(),
  bio: text('bio'),
  userId: uuid('user_id').references(() => users.id, { onDelete: 'cascade' }).unique(),
  createdAt: timestamp('created_at').defaultNow().notNull(),
});
Häufige Spaltentypen (PostgreSQL)
| Drizzle-Funktion | SQL-Typ | Hinweise |
|---|---|---|
uuid() | UUID | .defaultRandom() für automatische Generierung verwenden |
varchar({ length: n }) | VARCHAR(n) | Zeichenfolge variabler Länge |
text() | TEXT | Zeichenfolge unbegrenzter Länge |
integer() | INTEGER | 32-Bit-Ganzzahl |
boolean() | BOOLEAN | Wahr/falsch |
timestamp() | TIMESTAMP | .defaultNow() für automatisches Ausfüllen verwenden |
jsonb() | JSONB | Strukturierte Daten |
serial() | SERIAL | Auto-inkrementierende Ganzzahl |
pgEnum() | ENUM | PostgreSQL-Enum-Typ |
decimal() | DECIMAL | Festkommazahl |
Fragen Sie Cursor: "Generieren Sie ein Drizzle-Schema für PostgreSQL mit User-, Post-, Comment- und Tag-Modellen. Verwenden Sie UUID-Primärschlüssel, schließen Sie Zeitstempel ein und richten Sie 1:n- und m:n-Relationen ein." Cursor wird ein validiertes TypeScript-Schema mit korrekten Importen und Relationsdefinitionen erzeugen.
Relationen definieren
Drizzle-Relationen werden separat von Tabellen mit der Funktion relations() definiert. Sie beeinflussen das Datenbankschema nicht -- sie konfigurieren nur die relationale Query-API:
// src/db/schema.ts (Fortsetzung)
import { relations } from 'drizzle-orm';

export const usersRelations = relations(users, ({ one, many }) => ({
  profile: one(profiles, {
    fields: [users.id],
    references: [profiles.userId],
  }),
  posts: many(posts),
}));

export const postsRelations = relations(posts, ({ one, many }) => ({
  author: one(users, {
    fields: [posts.authorId],
    references: [users.id],
  }),
  comments: many(comments),
}));

export const profilesRelations = relations(profiles, ({ one }) => ({
  user: one(users, {
    fields: [profiles.userId],
    references: [users.id],
  }),
}));

export const comments = pgTable('comments', {
  id: uuid('id').defaultRandom().primaryKey(),
  content: text('content').notNull(),
  authorId: uuid('author_id').references(() => users.id, { onDelete: 'cascade' }),
  postId: uuid('post_id').references(() => posts.id, { onDelete: 'cascade' }),
  createdAt: timestamp('created_at').defaultNow().notNull(),
});

export const commentsRelations = relations(comments, ({ one }) => ({
  author: one(users, {
    fields: [comments.authorId],
    references: [users.id],
  }),
  post: one(posts, {
    fields: [comments.postId],
    references: [posts.id],
  }),
}));
Drizzle-Relationen dienen ausschließlich der Query-API und erstellen keine Fremdschlüssel-Einschränkungen in der Datenbank. Der tatsächliche Fremdschlüssel wird in der Tabellendefinition mit .references() definiert. Wenn Sie eine Relation in relations() definieren, aber .references() in der Tabelle vergessen, funktioniert die relationale Abfrage, aber die Datenbank wird die referenzielle Integrität nicht erzwingen.
Migrationen mit drizzle-kit
drizzle-kit generiert SQL-Migrationsdateien durch den Vergleich Ihrer Schema-Definition mit dem aktuellen Datenbankzustand.
Migrationen generieren
npx drizzle-kit generate
Dies erstellt eine SQL-Migrationsdatei im Verzeichnis drizzle/ (wie in drizzle.config.ts konfiguriert):
-- drizzle/0000_initial_migration.sql
CREATE TYPE "user_role" AS ENUM('admin', 'member', 'viewer');

CREATE TABLE "users" (
  "id" uuid PRIMARY KEY DEFAULT gen_random_uuid() NOT NULL,
  "email" varchar(255) NOT NULL,
  "name" varchar(100),
  "role" "user_role" DEFAULT 'member' NOT NULL,
  "avatar_url" text,
  "created_at" timestamp DEFAULT now() NOT NULL,
  "updated_at" timestamp DEFAULT now() NOT NULL,
  CONSTRAINT "users_email_unique" UNIQUE("email")
);

CREATE TABLE "posts" (
  "id" uuid PRIMARY KEY DEFAULT gen_random_uuid() NOT NULL,
  "title" varchar(200) NOT NULL,
  "content" text,
  "published" boolean DEFAULT false NOT NULL,
  "view_count" integer DEFAULT 0 NOT NULL,
  "author_id" uuid,
  "created_at" timestamp DEFAULT now() NOT NULL,
  "updated_at" timestamp DEFAULT now() NOT NULL
);

ALTER TABLE "posts" ADD COLUMN "author_id" uuid REFERENCES "users"("id") ON DELETE CASCADE;
Migrationen anwenden
npx drizzle-kit migrate
Dies wendet alle ausstehenden Migrationsdateien in der richtigen Reihenfolge auf Ihre Datenbank an.
Verwenden Sie npx drizzle-kit generate nach jeder Schemaänderung und überprüfen Sie dann das generierte SQL, bevor Sie migrate ausführen. Drizzles Migrationsgenerierung ist hervorragend, aber nicht perfekt -- überprüfen Sie immer, ob das SQL Ihrer Absicht entspricht, besonders bei komplexen Operationen wie Spaltenumbenennungen oder Typänderungen.
Schemaänderungen direkt übertragen
Für schnelles Prototyping können Sie Schemaänderungen direkt an die Datenbank übertragen, ohne Migrationsdateien zu generieren:
npx drizzle-kit push
Dies synchronisiert Ihr Schema sofort mit der Datenbank.
drizzle-kit push umgeht Migrationsdateien und wendet Änderungen direkt an. Dies ist großartig für die Entwicklung, sollte aber niemals in der Produktion verwendet werden. Verwenden Sie für Produktions-Deployments immer generate + migrate, um eine versionierte Migrationshistorie zu pflegen.
Migrations-Journal
drizzle-kit verwaltet eine meta/_journal.json-Datei, die angewendete Migrationen verfolgt:
[
  {
    "version": "5",
    "idx": 0,
    "when": 1700000000000,
    "tag": "initial_migration",
    "breakpoints": true
  }
]
Typsichere Abfragen
Drizzles Query-Builder ist vollständig typisiert. Jede Abfrage, die Sie schreiben, wird zur Kompilierzeit geprüft, und Cursors IntelliSense bietet Autovervollständigung für Tabellennamen, Spalten und Operatoren.
Select-Abfragen
import { eq, and, gte, lte, desc, asc, sql } from 'drizzle-orm';
import { db } from './client';
import { users, posts, profiles } from './schema';

// Bestimmte Spalten auswählen
const userEmails = await db
  .select({ id: users.id, email: users.email, name: users.name })
  .from(users);

// Select mit Filterung
const publishedPosts = await db
  .select()
  .from(posts)
  .where(eq(posts.published, true))
  .orderBy(desc(posts.createdAt))
  .limit(10);

// Select mit mehreren Bedingungen
const recentPosts = await db
  .select()
  .from(posts)
  .where(
    and(
      eq(posts.published, true),
      gte(posts.createdAt, new Date('2024-01-01')),
      lte(posts.createdAt, new Date('2024-12-31'))
    )
  )
  .orderBy(desc(posts.viewCount), asc(posts.createdAt));
Joins
// Inner Join: Beiträge mit ihren Autoren
const postsWithAuthors = await db
  .select({
    postId: posts.id,
    title: posts.title,
    authorName: users.name,
    authorEmail: users.email,
  })
  .from(posts)
  .innerJoin(users, eq(posts.authorId, users.id))
  .where(eq(posts.published, true));

// Left Join: Benutzer mit optionalen Profilen
const usersWithProfiles = await db
  .select({
    userId: users.id,
    email: users.email,
    bio: profiles.bio,
  })
  .from(users)
  .leftJoin(profiles, eq(users.id, profiles.userId));
Insert-Abfragen
// Einzelnen Datensatz einfügen
const [newUser] = await db
.insert(users)
.values({
name: 'New User',
role: 'member',
})
.returning();
// Mehrere Datensätze einfügen
const newPosts = await db
.insert(posts)
.values([
{ title: 'Post 1', content: 'Content 1', authorId: userId },
{ title: 'Post 2', content: 'Content 2', authorId: userId },
])
.returning({ id: posts.id, title: posts.title });
// Insert mit Konfliktbehandlung (Upsert)
const [upsertedUser] = await db
.insert(users)
.onConflictDoUpdate({
target: users.email,
set: { name: 'Updated Name', updatedAt: new Date() },
})
.returning();
Fragen Sie Cursor: "Schreiben Sie eine Drizzle-Upsert-Abfrage, die einen neuen Benutzer einfügt, wenn die E-Mail nicht existiert, oder Name und avatarUrl aktualisiert, wenn sie existiert. Geben Sie den eingefügten/aktualisierten Datensatz zurück." Cursor wird die onConflictDoUpdate-Syntax korrekt generieren.
Update und Delete
// Datensätze aktualisieren
const [updatedPost] = await db
  .update(posts)
  .set({ title: 'Updated Title', viewCount: sql`${posts.viewCount} + 1` })
  .where(eq(posts.id, postId))
  .returning();

// Datensätze löschen
await db.delete(posts).where(eq(posts.authorId, deletedUserId));

// Löschen mit Bedingung
const deletedCount = await db
  .delete(posts)
  .where(and(eq(posts.published, false), lt(posts.createdAt, thirtyDaysAgo)))
  .returning();
Relationale Query-API
Drizzles relationale Query-API bietet eine deklarative Möglichkeit, verschachtelte Daten abzurufen:
// Benutzer mit Profil und Beiträgen abrufen
const userWithData = await db.query.users.findFirst({
with: {
profile: true,
posts: {
where: eq(posts.published, true),
orderBy: desc(posts.createdAt),
limit: 5,
with: {
comments: {
with: {
author: {
columns: { id: true, name: true, avatarUrl: true },
},
},
},
},
},
},
});
// Alle veröffentlichten Beiträge mit Autor und Kommentaren abrufen
const allPosts = await db.query.posts.findMany({
where: eq(posts.published, true),
orderBy: desc(posts.createdAt),
limit: 20,
with: {
author: {
columns: { id: true, name: true, email: true },
},
comments: {
orderBy: desc(comments.createdAt),
with: {
author: true,
},
},
},
});
Die relationale Query-API (db.query.*) erfordert, dass Sie Ihr Schema an den drizzle()-Konstruktor übergeben: drizzle(pool, { schema }). Ohne das Schema ist der db.query-Namespace undefiniert und alle relationalen Abfragen werden einen Laufzeitfehler auslösen.
Aggregationen und Group By
import { count, sql } from 'drizzle-orm';

// Beiträge pro Autor zählen
const postCounts = await db
  .select({
    authorId: posts.authorId,
    authorName: users.name,
    postCount: count(posts.id),
  })
  .from(posts)
  .innerJoin(users, eq(posts.authorId, users.id))
  .where(eq(posts.published, true))
  .groupBy(posts.authorId, users.name)
  .orderBy(desc(count(posts.id)))
  .limit(5);

// Summe und Durchschnitt
const stats = await db
  .select({
    totalViews: sql<number>`sum(${posts.viewCount})`,
    avgViews: sql<number>`avg(${posts.viewCount})`,
    postCount: count(posts.id),
  })
  .from(posts)
  .where(eq(posts.published, true));
Transaktionen
Drizzle unterstützt sowohl Callback-basierte als auch Anweisungs-basierte Transaktionen:
// Callback-basierte Transaktion
const result = await db.transaction(async (tx) => {
const [newUser] = await tx
.insert(users)
.returning();
const [newPost] = await tx
.insert(posts)
.values({
title: 'First Post',
content: 'Hello',
authorId: newUser.id,
published: true,
})
.returning();
await tx
.insert(profiles)
.values({ bio: 'Author bio', userId: newUser.id })
.returning();
return { user: newUser, post: newPost };
});
Fragen Sie Cursor: "Schreiben Sie eine Drizzle-Transaktion, die einen Benutzer erstellt, ihn als Mitglied einem Workspace zuweist und ein Standard-Projekt erstellt. Führen Sie bei jedem Fehler ein Rollback durch." Cursor wird die Callback-basierte Transaktion mit ordnungsgemäßer Fehlerweitergabe generieren.
KI-gestütztes Query-Building in Cursor
Der KI-Assistent von Cursor kann komplexe Drizzle-Abfragen, Schema-Definitionen und Migrationsstrategien aus natürlichsprachlichen Beschreibungen generieren.
Abfragen aus Prompts generieren
Öffnen Sie Cursor Chat (Ctrl+L) und beschreiben Sie, was Sie benötigen:
Write a Drizzle ORM query to fetch the top 10 most-viewed published posts
from the last 30 days, including each post's author name and email, the
count of comments, and the count of likes. Order by view count descending.
Use the relational query API (db.query.posts.findMany).
const thirtyDaysAgo = new Date();
thirtyDaysAgo.setDate(thirtyDaysAgo.getDate() - 30);

const topPosts = await db.query.posts.findMany({
  where: and(
    eq(posts.published, true),
    gte(posts.createdAt, thirtyDaysAgo)
  ),
  orderBy: desc(posts.viewCount),
  limit: 10,
  with: {
    author: {
      columns: { id: true, name: true, email: true },
    },
  },
  extras: {
    commentCount: sql<number>`(
      SELECT count(*) FROM comments WHERE comments.post_id = posts.id
    )`.as('commentCount'),
    likeCount: sql<number>`(
      SELECT count(*) FROM likes WHERE likes.post_id = posts.id
    )`.as('likeCount'),
  },
});
Wenn Sie Cursor bitten, Drizzle-Abfragen zu generieren, geben Sie an, ob Sie die Query-Builder-API (db.select().from()) oder die relationale Query-API (db.query.*.findMany()) möchten. Beide APIs haben unterschiedliche Syntax und Kompromisse -- der Query-Builder gibt Ihnen mehr SQL-Kontrolle, während die relationale API deklarativer ist.
Schemata aus Beschreibungen generieren
Generate a Drizzle schema for a multi-tenant SaaS application using
PostgreSQL. Include: Tenant, User (with tenantId), Subscription (with
plan enum: FREE/PRO/ENTERPRISE), ApiKey, and Webhook table. Use UUIDs,
timestamps, proper foreign keys with cascade delete, and add indexes on
tenantId columns.
KI-gestützte Schema-Migration
Wenn Sie Ihr Schema refactoren, bitten Sie Cursor um Hilfe:
I need to add a "soft delete" feature to my Drizzle schema. Add a
"deleted_at" timestamp column to the posts and comments tables that is
nullable. Then update my existing queries to filter out soft-deleted
records by default. Show me how to generate the migration.
Cursor wird:
- Die
deletedAt-Spalte zu beiden Tabellen hinzufügen. - Select-Abfragen aktualisieren, um
isNull(posts.deletedAt)-Filter hinzuzufügen. - Den drizzle-kit-Migrationsbefehl generieren.
Beim Hinzufügen von Soft-Delete-Spalten werden vorhandene Abfragen, die nicht nach deletedAt filtern, als gelöscht markierte Datensätze zurückgeben. Bitten Sie Cursor, alle Ihre Abfragen nach der Schemaänderung zu auditieren, um sicherzustellen, dass keine als gelöscht markierten Daten durchsickern.
Leistung und Best Practices
Indexierungs-Strategie
import { index } from 'drizzle-orm/pg-core';

export const posts = pgTable(
  'posts',
  {
    id: uuid('id').defaultRandom().primaryKey(),
    title: varchar('title', { length: 200 }).notNull(),
    authorId: uuid('author_id').references(() => users.id),
    published: boolean('published').default(false).notNull(),
    createdAt: timestamp('created_at').defaultNow().notNull(),
  },
  (table) => ({
    authorIdx: index('posts_author_id_idx').on(table.authorId),
    publishedIdx: index('posts_published_created_idx').on(
      table.published,
      table.createdAt
    ),
  })
);
Verbindungspooling
import { Pool } from 'pg';
import { drizzle } from 'drizzle-orm/node-postgres';

const pool = new Pool({
  connectionString: process.env.DATABASE_URL!,
  max: 20,
  idleTimeoutMillis: 30000,
  connectionTimeoutMillis: 2000,
});

export const db = drizzle(pool, { schema, logger: true });
In Serverless-Umgebungen (Vercel, AWS Lambda) verwenden Sie einen Connection Pooler wie PgBouncer oder einen Serverless-Treiber wie @neondatabase/serverless. Direkte PostgreSQL-Verbindungen skalieren in Serverless-Umgebungen nicht gut, da jede Funktionsinstanz ihren eigenen Pool erstellt und das Verbindungslimit der Datenbank erschöpft.
Prepared Statements
import { sql } from 'drizzle-orm';

const findPostsByAuthor = db
  .select()
  .from(posts)
  .where(and(eq(posts.authorId, sql.placeholder('authorId')), eq(posts.published, true)))
  .prepare('findPostsByAuthor');

const result = await findPostsByAuthor.execute({ authorId: userId });
Fazit
Drizzle ORM in Kombination mit Cursor schafft ein leistungsstarkes, typsicheres Datenbank-Entwicklungserlebnis. Die TypeScript-native Schema-Definition gibt Ihnen volle SQL-Kontrolle, während Cursors Language-Server Typfehler in Echtzeit erkennt. drizzle-kit bietet einen zuverlässigen Migrations-Workflow mit generate- und migrate-Befehlen für die Produktion und push für schnelles Prototyping. Die duale Query-API -- Builder-Stil db.select().from() und deklarativ db.query.*.findMany() -- lässt Sie den richtigen Abstraktionsgrad für jede Abfrage wählen. Der KI-Assistent von Cursor beschleunigt jeden Schritt, von der Generierung vollständiger Schemata für komplexe Domänen bis zum Schreiben optimierter Abfragen mit Joins, Aggregationen und Transaktionen. Beginnen Sie mit der Definition Ihres Schemas in TypeScript, konfigurieren Sie drizzle-kit, verwenden Sie generate und migrate für die Schema-Evolution, und lassen Sie Cursor die typsicheren Abfragen erstellen, damit Sie sich auf Ihre Anwendungslogik konzentrieren können.