Desenvolvimento com Drizzle ORM no Cursor: Um Guia Completo
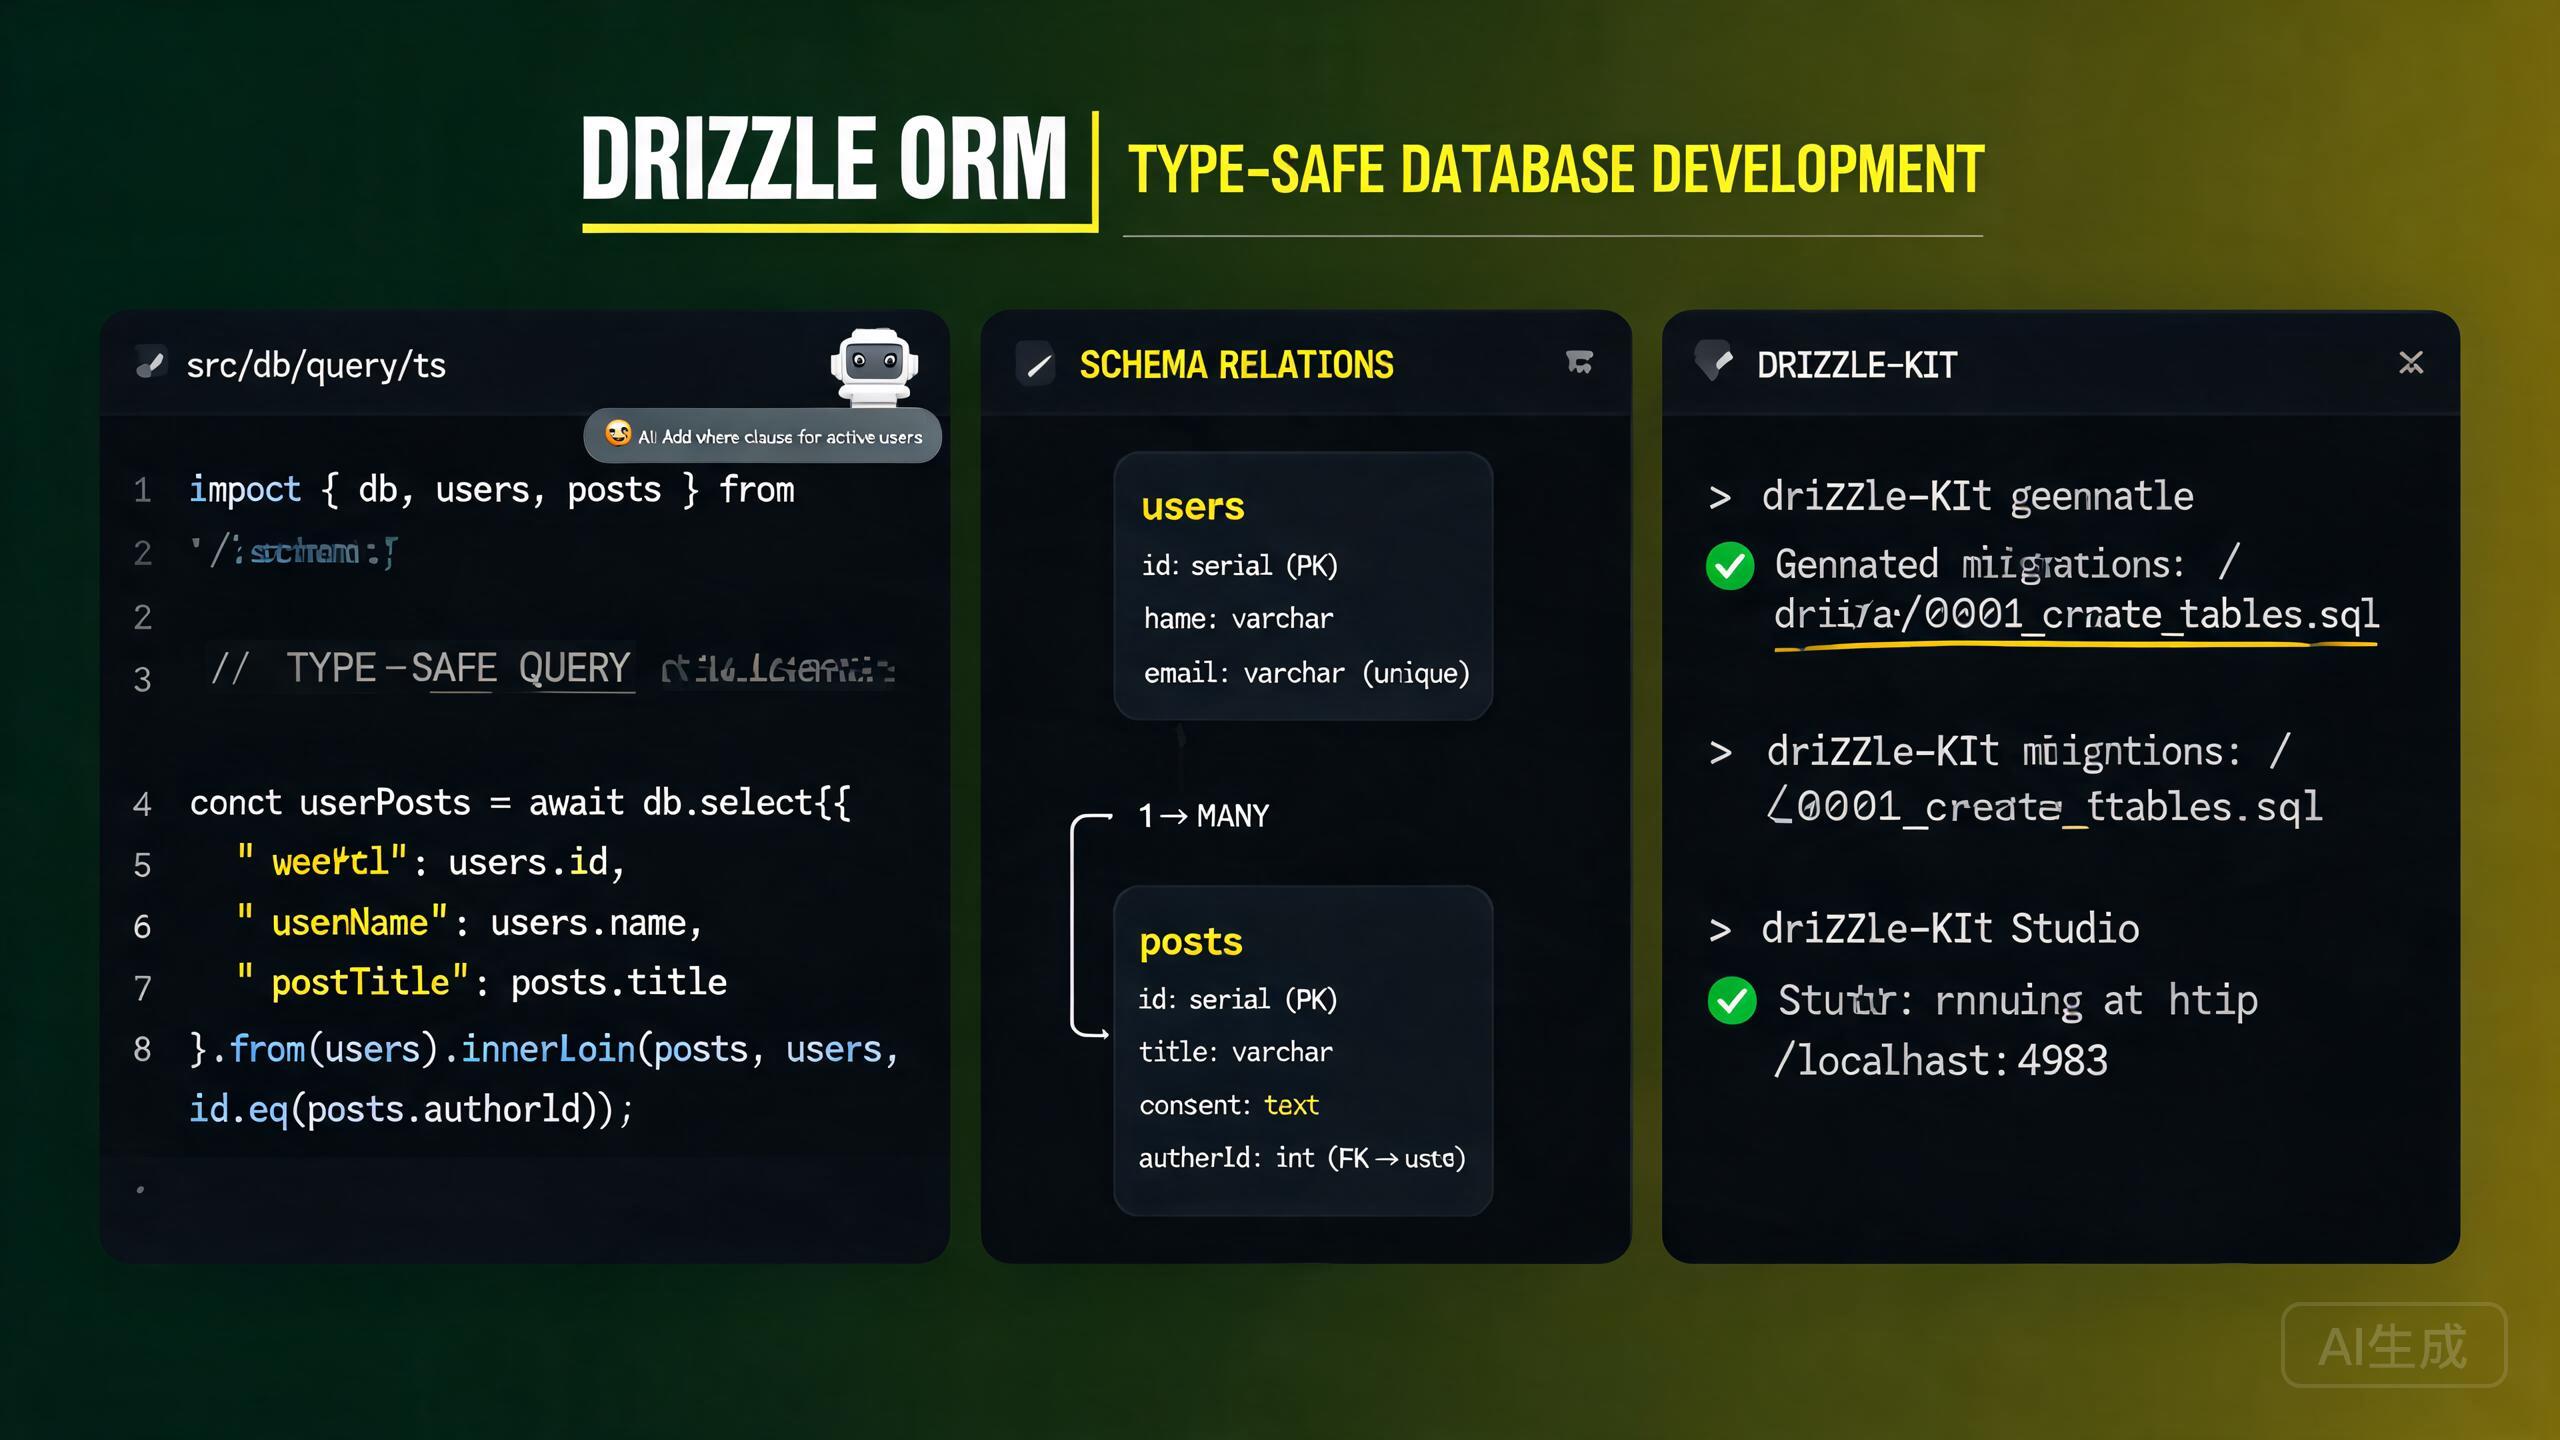
Drizzle ORM é um ORM leve, TypeScript-first que fornece consultas SQL type-safe sem o overhead de um runtime pesado. Diferente de ORMs tradicionais, Drizzle oferece controle SQL completo mantendo total segurança de tipos em tempo de compilação. Drizzle suporta PostgreSQL, MySQL e SQLite com uma superfície de API unificada. O Cursor, com seu assistente de IA integrado e servidor de linguagem TypeScript integrado, é um editor ideal para desenvolvimento Drizzle -- ele fornece IntelliSense completo para definições de schema, auto-completa construtores de consulta e pode gerar schemas e consultas completos a partir de descrições em linguagem natural.
Este guia aborda o fluxo de trabalho completo de desenvolvimento com Drizzle no Cursor: instalação e configuração, definição de schema, migrações com drizzle-kit, consultas type-safe, relacionamentos e construção de consultas com IA.
Instalando e Configurando Drizzle no Cursor
Pré-requisitos
Drizzle requer Node.js 18 ou mais recente e funciona com PostgreSQL, MySQL ou SQLite. Verifique sua versão do Node.js:
node --version
O servidor de linguagem TypeScript integrado do Cursor fornece verificação de tipos em tempo real para schemas e consultas Drizzle. Você vê erros de tipo inline antes mesmo de executar seu código, o que é especialmente valioso para os construtores de consulta fortemente tipados do Drizzle.
Instalando Dependências
Instale o Drizzle ORM e a ferramenta CLI drizzle-kit:
# Para PostgreSQL
npm install drizzle-orm pg
npm install drizzle-kit --save-dev

# Para MySQL
npm install drizzle-orm mysql2
npm install drizzle-kit --save-dev

# Para SQLite (better-sqlite3)
npm install drizzle-orm better-sqlite3
npm install drizzle-kit --save-dev

# Para SQLite (libSQL/Turso)
npm install drizzle-orm @libsql/client
npm install drizzle-kit --save-dev
Defina sua string de conexão com o banco de dados em .env:
# .env
DATABASE_URL="postgresql://user:password@localhost:5432/mydb"
Configurando o drizzle-kit
Crie um arquivo drizzle.config.ts na raiz do seu projeto:
// drizzle.config.ts
import { defineConfig } from 'drizzle-kit';

export default defineConfig({
  schema: './src/db/schema.ts',
  out: './drizzle',
  dialect: 'postgresql',
  dbCredentials: {
    url: process.env.DATABASE_URL!,
  },
  verbose: true,
  strict: true,
});
Se você estiver usando MySQL, defina dialect: 'mysql' na configuração. Se você estiver usando SQLite, defina dialect: 'sqlite'. O campo dialect determina qual dialeto SQL o drizzle-kit gera para migrações. Um dialeto incorreto produzirá arquivos de migração que falham no seu banco de dados.
Criando o Cliente do Banco de Dados
// src/db/client.ts
import { drizzle } from 'drizzle-orm/node-postgres';
import { Pool } from 'pg';
import * as schema from './schema';

const pool = new Pool({
  connectionString: process.env.DATABASE_URL!,
});

export const db = drizzle(pool, { schema });
export type DB = typeof db;
Sempre importe e passe seu objeto de schema para o construtor drizzle(). Isso habilita a API de consulta relacional (db.query.users.findMany()) que fornece busca de dados aninhados com total segurança de tipos.
Definição de Schema
Schemas Drizzle são definidos em arquivos TypeScript usando funções builder. Cada função mapeia para um tipo de coluna SQL.
Definindo Tabelas
// src/db/schema.ts
import {
  pgTable,
  uuid,
  varchar,
  text,
  boolean,
  integer,
  timestamp,
  enum,
  pgEnum,
} from 'drizzle-orm/pg-core';
import { relations } from 'drizzle-orm';

// Enums
export const userRoleEnum = pgEnum('user_role', ['admin', 'member', 'viewer']);

// Tabela Users
export const users = pgTable('users', {
  id: uuid('id').defaultRandom().primaryKey(),
  email: varchar('email', { length: 255 }).notNull().unique(),
  name: varchar('name', { length: 100 }),
  role: userRoleEnum('role').default('member').notNull(),
  avatarUrl: text('avatar_url'),
  createdAt: timestamp('created_at').defaultNow().notNull(),
  updatedAt: timestamp('updated_at').defaultNow().notNull(),
});

// Tabela Posts
export const posts = pgTable('posts', {
  id: uuid('id').defaultRandom().primaryKey(),
  title: varchar('title', { length: 200 }).notNull(),
  content: text('content'),
  published: boolean('published').default(false).notNull(),
  viewCount: integer('view_count').default(0).notNull(),
  authorId: uuid('author_id').references(() => users.id, { onDelete: 'cascade' }),
  createdAt: timestamp('created_at').defaultNow().notNull(),
  updatedAt: timestamp('updated_at').defaultNow().notNull(),
});

// Tabela Profiles
export const profiles = pgTable('profiles', {
  id: uuid('id').defaultRandom().primaryKey(),
  bio: text('bio'),
  userId: uuid('user_id').references(() => users.id, { onDelete: 'cascade' }).unique(),
  createdAt: timestamp('created_at').defaultNow().notNull(),
});
Tipos de Coluna Comuns (PostgreSQL)
| Função Drizzle | Tipo SQL | Notas |
|---|---|---|
uuid() | UUID | Use .defaultRandom() para geração automática |
varchar({ length: n }) | VARCHAR(n) | String de comprimento variável |
text() | TEXT | String de comprimento ilimitado |
integer() | INTEGER | Inteiro de 32 bits |
boolean() | BOOLEAN | Verdadeiro/falso |
timestamp() | TIMESTAMP | Use .defaultNow() para preenchimento automático |
jsonb() | JSONB | Dados estruturados |
serial() | SERIAL | Inteiro auto-incrementável |
pgEnum() | ENUM | Tipo enum do PostgreSQL |
decimal() | DECIMAL | Número de ponto fixo |
Peça ao Cursor: "Gere um schema Drizzle para PostgreSQL com modelos User, Post, Comment e Tag. Use chaves primárias UUID, inclua timestamps e configure relacionamentos um-para-muitos e muitos-para-muitos." O Cursor produzirá um schema TypeScript validado com imports e definições de relacionamento corretos.
Definindo Relacionamentos
Relacionamentos Drizzle são definidos separadamente das tabelas usando a função relations(). Eles não afetam o schema do banco de dados -- apenas configuram a API de consulta relacional:
// src/db/schema.ts (continuação)
import { relations } from 'drizzle-orm';

export const usersRelations = relations(users, ({ one, many }) => ({
  profile: one(profiles, {
    fields: [users.id],
    references: [profiles.userId],
  }),
  posts: many(posts),
}));

export const postsRelations = relations(posts, ({ one, many }) => ({
  author: one(users, {
    fields: [posts.authorId],
    references: [users.id],
  }),
  comments: many(comments),
}));

export const profilesRelations = relations(profiles, ({ one }) => ({
  user: one(users, {
    fields: [profiles.userId],
    references: [users.id],
  }),
}));

export const comments = pgTable('comments', {
  id: uuid('id').defaultRandom().primaryKey(),
  content: text('content').notNull(),
  authorId: uuid('author_id').references(() => users.id, { onDelete: 'cascade' }),
  postId: uuid('post_id').references(() => posts.id, { onDelete: 'cascade' }),
  createdAt: timestamp('created_at').defaultNow().notNull(),
});

export const commentsRelations = relations(comments, ({ one }) => ({
  author: one(users, {
    fields: [comments.authorId],
    references: [users.id],
  }),
  post: one(posts, {
    fields: [comments.postId],
    references: [posts.id],
  }),
}));
Relacionamentos Drizzle são puramente para a API de consulta e não criam restrições de chave estrangeira no banco de dados. A chave estrangeira real é definida na definição da tabela usando .references(). Se você definir um relacionamento em relations() mas esquecer o .references() na tabela, a consulta relacional funcionará mas o banco de dados não imporá integridade referencial.
Migrações com drizzle-kit
drizzle-kit gera arquivos de migração SQL comparando sua definição de schema com o estado atual do banco de dados.
Gerando Migrações
npx drizzle-kit generate
Isso cria um arquivo de migração SQL no diretório drizzle/ (como configurado em drizzle.config.ts):
-- drizzle/0000_initial_migration.sql
CREATE TYPE "user_role" AS ENUM('admin', 'member', 'viewer');

CREATE TABLE "users" (
  "id" uuid PRIMARY KEY DEFAULT gen_random_uuid() NOT NULL,
  "email" varchar(255) NOT NULL,
  "name" varchar(100),
  "role" "user_role" DEFAULT 'member' NOT NULL,
  "avatar_url" text,
  "created_at" timestamp DEFAULT now() NOT NULL,
  "updated_at" timestamp DEFAULT now() NOT NULL,
  CONSTRAINT "users_email_unique" UNIQUE("email")
);

CREATE TABLE "posts" (
  "id" uuid PRIMARY KEY DEFAULT gen_random_uuid() NOT NULL,
  "title" varchar(200) NOT NULL,
  "content" text,
  "published" boolean DEFAULT false NOT NULL,
  "view_count" integer DEFAULT 0 NOT NULL,
  "author_id" uuid,
  "created_at" timestamp DEFAULT now() NOT NULL,
  "updated_at" timestamp DEFAULT now() NOT NULL
);

ALTER TABLE "posts" ADD COLUMN "author_id" uuid REFERENCES "users"("id") ON DELETE CASCADE;
Aplicando Migrações
npx drizzle-kit migrate
Isso aplica todos os arquivos de migração pendentes ao seu banco de dados em ordem.
Use npx drizzle-kit generate após cada mudança de schema, depois revise o SQL gerado antes de executar migrate. A geração de migrações do Drizzle é excelente, mas não perfeita -- sempre verifique se o SQL corresponde à sua intenção, especialmente para operações complexas como renomeação de colunas ou mudanças de tipo.
Enviando Mudanças de Schema Diretamente
Para prototipagem rápida, você pode enviar mudanças de schema diretamente ao banco de dados sem gerar arquivos de migração:
npx drizzle-kit push
Isso sincroniza seu schema com o banco de dados imediatamente.
drizzle-kit push ignora arquivos de migração e aplica mudanças diretamente. Isso é ótimo para desenvolvimento, mas nunca deve ser usado em produção. Sempre use generate + migrate para deployments de produção para manter um histórico de migração versionado.
Journal de Migração
drizzle-kit mantém um arquivo meta/_journal.json que rastreia migrações aplicadas:
[
  {
    "version": "5",
    "idx": 0,
    "when": 1700000000000,
    "tag": "initial_migration",
    "breakpoints": true
  }
]
Consultas Type-Safe
O construtor de consultas do Drizzle é totalmente tipado. Cada consulta que você escreve é verificada em tempo de compilação, e o IntelliSense do Cursor fornece autocomplete para nomes de tabela, colunas e operadores.
Consultas Select
import { eq, and, gte, lte, desc, asc, sql } from 'drizzle-orm';
import { db } from './client';
import { users, posts, profiles } from './schema';

// Selecionar colunas específicas
const userEmails = await db
  .select({ id: users.id, email: users.email, name: users.name })
  .from(users);

// Select com filtragem
const publishedPosts = await db
  .select()
  .from(posts)
  .where(eq(posts.published, true))
  .orderBy(desc(posts.createdAt))
  .limit(10);

// Select com múltiplas condições
const recentPosts = await db
  .select()
  .from(posts)
  .where(
    and(
      eq(posts.published, true),
      gte(posts.createdAt, new Date('2024-01-01')),
      lte(posts.createdAt, new Date('2024-12-31'))
    )
  )
  .orderBy(desc(posts.viewCount), asc(posts.createdAt));
Joins
// Inner Join: posts com seus autores
const postsWithAuthors = await db
  .select({
    postId: posts.id,
    title: posts.title,
    authorName: users.name,
    authorEmail: users.email,
  })
  .from(posts)
  .innerJoin(users, eq(posts.authorId, users.id))
  .where(eq(posts.published, true));

// Left Join: usuários com perfis opcionais
const usersWithProfiles = await db
  .select({
    userId: users.id,
    email: users.email,
    bio: profiles.bio,
  })
  .from(users)
  .leftJoin(profiles, eq(users.id, profiles.userId));
Consultas Insert
// Inserir um único registro
const [newUser] = await db
.insert(users)
.values({
name: 'New User',
role: 'member',
})
.returning();
// Inserir múltiplos registros
const newPosts = await db
.insert(posts)
.values([
{ title: 'Post 1', content: 'Content 1', authorId: userId },
{ title: 'Post 2', content: 'Content 2', authorId: userId },
])
.returning({ id: posts.id, title: posts.title });
// Insert com tratamento de conflito (upsert)
const [upsertedUser] = await db
.insert(users)
.onConflictDoUpdate({
target: users.email,
set: { name: 'Updated Name', updatedAt: new Date() },
})
.returning();
Peça ao Cursor: "Escreva uma consulta upsert Drizzle que insere um novo usuário se o email não existir, ou atualiza o nome e avatarUrl se existir. Retorne o registro inserido/atualizado." O Cursor gerará a sintaxe onConflictDoUpdate corretamente.
Update e Delete
// Atualizar registros
const [updatedPost] = await db
  .update(posts)
  .set({ title: 'Updated Title', viewCount: sql`${posts.viewCount} + 1` })
  .where(eq(posts.id, postId))
  .returning();

// Excluir registros
await db.delete(posts).where(eq(posts.authorId, deletedUserId));

// Excluir com condição
const deletedCount = await db
  .delete(posts)
  .where(and(eq(posts.published, false), lt(posts.createdAt, thirtyDaysAgo)))
  .returning();
API de Consulta Relacional
A API de consulta relacional do Drizzle fornece uma maneira declarativa de buscar dados aninhados:
// Buscar um usuário com seu perfil e posts
const userWithData = await db.query.users.findFirst({
with: {
profile: true,
posts: {
where: eq(posts.published, true),
orderBy: desc(posts.createdAt),
limit: 5,
with: {
comments: {
with: {
author: {
columns: { id: true, name: true, avatarUrl: true },
},
},
},
},
},
},
});
// Buscar todos os posts publicados com autor e comentários
const allPosts = await db.query.posts.findMany({
where: eq(posts.published, true),
orderBy: desc(posts.createdAt),
limit: 20,
with: {
author: {
columns: { id: true, name: true, email: true },
},
comments: {
orderBy: desc(comments.createdAt),
with: {
author: true,
},
},
},
});
A API de consulta relacional (db.query.*) requer que você passe seu schema para o construtor drizzle(): drizzle(pool, { schema }). Sem o schema, o namespace db.query será indefinido e todas as consultas relacionais lançarão um erro de runtime.
Agregações e Group By
import { count, sql } from 'drizzle-orm';

// Contar posts por autor
const postCounts = await db
  .select({
    authorId: posts.authorId,
    authorName: users.name,
    postCount: count(posts.id),
  })
  .from(posts)
  .innerJoin(users, eq(posts.authorId, users.id))
  .where(eq(posts.published, true))
  .groupBy(posts.authorId, users.name)
  .orderBy(desc(count(posts.id)))
  .limit(5);

// Soma e média
const stats = await db
  .select({
    totalViews: sql<number>`sum(${posts.viewCount})`,
    avgViews: sql<number>`avg(${posts.viewCount})`,
    postCount: count(posts.id),
  })
  .from(posts)
  .where(eq(posts.published, true));
Transações
Drizzle suporta tanto transações baseadas em callback quanto baseadas em declarações:
// Transação baseada em callback
const result = await db.transaction(async (tx) => {
const [newUser] = await tx
.insert(users)
.returning();
const [newPost] = await tx
.insert(posts)
.values({
title: 'First Post',
content: 'Hello',
authorId: newUser.id,
published: true,
})
.returning();
await tx
.insert(profiles)
.values({ bio: 'Author bio', userId: newUser.id })
.returning();
return { user: newUser, post: newPost };
});
Peça ao Cursor: "Escreva uma transação Drizzle que cria um usuário, o atribui a um workspace como membro e cria um projeto padrão. Reverta em qualquer erro." O Cursor gerará a transação baseada em callback com propagação de erro adequada.
Construção de Consultas com IA no Cursor
O assistente de IA do Cursor pode gerar consultas Drizzle complexas, definições de schema e estratégias de migração a partir de descrições em linguagem natural.
Gerando Consultas a partir de Prompts
Abra o Cursor Chat (Ctrl+L) e descreva o que você precisa:
Write a Drizzle ORM query to fetch the top 10 most-viewed published posts
from the last 30 days, including each post's author name and email, the
count of comments, and the count of likes. Order by view count descending.
Use the relational query API (db.query.posts.findMany).
const thirtyDaysAgo = new Date();
thirtyDaysAgo.setDate(thirtyDaysAgo.getDate() - 30);

const topPosts = await db.query.posts.findMany({
  where: and(
    eq(posts.published, true),
    gte(posts.createdAt, thirtyDaysAgo)
  ),
  orderBy: desc(posts.viewCount),
  limit: 10,
  with: {
    author: {
      columns: { id: true, name: true, email: true },
    },
  },
  extras: {
    commentCount: sql<number>`(
      SELECT count(*) FROM comments WHERE comments.post_id = posts.id
    )`.as('commentCount'),
    likeCount: sql<number>`(
      SELECT count(*) FROM likes WHERE likes.post_id = posts.id
    )`.as('likeCount'),
  },
});
Ao pedir ao Cursor para gerar consultas Drizzle, especifique se você quer a API do construtor de consultas (db.select().from()) ou a API de consulta relacional (db.query.*.findMany()). As duas APIs têm sintaxe e trade-offs diferentes -- o construtor de consultas oferece mais controle SQL enquanto a API relacional é mais declarativa.
Gerando Schemas a partir de Descrições
Generate a Drizzle schema for a multi-tenant SaaS application using
PostgreSQL. Include: Tenant, User (with tenantId), Subscription (with
plan enum: FREE/PRO/ENTERPRISE), ApiKey, and Webhook table. Use UUIDs,
timestamps, proper foreign keys with cascade delete, and add indexes on
tenantId columns.
Migração de Schema com IA
Ao refatorar seu schema, peça ajuda ao Cursor:
I need to add a "soft delete" feature to my Drizzle schema. Add a
"deleted_at" timestamp column to the posts and comments tables that is
nullable. Then update my existing queries to filter out soft-deleted
records by default. Show me how to generate the migration.
O Cursor irá:
- Adicionar a coluna
deletedAta ambas as tabelas. - Atualizar consultas select para adicionar filtros
isNull(posts.deletedAt). - Gerar o comando de migração drizzle-kit.
Ao adicionar colunas de soft delete, consultas existentes que não filtram por deletedAt retornarão registros soft-deleted. Peça ao Cursor para auditar todas as suas consultas após a mudança de schema para garantir que nenhuma vaze dados soft-deleted.
Desempenho e Melhores Práticas
Estratégia de Indexação
import { index } from 'drizzle-orm/pg-core';

export const posts = pgTable(
  'posts',
  {
    id: uuid('id').defaultRandom().primaryKey(),
    title: varchar('title', { length: 200 }).notNull(),
    authorId: uuid('author_id').references(() => users.id),
    published: boolean('published').default(false).notNull(),
    createdAt: timestamp('created_at').defaultNow().notNull(),
  },
  (table) => ({
    authorIdx: index('posts_author_id_idx').on(table.authorId),
    publishedIdx: index('posts_published_created_idx').on(
      table.published,
      table.createdAt
    ),
  })
);
Pool de Conexões
import { Pool } from 'pg';
import { drizzle } from 'drizzle-orm/node-postgres';

const pool = new Pool({
  connectionString: process.env.DATABASE_URL!,
  max: 20,
  idleTimeoutMillis: 30000,
  connectionTimeoutMillis: 2000,
});

export const db = drizzle(pool, { schema, logger: true });
Em ambientes serverless (Vercel, AWS Lambda), use um pooler de conexões como PgBouncer ou um driver serverless como @neondatabase/serverless. Conexões diretas PostgreSQL não escalam bem em serverless porque cada instância de função cria seu próprio pool, esgotando o limite de conexões do banco de dados.
Prepared Statements
import { sql } from 'drizzle-orm';

const findPostsByAuthor = db
  .select()
  .from(posts)
  .where(and(eq(posts.authorId, sql.placeholder('authorId')), eq(posts.published, true)))
  .prepare('findPostsByAuthor');

const result = await findPostsByAuthor.execute({ authorId: userId });
Conclusão
Drizzle ORM combinado com o Cursor cria uma experiência de desenvolvimento de banco de dados poderosa e type-safe. A definição de schema nativa em TypeScript oferece controle SQL completo enquanto o servidor de linguagem do Cursor captura erros de tipo em tempo real. drizzle-kit fornece um fluxo de trabalho de migração confiável com comandos generate e migrate para produção, e push para prototipagem rápida. A API de consulta dupla -- estilo builder db.select().from() e declarativa db.query.*.findMany() -- permite escolher o nível de abstração certo para cada consulta. O assistente de IA do Cursor acelera cada passo, desde a geração de schemas completos para domínios complexos até a escrita de consultas otimizadas com joins, agregações e transações. Comece definindo seu schema em TypeScript, configure o drizzle-kit, use generate e migrate para evolução de schema, e deixe o Cursor construir as consultas type-safe para que você possa focar na lógica da sua aplicação.