علوم البيانات باستخدام Python في Cursor: دليل شامل
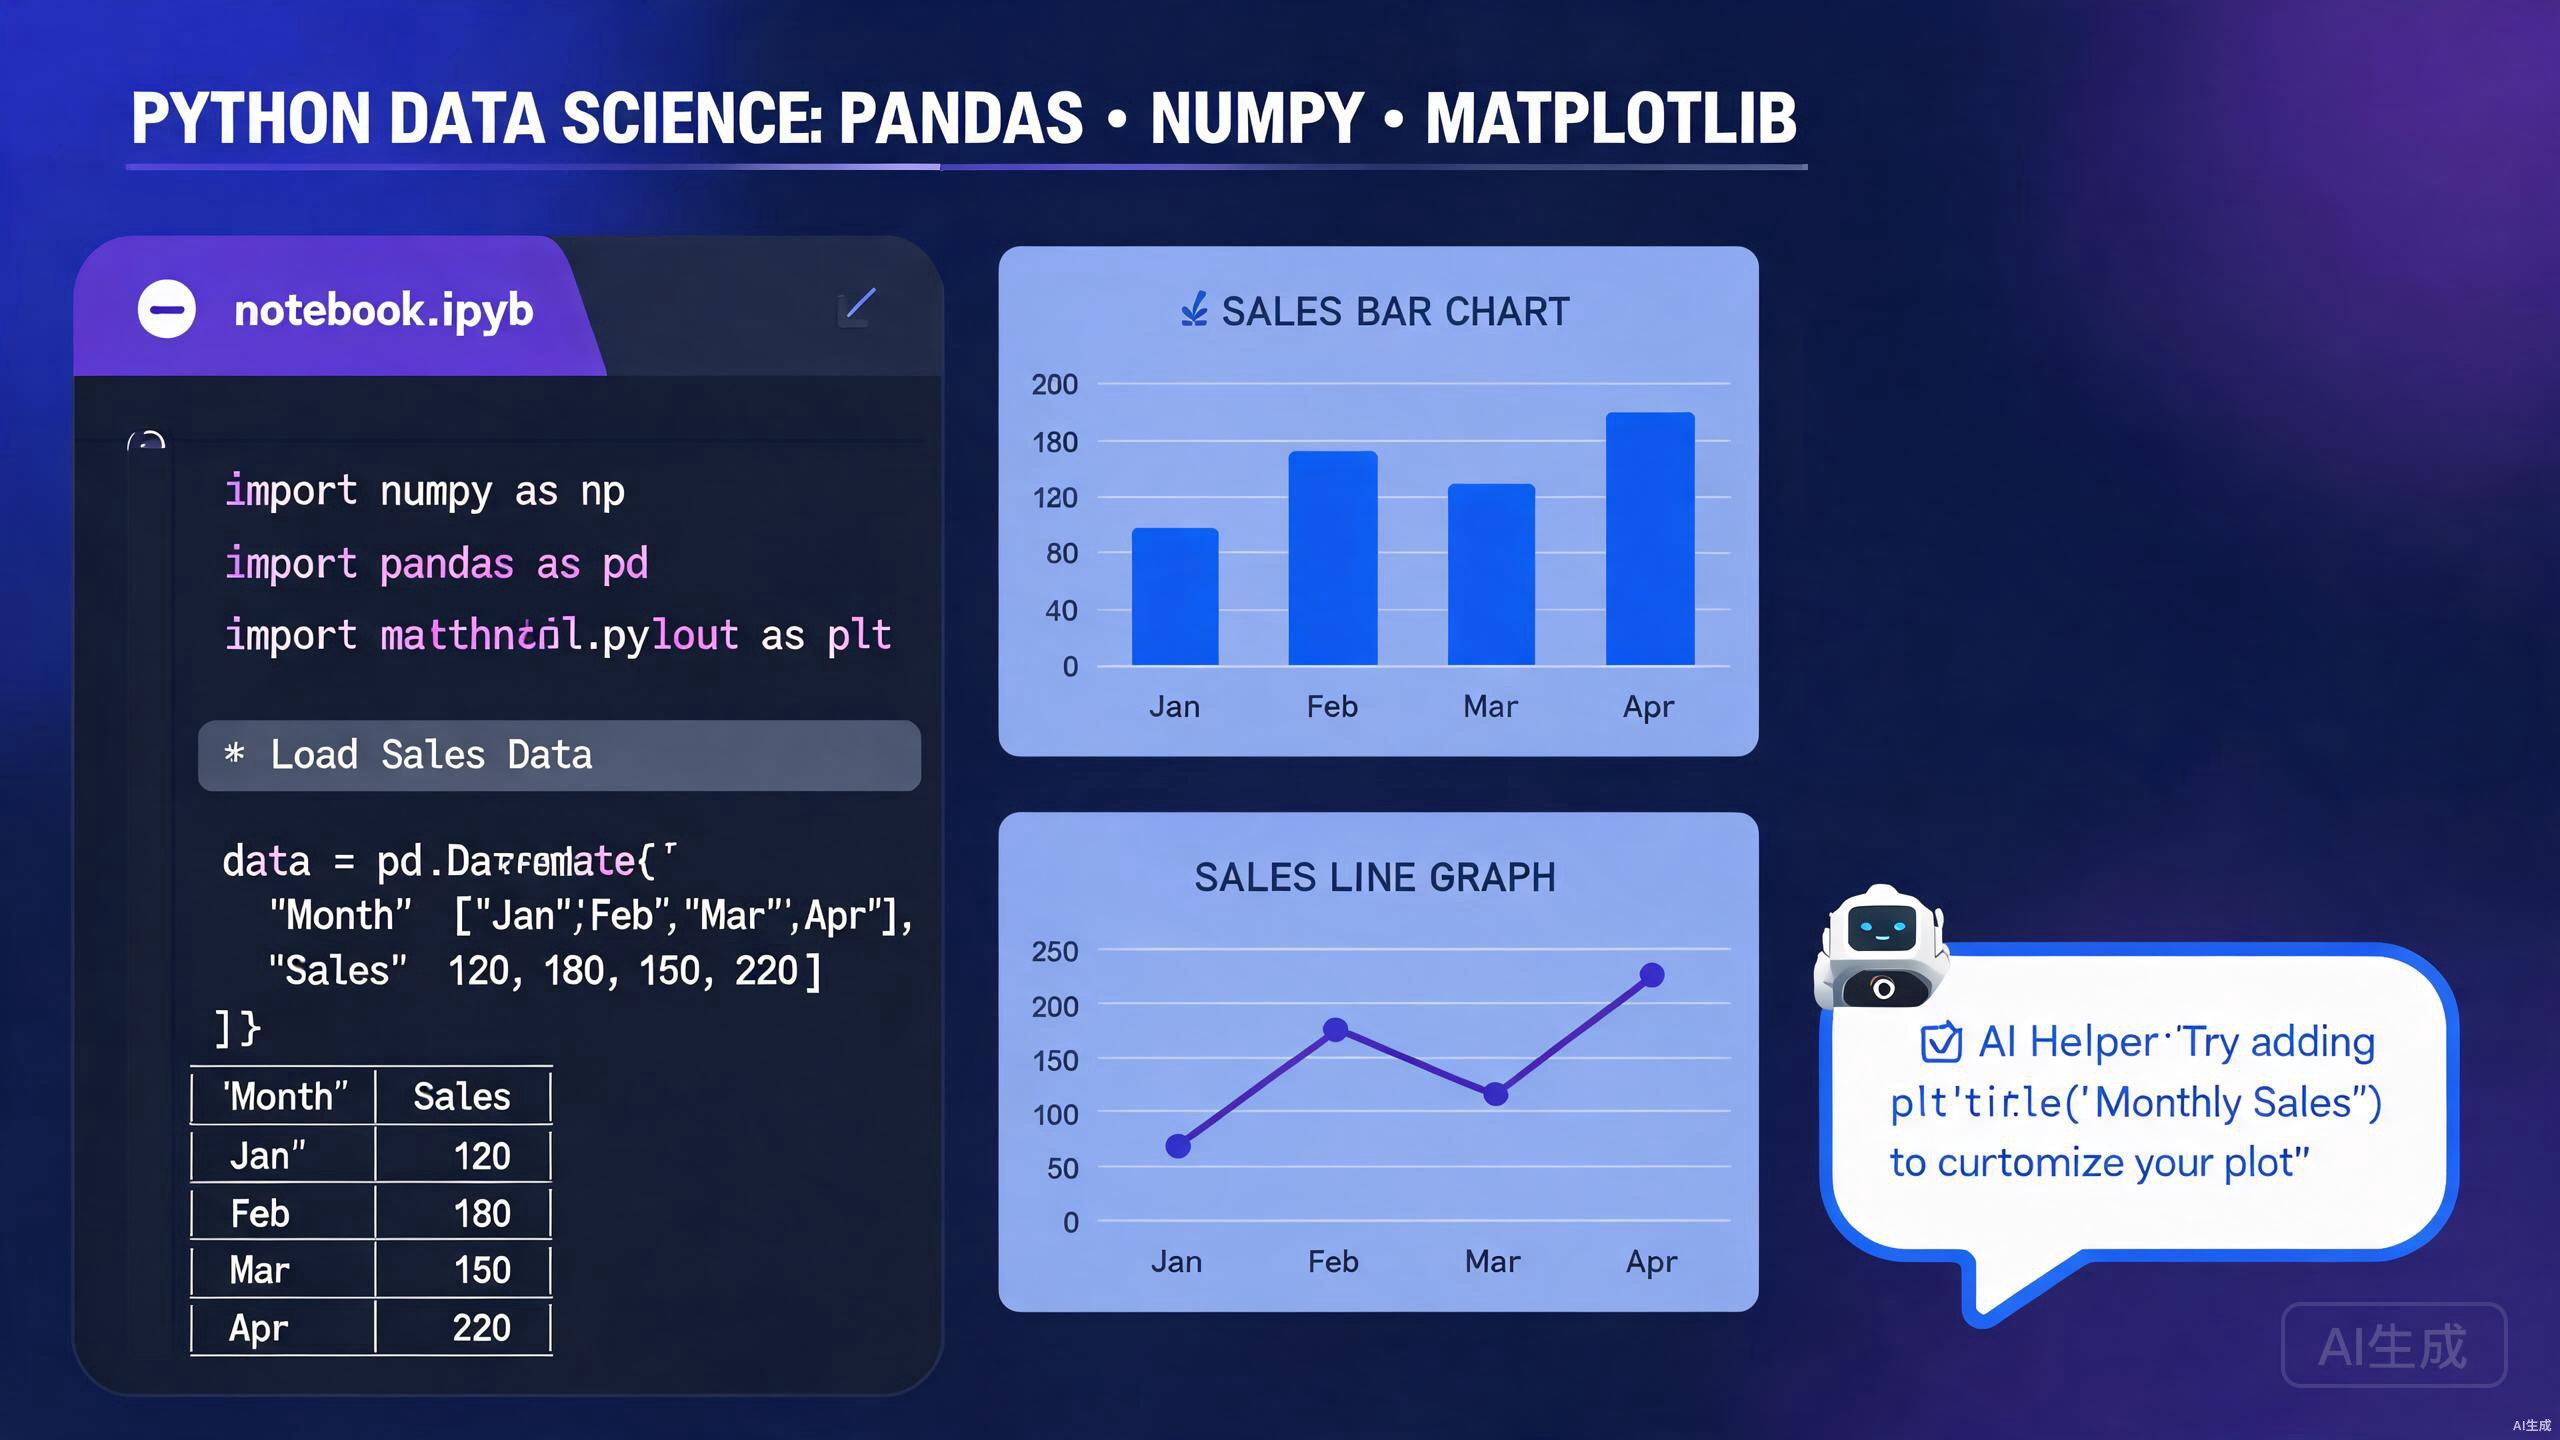
تتطلب علوم البيانات تجريباً سريعاً وتصوراً قوياً وسير عمل قابل للتكرار. يجمع Cursor هذه العناصر من خلال دمج محرر تعليمات برمجية من الطراز العالمي مع تحليل مدعوم بالذكاء الاصطناعي ودعم Jupyter الأصلي وتكامل سلس مع مجموعة أدوات علوم البيانات في Python. يرشدك هذا الدليل خلال إعداد بيئتك والاستفادة من ميزات Cursor الفريدة لـ pandas وNumPy وMatplotlib وما بعدها.
إعداد بيئة علوم البيانات
بيئة Python الموثوقة هي أساس أي مشروع علوم بيانات. يجعل Cursor إدارة البيئة سهلة من خلال دعم الطرفية المدمج واكتشاف البيئة الافتراضية.
تثبيت Python والبيئات الافتراضية
تحقق من تثبيت Python في طرفية Cursor:
python --version
أنشئ بيئة افتراضية مخصصة لمشروعك:
python -m venv .venv
source .venv/bin/activate  # على Windows: .venv\Scripts\activate
يكتشف Cursor تلقائياً .venv في جذر مساحة العمل ويعرض تحديده كمفسر نشط. ابحث عن مؤشر إصدار Python في شريط الحالة.
تثبيت مكتبات علوم البيانات الأساسية
قم بتثبيت المجموعة الأساسية باستخدام pip:
pip install pandas numpy matplotlib seaborn scikit-learn jupyterlab
بالنسبة لسير عمل التعلم العميق، أضف PyTorch أو TensorFlow:
pip install torch torchvision torchaudio
ثبت اعتمادياتك لقابلية التكرار:
pip freeze > requirements.txt
تجنب خلط conda وpip في نفس البيئة إلا إذا كنت تفهم آثار حل الاعتماديات. التزم بمدير حزم واحد لكل مشروع لمنع التعارضات.
تكوين Cursor لـ Python
قم بتثبيت ملحق Python الرسمي في Cursor للحصول على IntelliSense والتدقيق والتنسيق. الإعدادات الموصى بها لعلوم البيانات:
{
  "python.analysis.typeCheckingMode": "basic",
  "python.formatting.provider": "black",
  "python.linting.enabled": true,
  "python.linting.pylintEnabled": false,
  "python.linting.ruffEnabled": true,
  "jupyter.askForKernelRestart": false,
  "jupyter.interactiveWindow.creationMode": "perFile"
}
دفاتر Jupyter في Cursor
دفاتر Jupyter أساسية لتحليل البيانات الاستكشافي. يوفر Cursor دعماً من الدرجة الأولى للدفاتر مع مساعدة الذكاء الاصطناعي وفحص المتغيرات وقدرات التصدير.
إنشاء وتشغيل الدفاتر
أنشئ دفتراً جديداً عبر لوحة الأوامر (Ctrl+Shift+P) باختيار "Jupyter: Create New Jupyter Notebook". يفتح Cursor ملف .ipynb بواجهة غنية تعرض خلايا الكود وmarkdown والمخرجات مضمنة.
حدد النواة من القائمة المنسدلة في أعلى اليمين. يسرد Cursor تلقائياً جميع مفسرات Python وبيئات conda المتاحة.
استخدم اختصارات لوحة المفاتيح لتسريع سير عمل الدفتر: Shift+Enter يشغل الخلية الحالية، A يدرج خلية أعلاه، وB يدرج خلية أسفله في وضع الأوامر.
إنشاء الخلايا بمساعدة الذكاء الاصطناعي
صف هدف تحليلك في خلية markdown، ثم اطلب من الذكاء الاصطناعي في Cursor إنشاء كود Python المقابل. على سبيل المثال:
## Goal: Load the Titanic dataset, handle missing ages with median imputation,
## and visualize survival rates by passenger class
ينشئ Cursor:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

df = pd.read_csv("titanic.csv")
df['Age'] = df['Age'].fillna(df['Age'].median())

plt.figure(figsize=(10, 6))
sns.barplot(data=df, x='Pclass', y='Survived', hue='Sex')
plt.title('Survival Rates by Passenger Class and Gender')
plt.ylabel('Survival Rate')
plt.show()
مفتش المتغيرات وعارض البيانات
بعد تشغيل الخلايا، استخدم لوحة المتغيرات لفحص DataFrames والمصفوفات وكائنات النماذج. انقر على متغير DataFrame لفتح عارض بيانات يشبه جدول البيانات مع الفرز والتصفية. هذا يلغي الحاجة إلى استدعاءات df.head() المتكررة.
يمكن أن تستهلك DataFrames الكبيرة ذاكرة كبيرة عند فتحها في عارض البيانات. بالنسبة لمجموعات البيانات التي تتجاوز بضعة ملايين من الصفوف، فكر في أخذ عينات أو تجميع قبل الفحص البصري.
التحويل بين السكريبتات والدفاتر
يدعم Cursor تحويل سكريبتات .py إلى دفاتر .ipynb والعكس. استخدم لوحة الأوامر لتشغيل "Jupyter: Export Current Python File as Jupyter Notebook". هذا مفيد عندما تحتاج إلى الانتقال من التجريب إلى سكريبتات جاهزة للإنتاج.
معالجة البيانات باستخدام Pandas
Pandas هو العمود الفقري لمعالجة البيانات في Python. الإكمال التلقائي ومساعدة الذكاء الاصطناعي في Cursor تجعل عمليات DataFrame أسرع وأقل عرضة للأخطاء.
خطوط أنابيب تنظيف البيانات المولدة بالذكاء الاصطناعي
تنظيف البيانات غالباً ما يكون متكرراً. دع Cursor ينشئ خطوط أنابيب كاملة من أوصاف اللغة الطبيعية:
# Clean the sales dataset: remove duplicates, parse dates,
# standardize column names to snake_case, and filter out negative revenue
ينتج Cursor:
import pandas as pd

df = pd.read_csv("sales.csv")
df = df.drop_duplicates()
df['OrderDate'] = pd.to_datetime(df['OrderDate'], errors='coerce')
df.columns = df.columns.str.lower().str.replace(' ', '_')
df = df[df['revenue'] >= 0]
التحويلات المعقدة والتجميع
بالنسبة للعمليات المتقدمة مثل التجميع متعدد المستويات ودوال النافذة، تتألق اقتراحات Cursor المضمنة:
monthly_stats = (
    df.groupby([df['order_date'].dt.to_period('M'), 'region'])
    .agg(
        total_revenue=('revenue', 'sum'),
        avg_order_value=('revenue', 'mean'),
        order_count=('order_id', 'nunique')
    )
    .reset_index()
)
عند كتابة سلاسل pandas معقدة، قسمها إلى أسطر متعددة باستخدام الأقواس. يقوم Cursor بتنسيقها بشكل جميل ويوفر إكمالاً تلقائياً أفضل في كل خطوة.
معالجة البيانات المفقودة بشكل استراتيجي
تتطلب البيانات المفقودة معرفة بالمجال. اسأل Cursor عن استراتيجيات خاصة بمجموعة بياناتك:
# For numeric columns: median imputation
# For categorical columns: mode imputation
# For datetime columns: forward fill

numeric_cols = df.select_dtypes(include=['number']).columns
categorical_cols = df.select_dtypes(include=['object']).columns
datetime_cols = df.select_dtypes(include=['datetime64']).columns

df[numeric_cols] = df[numeric_cols].fillna(df[numeric_cols].median())
df[categorical_cols] = df[categorical_cols].fillna(df[categorical_cols].mode().iloc[0])
df[datetime_cols] = df[datetime_cols].ffill()
الحوسبة العددية باستخدام NumPy
يوفر NumPy العمود الفقري العددي لعلوم البيانات في Python. يساعدك Cursor في كتابة عمليات مصفوفات موجهة وفعالة.
إنشاء المصفوفات ومعالجتها
الإكمال التلقائي في Cursor لـ NumPy واسع النطاق. قم بإنشاء المصفوفات وإجراء التحويلات:
import numpy as np

# Create a 3D array representing image batches
images = np.random.rand(32, 224, 224, 3)  # batch, height, width, channels

# Normalize pixel values to [0, 1]
normalized = (images - images.min()) / (images.max() - images.min())

# Transpose for a different library's expected format
transposed = normalized.transpose(0, 3, 1, 2)  # NCHW format
البث والتوجيه
تجنب حلقات Python من خلال الاستفادة من البث في NumPy. إذا كنت غير متأكد من كيفية توجيه عملية، صفها لـ Cursor:
# Vectorized calculation of Euclidean distance from a centroid
centroid = np.array([5.0, 3.0])
points = np.random.rand(1000, 2)

distances = np.sqrt(np.sum((points - centroid) ** 2, axis=1))
يمكن أن ينتج البث الضمني في NumPy أشكالاً غير متوقعة. تحقق دائماً من أبعاد مصفوفة المخرجات باستخدام .shape بعد العمليات المعقدة.
التكامل مع Pandas
تعمل دوال NumPy بسلاسة مع pandas Series وDataFrames:
# Apply a NumPy universal function to a DataFrame column
df['log_revenue'] = np.log1p(df['revenue'])

# Boolean indexing with compound conditions
high_value = df[
    (np.abs(df['revenue'] - df['revenue'].mean()) > 2 * df['revenue'].std()) |
    (df['quantity'] > 100)
]
التصور باستخدام Matplotlib وSeaborn
يحول التصور الفعال البيانات إلى رؤى. يعمل عرض المخططات المضمن واقتراحات الذكاء الاصطناعي في Cursor على تسريع سير عمل التصور لديك.
إنشاء مخططات بجودة النشر
يعرض Cursor أشكال Matplotlib مباشرة أسفل خلايا الكود في الدفاتر. قم بإنشاء أشكال معقدة متعددة اللوحات:
import matplotlib.pyplot as plt
import seaborn as sns

fig, axes = plt.subplots(2, 2, figsize=(14, 10))

# Distribution plot
sns.histplot(data=df, x='revenue', kde=True, ax=axes[0, 0])
axes[0, 0].set_title('Revenue Distribution')

# Correlation heatmap
corr = df[['revenue', 'quantity', 'discount']].corr()
sns.heatmap(corr, annot=True, cmap='coolwarm', ax=axes[0, 1])
axes[0, 1].set_title('Feature Correlations')

# Box plot by category
sns.boxplot(data=df, x='category', y='revenue', ax=axes[1, 0])
axes[1, 0].set_title('Revenue by Category')

# Time series
monthly = df.groupby(df['order_date'].dt.to_period('M'))['revenue'].sum()
monthly.plot(ax=axes[1, 1], marker='o')
axes[1, 1].set_title('Monthly Revenue Trend')

plt.tight_layout()
plt.show()
احفظ الأشكال بتنسيقات متعددة لحالات استخدام مختلفة: plt.savefig('figure.png', dpi=300) للعروض التقديمية وplt.savefig('figure.pdf') للمنشورات.
التصورات التفاعلية
للوحات المعلومات والاستكشاف التفاعلي، قم بدمج Plotly:
import plotly.express as px

fig = px.scatter(
    df, x='quantity', y='revenue', color='category',
    size='discount', hover_data=['product_name'],
    title='Revenue vs Quantity by Category'
)
fig.show()
يعرض Cursor مخططات Plotly بشكل تفاعلي في منطقة مخرجات الدفتر، مع التكبير والتحريك وتلميحات الأدوات.
تصورات مقترحة بالذكاء الاصطناعي
لست متأكداً من المخطط الذي ستستخدمه؟ اسأل Cursor:
لدي مجموعة بيانات تحتوي على ترك العملاء ومدة الخدمة والرسوم الشهرية.
ما التصورات التي ستكشف بشكل أفضل عن دوافع ترك العملاء؟
قد يقترح Cursor منحنيات Kaplan-Meier أو جداول الأفواج أو مخططات ملخص SHAP اعتماداً على سياق تحليلك.
سير عمل التعلم الآلي
من المعالجة المسبقة إلى تقييم النموذج، يبسط Cursor تطوير التعلم الآلي باستخدام scikit-learn وما بعده.
المعالجة المسبقة وهندسة الميزات
استخدم Cursor لإنشاء خطوط أنابيب معالجة مسبقة كاملة:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer

numeric_features = ['age', 'income', 'tenure']
categorical_features = ['gender', 'region', 'plan_type']

preprocessor = ColumnTransformer(
    transformers=[
        ('num', StandardScaler(), numeric_features),
        ('cat', OneHotEncoder(handle_unknown='ignore'), categorical_features)
    ]
)
تدريب النموذج وتقييمه
يمكن لـ Cursor إنشاء حلقات تدريب ومقاييس تقييم:
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)

y_pred = clf.predict(X_test)
print(classification_report(y_test, y_pred))
افصل دائماً بيانات التدريب والاختبار قبل أي معالجة مسبقة. يؤدي ضبط المحولات على مجموعة البيانات الكاملة إلى تسرب البيانات وتقديرات أداء مفرطة في التفاؤل.
ضبط المعلمات الفائقة
قم بإنشاء شبكات بحث المعلمات الفائقة بمساعدة Cursor:
from sklearn.model_selection import GridSearchCV

param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [None, 10, 20, 30],
    'min_samples_split': [2, 5, 10]
}

grid_search = GridSearchCV(
    RandomForestClassifier(random_state=42),
    param_grid,
    cv=5,
    scoring='f1_macro',
    n_jobs=-1
)
grid_search.fit(X_train, y_train)
print(f"Best parameters: {grid_search.best_params_}")
تحليل البيانات المدعوم بالذكاء الاصطناعي
تمتد قدرات الذكاء الاصطناعي في Cursor إلى ما وراء إنشاء الكود لتشمل التفكير الإحصائي والتوجيه التحليلي.
تحليل البيانات الاستكشافي باللغة الطبيعية
قم بتحميل مجموعة بيانات واطلب من Cursor إجراء تحليل استكشافي:
حلل ملف customer.csv. أرني توزيع القيمة الدائمة للعميل،
وحدد القيم الشاذة، واقترح شرائح للتسويق المستهدف.
ينشئ Cursor سلسلة من الخلايا تحسب الإحصائيات الوصفية والتصورات واقتراحات التجميع.
إنشاء الرؤى تلقائياً
بالنسبة لبيانات السلاسل الزمنية، يمكن لـ Cursor اقتراح التحليل والكشف عن الشذوذ والتنبؤ:
from statsmodels.tsa.seasonal import seasonal_decompose

result = seasonal_decompose(df['sales'], model='multiplicative', period=12)
result.plot()
plt.show()
توثيق التحليل في Markdown
علوم البيانات تعاونية. استخدم Cursor لإنشاء ملخصات Markdown لنتائجك إلى جانب الكود:
## Key Findings

- **Revenue Distribution**: Right-skewed with a long tail of high-value transactions
- **Seasonality**: Clear Q4 peak in sales, suggesting holiday-driven demand
- **Churn Predictors**: Tenure < 6 months and monthly charges > $70 are strongest indicators
الخاتمة
يعيد Cursor تعريف علوم البيانات في Python من خلال دمج الحوسبة التفاعلية ومساعدة الذكاء الاصطناعي وتحرير الكود الاحترافي في بيئة واحدة. سواء كنت تقوم بتنظيف مجموعات بيانات فوضوية في pandas، أو تدريب نماذج في scikit-learn، أو صياغة تصورات في Matplotlib، فإن Cursor يسرع كل خطوة. أتقن تكامل دفتر Jupyter، واستفد من الذكاء الاصطناعي لإنشاء الكود المبدئي، وتحقق دائماً من افتراضاتك التحليلية. مع Cursor، يصبح سير عمل علوم البيانات لديك أسرع وأكثر قابلية للتكرار ومتكاملاً بعمق مع المساعدة الذكية.