在 Cursor 中进行 Python 数据科学:综合指南
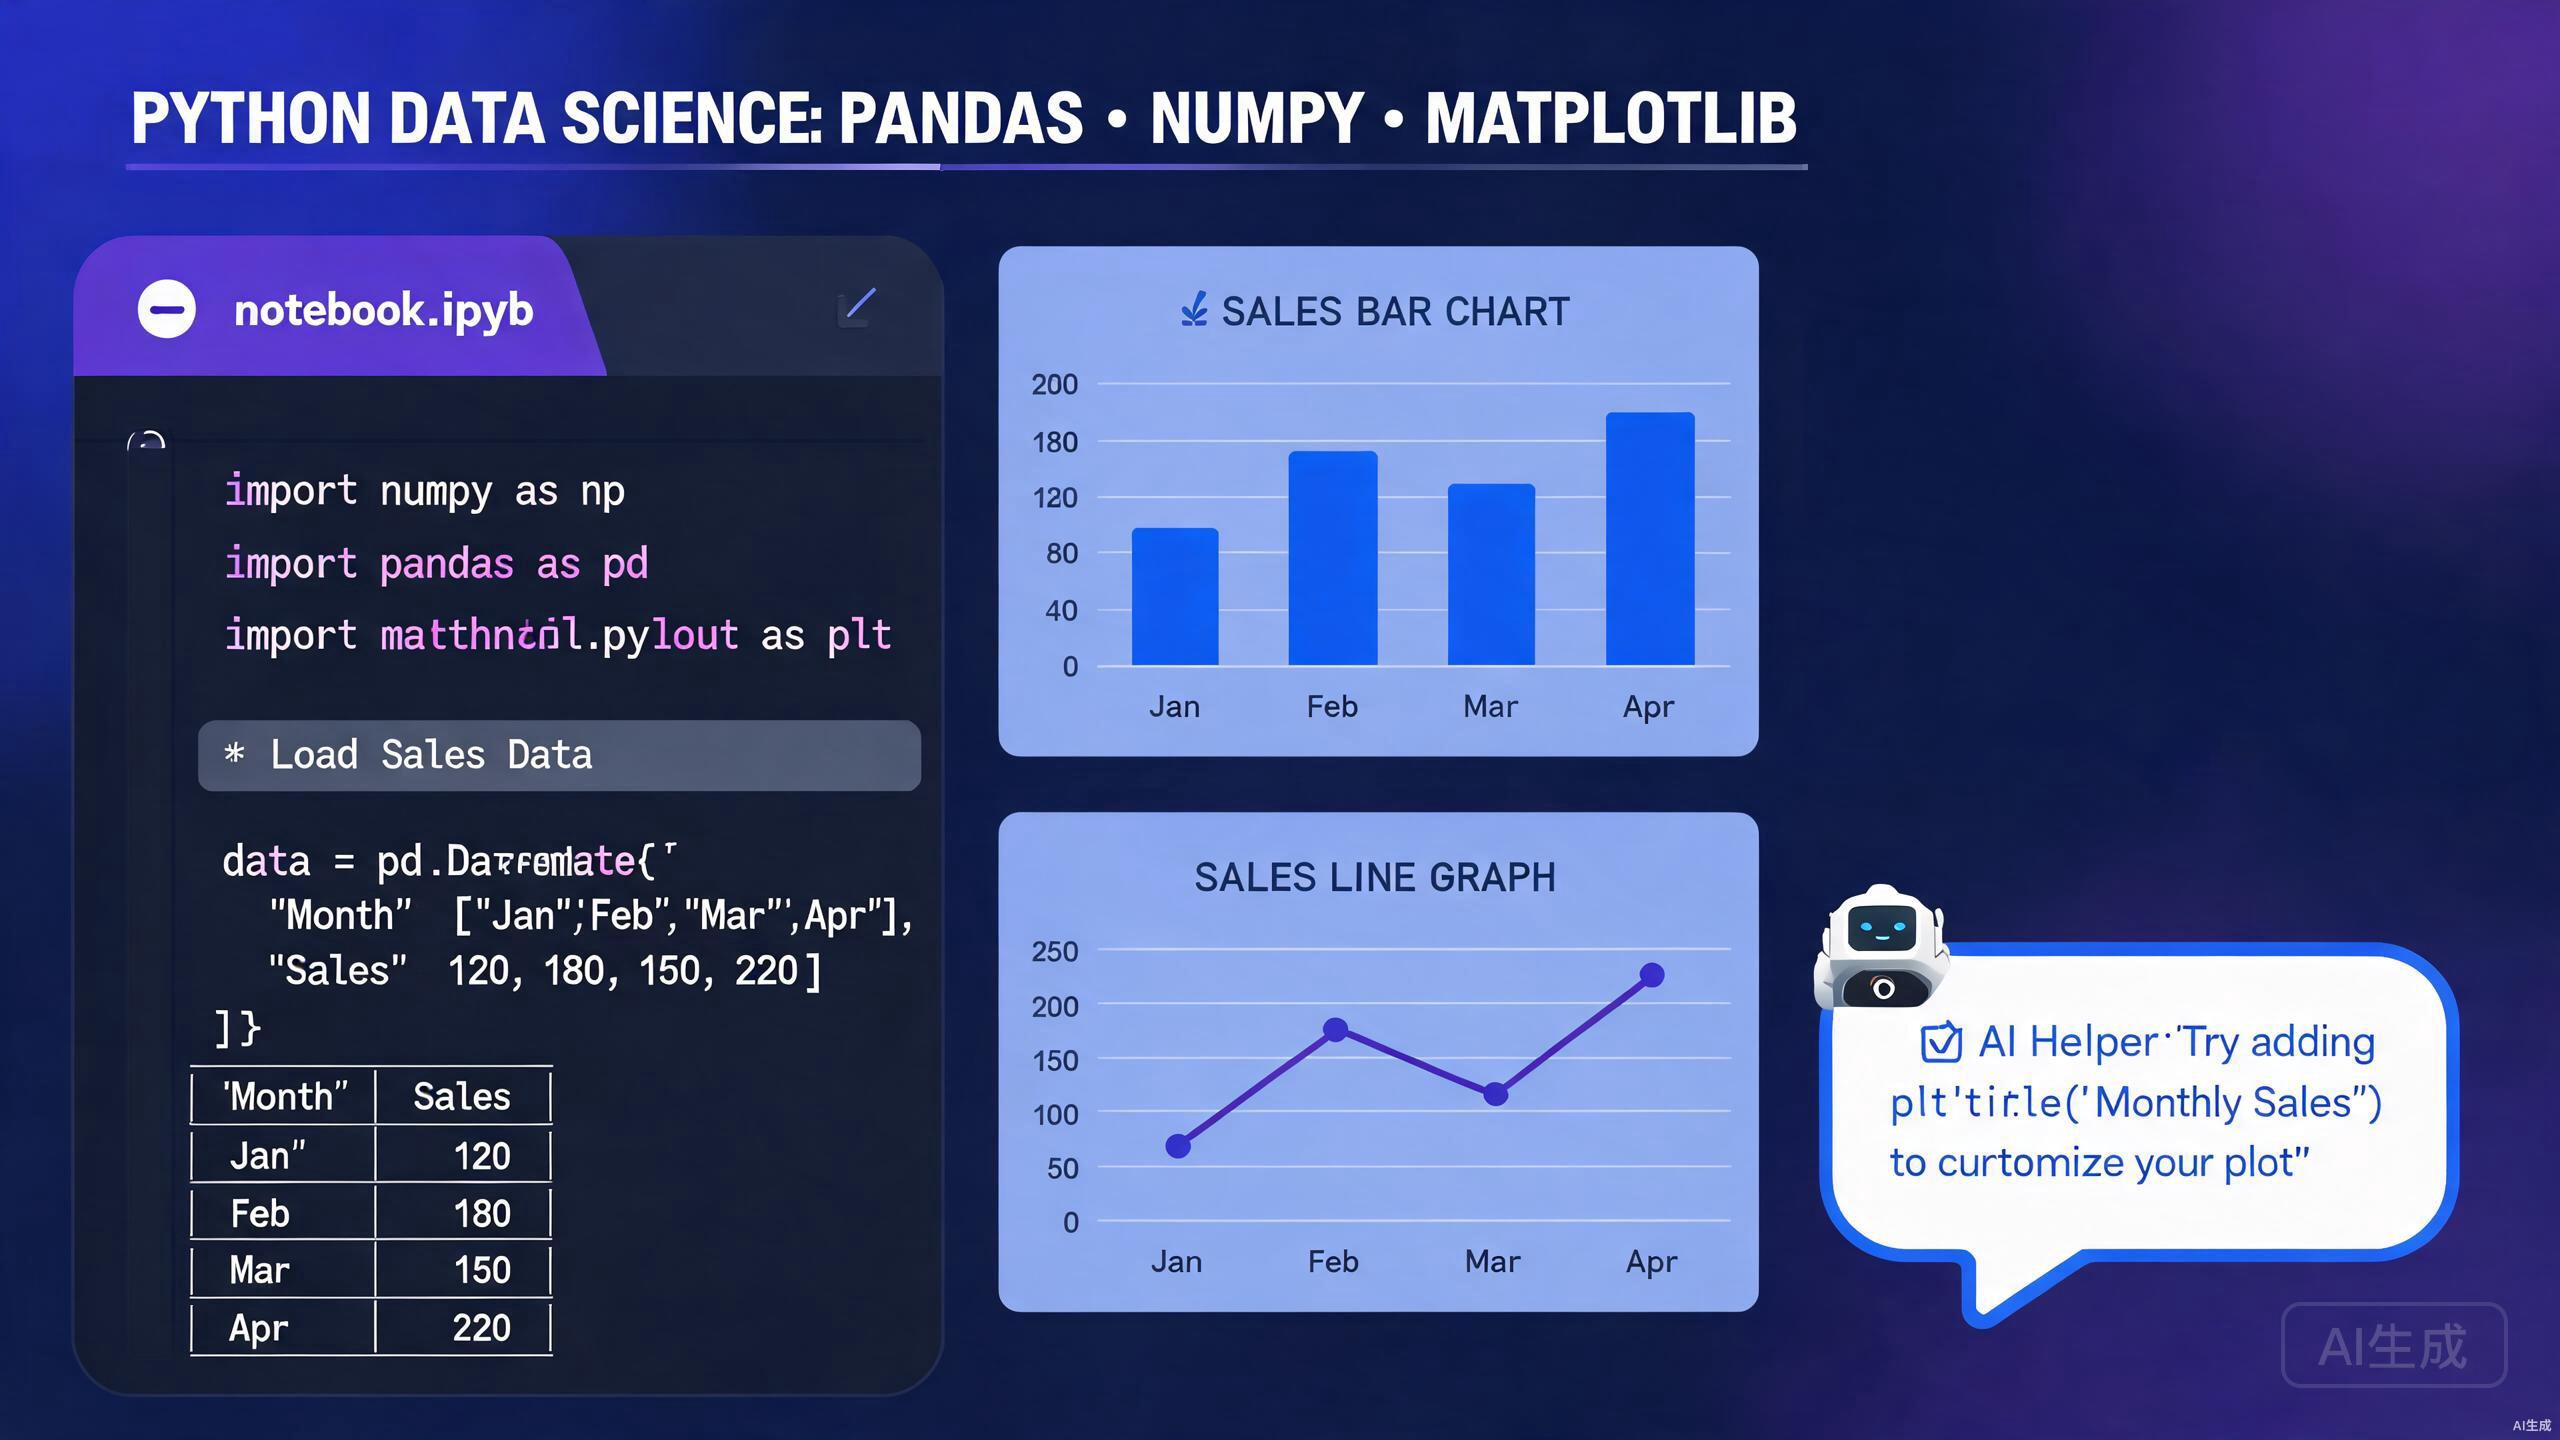
数据科学需要快速实验、强大的可视化和可重现的工作流。Cursor 通过将世界级代码编辑器与 AI 辅助分析、原生 Jupyter 支持和与 Python 数据科学栈的无缝集成,将这一切汇聚在一起。本指南引导您设置环境并利用 Cursor 的独特功能进行 pandas、NumPy、Matplotlib 及更多操作。
设置数据科学环境
可靠的 Python 环境是任何数据科学项目的基础。Cursor 通过集成终端支持和虚拟环境检测,使环境管理变得简单直接。
Python 安装和虚拟环境
在 Cursor 的终端中验证您的 Python 安装:
python --version
为您的项目创建专用虚拟环境:
python -m venv .venv
source .venv/bin/activate  # Windows 上: .venv\Scripts\activate
Cursor 自动检测工作区根目录中的 .venv 并提供将其选为活动解释器的选项。查看状态栏中的 Python 版本指示器。
安装核心数据科学库
使用 pip 安装必备栈:
pip install pandas numpy matplotlib seaborn scikit-learn jupyterlab
对于深度学习工作流,添加 PyTorch 或 TensorFlow:
pip install torch torchvision torchaudio
锁定依赖以确保可重现性:
pip freeze > requirements.txt
除非您了解依赖解析的影响,否则避免在同一环境中混合 conda 和 pip。每个项目坚持使用一个包管理器以防止冲突。
为 Python 配置 Cursor
在 Cursor 中安装官方 Python 扩展以获得 IntelliSense、代码检查和格式化。数据科学的推荐设置:
{
  "python.analysis.typeCheckingMode": "basic",
  "python.formatting.provider": "black",
  "python.linting.enabled": true,
  "python.linting.pylintEnabled": false,
  "python.linting.ruffEnabled": true,
  "jupyter.askForKernelRestart": false,
  "jupyter.interactiveWindow.creationMode": "perFile"
}
Cursor 中的 Jupyter 笔记本
Jupyter 笔记本是探索性数据分析的核心。Cursor 提供一流的笔记本支持,包括 AI 辅助、变量检查和导出功能。
创建和运行笔记本
通过命令面板(Ctrl+Shift+P)选择"Jupyter: Create New Jupyter Notebook"来创建新笔记本。Cursor 打开 .ipynb 文件,显示丰富的界面,内联显示代码单元格、Markdown 和输出。
从右上角下拉菜单选择您的内核。Cursor 自动列出所有可用的 Python 解释器和 conda 环境。
使用键盘快捷键加速笔记本工作流:Shift+Enter 运行当前单元格,A 在上方插入单元格,B 在下方插入单元格(命令模式下)。
AI 辅助单元格生成
在 Markdown 单元格中描述您的分析目标,然后让 Cursor 的 AI 生成相应的 Python 代码。例如:
## 目标:加载泰坦尼克数据集,用中位数插补处理缺失年龄,
## 并按乘客等级可视化存活率
Cursor 生成:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

df = pd.read_csv("titanic.csv")
df['Age'] = df['Age'].fillna(df['Age'].median())

plt.figure(figsize=(10, 6))
sns.barplot(data=df, x='Pclass', y='Survived', hue='Sex')
plt.title('Survival Rates by Passenger Class and Gender')
plt.ylabel('Survival Rate')
plt.show()
变量检查器和数据查看器
运行单元格后,使用变量窗格检查 DataFrame、数组和模型对象。点击 DataFrame 变量以打开类似电子表格的数据查看器,支持排序和过滤。这消除了重复调用 df.head() 的需要。
在数据查看器中打开大型 DataFrame 可能消耗大量内存。对于超过几百万行的数据集,请考虑在可视化检查前进行采样或聚合。
脚本与笔记本之间的转换
Cursor 支持将 .py 脚本转换为 .ipynb 笔记本,反之亦然。使用命令面板运行"Jupyter: Export Current Python File as Jupyter Notebook"。当您需要从实验过渡到生产就绪脚本时,这非常有用。
使用 Pandas 进行数据操作
Pandas 是 Python 数据操作的主力。Cursor 的自动补全和 AI 辅助使 DataFrame 操作更快且更少出错。
AI 生成的数据清洗流水线
数据清洗通常是重复性的。让 Cursor 从自然语言描述生成整个流水线:
# 清洗销售数据集:删除重复项、解析日期、
# 将列名标准化为 snake_case,并过滤掉负收入
Cursor 生成:
import pandas as pd

df = pd.read_csv("sales.csv")
df = df.drop_duplicates()
df['OrderDate'] = pd.to_datetime(df['OrderDate'], errors='coerce')
df.columns = df.columns.str.lower().str.replace(' ', '_')
df = df[df['revenue'] >= 0]
复杂转换和分组
对于多级分组和窗口函数等高级操作,Cursor 的内联建议非常出色:
monthly_stats = (
    df.groupby([df['order_date'].dt.to_period('M'), 'region'])
    .agg(
        total_revenue=('revenue', 'sum'),
        avg_order_value=('revenue', 'mean'),
        order_count=('order_id', 'nunique')
    )
    .reset_index()
)
编写复杂的 pandas 链时,使用括号将其拆分为多行。Cursor 能很好地格式化这些代码,并在每一步提供更好的自动补全。
策略性处理缺失数据
缺失数据需要领域知识。向 Cursor 询问针对您数据集的策略:
# 数值列:中位数插补
# 分类列:众数插补
# 日期时间列:前向填充

numeric_cols = df.select_dtypes(include=['number']).columns
categorical_cols = df.select_dtypes(include=['object']).columns
datetime_cols = df.select_dtypes(include=['datetime64']).columns

df[numeric_cols] = df[numeric_cols].fillna(df[numeric_cols].median())
df[categorical_cols] = df[categorical_cols].fillna(df[categorical_cols].mode().iloc[0])
df[datetime_cols] = df[datetime_cols].ffill()
使用 NumPy 进行数值计算
NumPy 为 Python 数据科学提供数值基础。Cursor 帮助您编写向量化的、高效的数组操作。
数组创建和操作
Cursor 的 NumPy 自动补全非常广泛。生成数组并执行转换:
import numpy as np

# 创建表示图像批次的 3D 数组
images = np.random.rand(32, 224, 224, 3)  # 批次、高度、宽度、通道

# 将像素值归一化到 [0, 1]
normalized = (images - images.min()) / (images.max() - images.min())

# 转置为不同库期望的格式
transposed = normalized.transpose(0, 3, 1, 2)  # NCHW 格式
广播和向量化
通过利用 NumPy 的广播避免 Python 循环。如果您不确定如何向量化操作,请向 Cursor 描述:
# 从质心计算欧几里得距离的向量化计算
centroid = np.array([5.0, 3.0])
points = np.random.rand(1000, 2)

distances = np.sqrt(np.sum((points - centroid) ** 2, axis=1))
NumPy 的隐式广播可能产生意外的形状。复杂操作后始终用 .shape 验证输出数组维度。
与 Pandas 集成
NumPy 函数与 pandas Series 和 DataFrame 无缝协作:
# 将 NumPy 通用函数应用于 DataFrame 列
df['log_revenue'] = np.log1p(df['revenue'])

# 复合条件的布尔索引
high_value = df[
    (np.abs(df['revenue'] - df['revenue'].mean()) > 2 * df['revenue'].std()) |
    (df['quantity'] > 100)
]
使用 Matplotlib 和 Seaborn 进行可视化
有效的可视化将数据转化为洞察。Cursor 的内联图表渲染和 AI 建议加速您的可视化工作流。
创建出版质量图表
Cursor 在笔记本中直接在代码单元格下方渲染 Matplotlib 图形。生成复杂的多面板图形:
import matplotlib.pyplot as plt
import seaborn as sns

fig, axes = plt.subplots(2, 2, figsize=(14, 10))

# 分布图
sns.histplot(data=df, x='revenue', kde=True, ax=axes[0, 0])
axes[0, 0].set_title('Revenue Distribution')

# 相关性热图
corr = df[['revenue', 'quantity', 'discount']].corr()
sns.heatmap(corr, annot=True, cmap='coolwarm', ax=axes[0, 1])
axes[0, 1].set_title('Feature Correlations')

# 按类别箱线图
sns.boxplot(data=df, x='category', y='revenue', ax=axes[1, 0])
axes[1, 0].set_title('Revenue by Category')

# 时间序列
monthly = df.groupby(df['order_date'].dt.to_period('M'))['revenue'].sum()
monthly.plot(ax=axes[1, 1], marker='o')
axes[1, 1].set_title('Monthly Revenue Trend')

plt.tight_layout()
plt.show()
以多种格式保存图形以用于不同用途:plt.savefig('figure.png', dpi=300) 用于演示,plt.savefig('figure.pdf') 用于出版物。
交互式可视化
对于仪表板和交互式探索,集成 Plotly:
import plotly.express as px

fig = px.scatter(
    df, x='quantity', y='revenue', color='category',
    size='discount', hover_data=['product_name'],
    title='Revenue vs Quantity by Category'
)
fig.show()
Cursor 在笔记本输出区域中交互式地渲染 Plotly 图表,支持缩放、平移和工具提示。
AI 建议的可视化
不确定使用哪种图表?询问 Cursor:
我有一个包含客户流失、使用期限和月费用的数据集。
哪些可视化最能揭示流失驱动因素?
根据您的分析上下文,Cursor 可能会建议 Kaplan-Meier 曲线、队列表或 SHAP 汇总图。
机器学习工作流
从预处理到模型评估,Cursor 通过 scikit-learn 及更多工具简化机器学习开发。
预处理和特征工程
使用 Cursor 生成完整的预处理流水线:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer

numeric_features = ['age', 'income', 'tenure']
categorical_features = ['gender', 'region', 'plan_type']

preprocessor = ColumnTransformer(
    transformers=[
        ('num', StandardScaler(), numeric_features),
        ('cat', OneHotEncoder(handle_unknown='ignore'), categorical_features)
    ]
)
模型训练和评估
Cursor 可以搭建训练循环和评估指标:
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)

y_pred = clf.predict(X_test)
print(classification_report(y_test, y_pred))
在任何预处理之前始终分离训练数据和测试数据。在整个数据集上拟合转换器会导致数据泄露和过于乐观的性能估计。
超参数调优
在 Cursor 的协助下生成超参数搜索网格:
from sklearn.model_selection import GridSearchCV

param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [None, 10, 20, 30],
    'min_samples_split': [2, 5, 10]
}

grid_search = GridSearchCV(
    RandomForestClassifier(random_state=42),
    param_grid,
    cv=5,
    scoring='f1_macro',
    n_jobs=-1
)
grid_search.fit(X_train, y_train)
print(f"Best parameters: {grid_search.best_params_}")
AI 驱动的数据分析
Cursor 的 AI 能力超越代码生成,扩展到统计推理和分析指导。
使用自然语言进行探索性数据分析
上传数据集并让 Cursor 执行 EDA:
分析 customer.csv 文件。向我展示客户终身价值的分布,
识别异常值,并建议用于定向营销的细分。
Cursor 生成计算描述性统计、可视化和聚类建议的一系列单元格。
自动洞察生成
对于时间序列数据,Cursor 可以建议分解、异常检测和预测:
from statsmodels.tsa.seasonal import seasonal_decompose

result = seasonal_decompose(df['sales'], model='multiplicative', period=12)
result.plot()
plt.show()
用 Markdown 记录分析
数据科学是协作性的。使用 Cursor 生成代码旁边发现结果的 Markdown 摘要:
## 主要发现

- **收入分布**:右偏,具有高价值交易的肥尾
- **季节性**:Q4 销售明显高峰,表明假日驱动需求
- **流失预测因素**:使用期限 < 6 个月且月费用 > 70 美元是最强指标
结论
Cursor 通过将交互式计算、AI 辅助和专业代码编辑融合到单一环境中,重新定义了 Python 数据科学。无论您是在 pandas 中清洗杂乱数据集、在 scikit-learn 中训练模型,还是在 Matplotlib 中制作可视化,Cursor 都能加速每一步。掌握 Jupyter 笔记本集成,利用 AI 生成样板代码,并始终验证您的分析假设。使用 Cursor,您的数据科学工作流变得更快速、更可重现,并与智能辅助深度集成。