Regex e Correspondência de Padrões no Cursor: Sintaxe, Grupos de Captura e Geração com IA
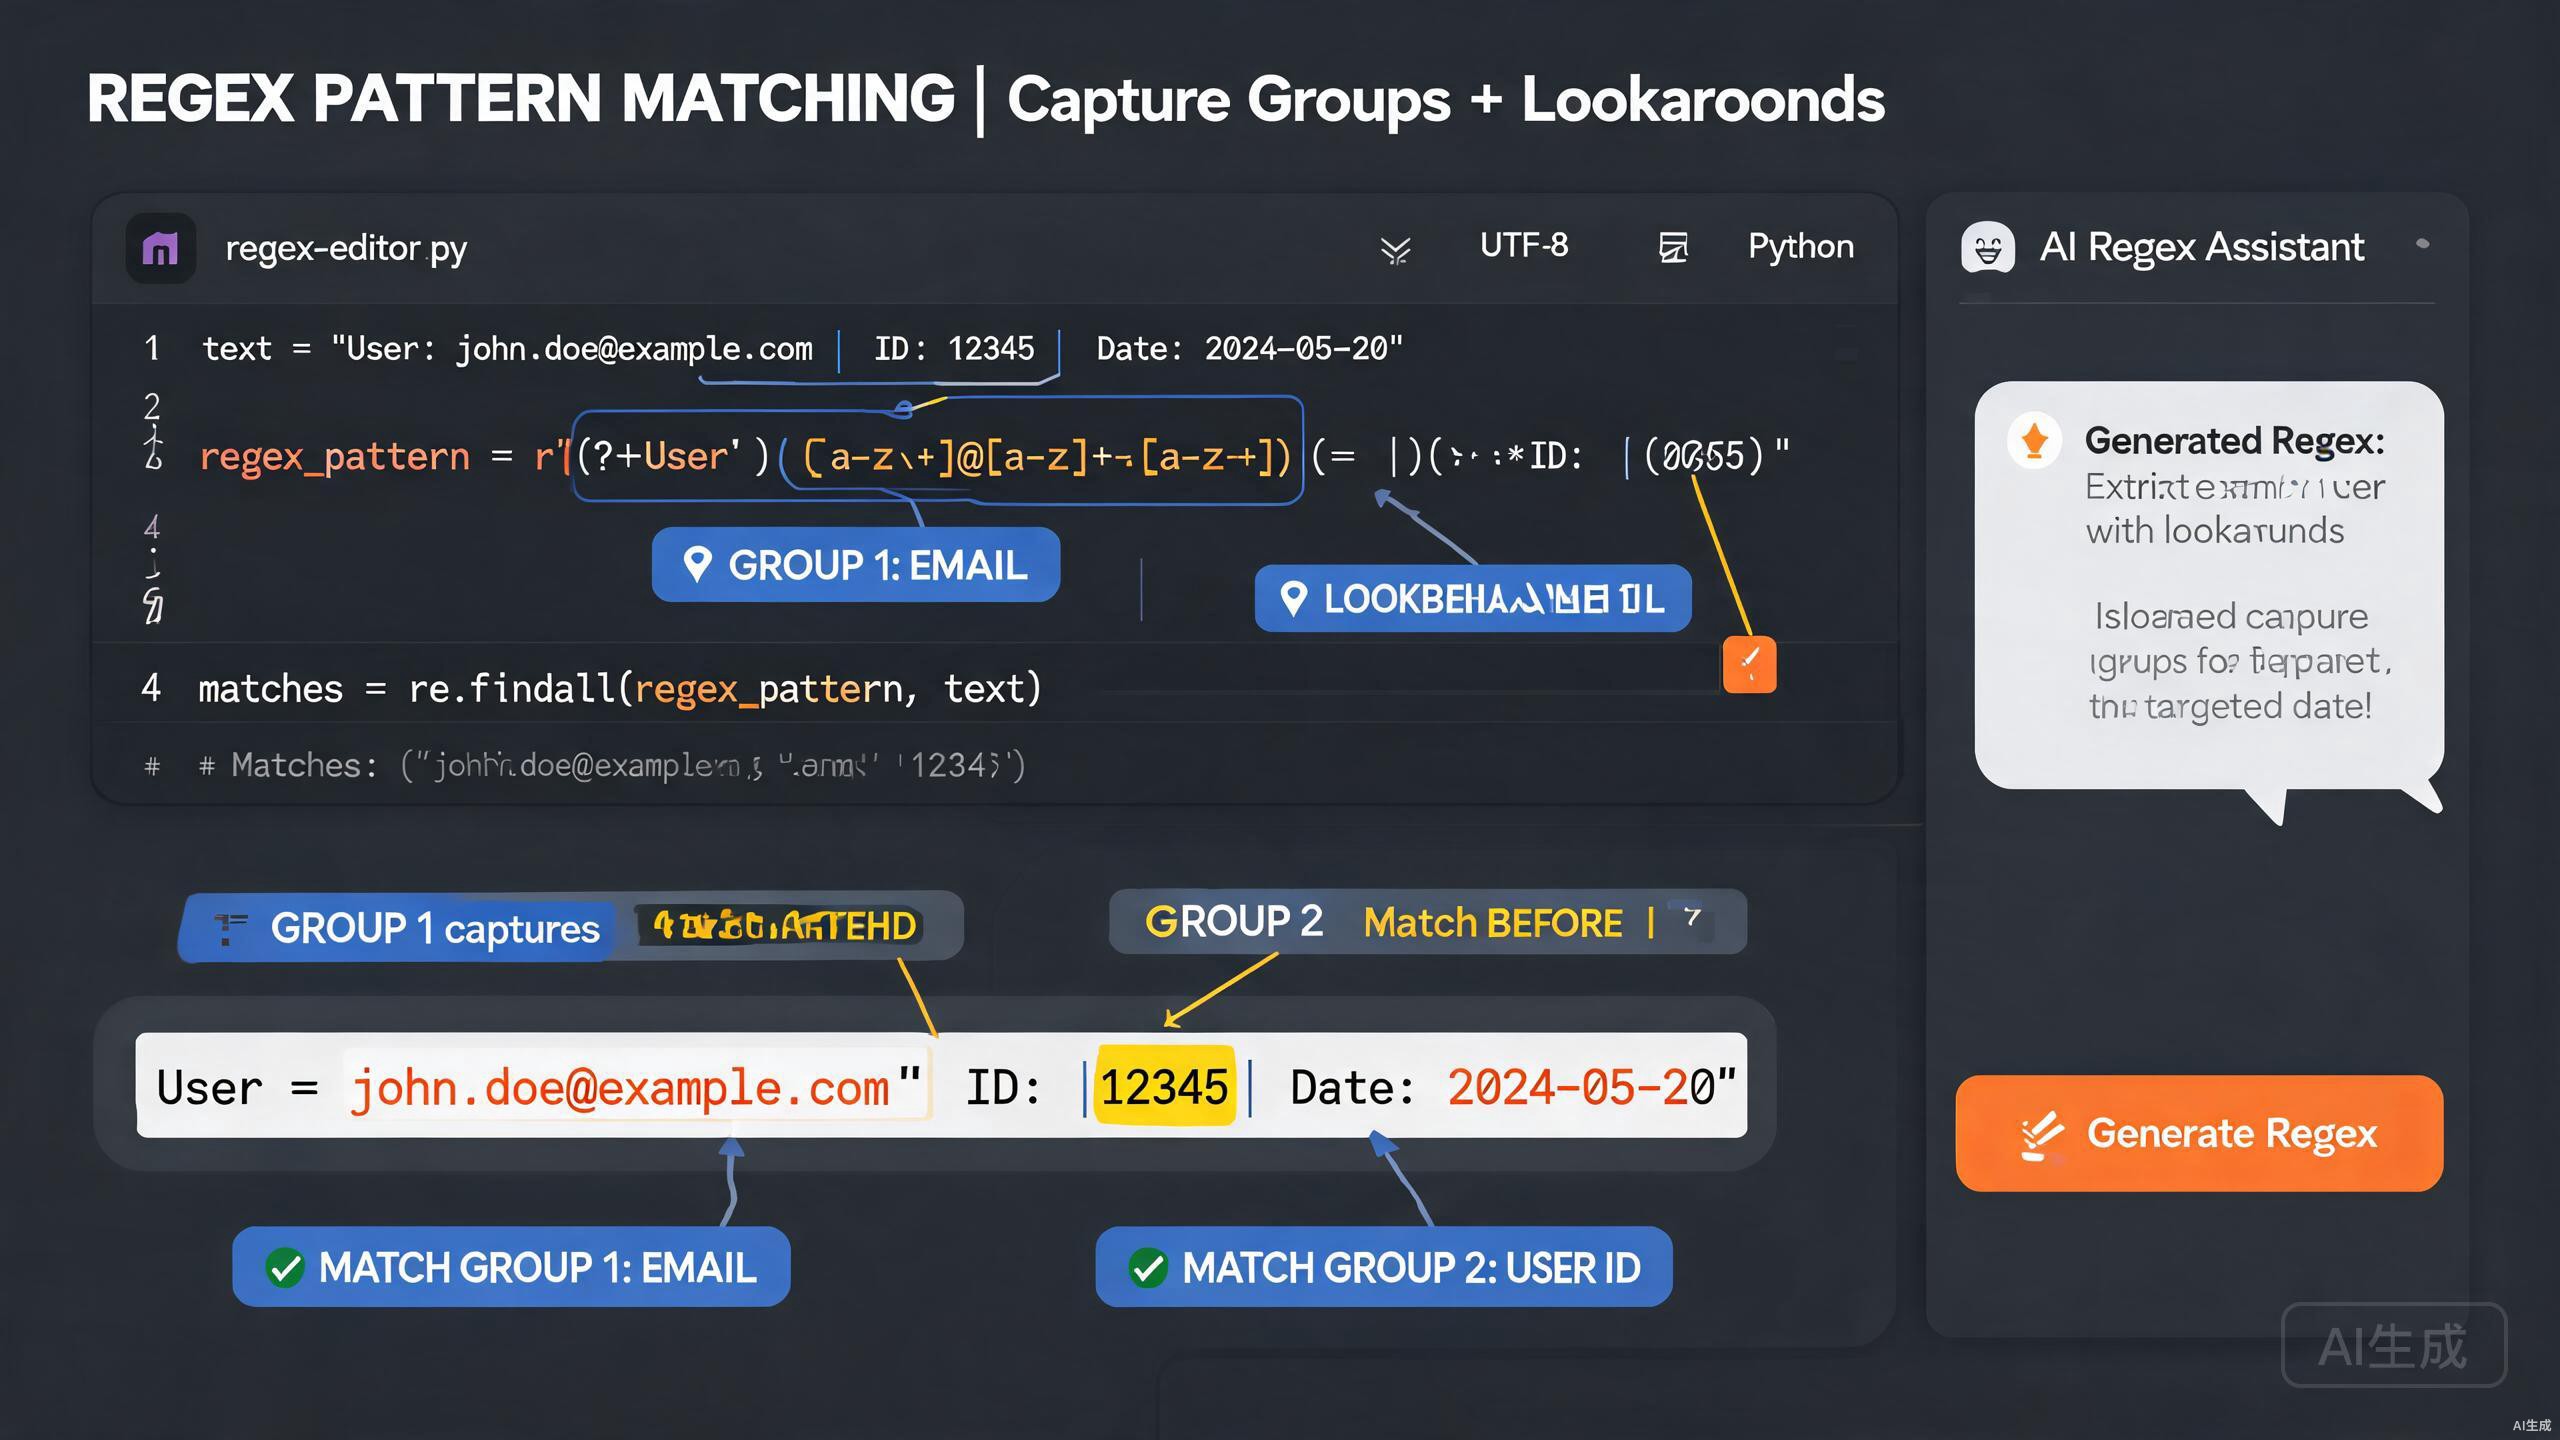
Expressões regulares (regex) são uma forma compacta e poderosa de corresponder, validar e extrair texto. Elas também são notoriamente difíceis de ler e fáceis de errar. O Cursor, um editor IDE com IA, torna o trabalho com regex muito mais acessível ao gerar padrões a partir de descrições em linguagem natural, explicar expressões crípticas e testá-las contra entradas de exemplo. Este guia aborda sintaxe regex, grupos de captura, asserções lookahead e lookbehind, geração de regex com IA e uma biblioteca de padrões comuns de validação.
Pré-requisitos
Antes de começar, certifique-se de ter o seguinte:
- Cursor (versão mais recente recomendada) como seu editor IDE
- Um ambiente de programação com um motor regex (JavaScript, Python ou Rust)
- Familiaridade básica com conceitos de manipulação de strings
A IA do Cursor é excelente para explicar e gerar regex, mas não substitui a compreensão dos fundamentos. Sempre revise os padrões gerados em relação aos seus casos de teste, porque os motores regex diferem ligeiramente entre linguagens. Um padrão que funciona em JavaScript pode se comportar de forma diferente em Python ou Rust.
Fundamentos da Sintaxe Regex
Compreender os blocos de construção do regex permite que você leia e depure padrões com confiança. O Cursor pode explicar qualquer padrão, mas conhecer o vocabulário ajuda você a escrever melhores prompts.
Caracteres e Metacaracteres
Aqui estão os blocos de construção principais do regex:
| Construto | Significado |
|---|---|
. | Qual caractere exceto nova linha |
\d | Um dígito (0 a 9) |
\w | Um caractere de palavra (letra, dígito, sublinhado) |
\s | Espaço em branco (espaço, tab, nova linha) |
\D, \W, \S | Versões negadas dos acima |
^ | Início da string (ou linha em modo multiline) |
$ | Fim da string (ou linha em modo multiline) |
\b | Limite de palavra |
Quantificadores
Quantificadores controlam quantas vezes um token pode se repetir:
| Quantificador | Significado |
|---|---|
* | Zero ou mais |
+ | Um ou mais |
? | Zero ou um |
{n} | Exatamente n |
{n,} | n ou mais |
{n,m} | Entre n e m |
Classes de Caracteres e Alternância
Colchetes definem um conjunto de caracteres permitidos, e o pipe define alternativas:
const vowelPattern = /[aeiou]/;       // qualquer vogal única
const hexPattern = /[0-9a-fA-F]/;     // qualquer dígito hex
const colorPattern = /red|green|blue/; // uma de três palavras
Gerando um Primeiro Padrão
Peça ao Cursor para gerar um padrão a partir de uma descrição:
Escreva um regex que corresponde a um número de telefone dos EUA
no formato (XXX) XXX-XXXX onde X é um dígito. Adicione grupos de
captura nomeados para o código de área e o número local.
Explique cada parte.
O Cursor retorna o padrão com uma explicação:
// Pattern: /^\((?<areaCode>\d{3})\) (?<localNumber>\d{3}-\d{4})$/
const phonePattern = /^\((?<areaCode>\d{3})\) (?<localNumber>\d{3}-\d{4})$/;

const match = '(555) 123-4567'.match(phonePattern);
console.log(match.groups.areaCode);     // "555"
console.log(match.groups.localNumber);   // "123-4567"
O Cursor explica: \( corresponde a um parêntese de abertura literal, \d{3} corresponde a exatamente três dígitos, (?<areaCode>...) é um grupo de captura nomeado, e \) corresponde ao parêntese de fechamento.
Parênteses têm dois significados em regex: agrupamento e captura. Para agrupar sem capturar, use (?:...). Esquecer o ?: cria grupos de captura desnecessários que podem deslocar seus índices de grupo e causar bugs sutis de off-by-one quando você indexa grupos por número.
Grupos de Captura e Retroreferências
Grupos de captura permitem extrair partes de uma correspondência e reutilizá-las mais tarde no padrão. O Cursor gera e refina grupos de captura com precisão.
Grupos de Captura Numerados
// Extrair componentes de data de YYYY-MM-DD
const datePattern = /(\d{4})-(\d{2})-(\d{2})/;
const match = '2025-08-17'.match(datePattern);
console.log(match[1]); // ano: "2025"
console.log(match[2]); // mês: "08"
console.log(match[3]); // dia: "17"
Grupos de Captura Nomeados
Grupos nomeados são muito mais legíveis do que numerados, especialmente em padrões longos. Peça ao Cursor para converter um padrão:
Converta este regex para usar grupos de captura nomeados em vez de numerados:
/(\d{4})-(\d{2})-(\d{2})T(\d{2}):(\d{2}):(\d{2})/
O Cursor o reescreve:
const isoPattern = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})T(?<hour>\d{2}):(?<minute>\d{2}):(?<second>\d{2})/;
const m = '2025-08-17T14:30:00'.match(isoPattern);
console.log(m.groups.year, m.groups.month, m.groups.day); // "2025" "08" "17"
Retroreferências
Retroreferências permitem que um padrão corresponda ao mesmo texto que um grupo anterior capturou. Um exemplo clássico é corresponder palavras repetidas:
// Encontrar palavras duplicadas como "the the"
const doubledWord = /\b(\w+)\s+\1\b/gi;
const text = 'I went to the the store and bought a a apple.';
console.log(text.replace(doubledWord, '$1'));
// "I went to the store and bought a apple."
O \1 refere-se a qualquer coisa que o primeiro grupo de captura correspondeu, então o padrão só é bem-sucedido quando a segunda palavra é idêntica à primeira.
Grupos Não Capturadores
Quando você precisa de agrupamento para alternância ou quantificadores, mas não precisa do texto capturado, use um grupo não capturador para evitar poluir o array de correspondências:
// Corresponder "color" ou "colour" sem capturar o "u" opcional
const colorPattern = /colou?r/;
const ukPattern = /col(?:ou)?r/; // variante não capturadora
Peça ao Cursor para auditar um regex complexo em busca de grupos de captura desnecessários. Solicite: "Encontre grupos de captura neste padrão que não são usados e converta-os em grupos não capturadores." Grupos mais limpos tornam seu código mais previsível e ligeiramente mais rápido.
Lookahead e Lookbehind
Lookahead e lookbehind são asserções de largura zero que verificam o contexto sem consumir caracteres. Elas são essenciais para validação sem extração.
Lookahead Positivo
Lookahead positivo (?=...) afirma que o que segue corresponde sem incluí-lo no resultado. Um uso comum é validação de senhas:
// Mínimo 8 caracteres, uma maiúscula, um dígito
const strongPassword = /^(?=.*[A-Z])(?=.*\d).{8,}$/;
console.log(strongPassword.test('Abcdefg1')); // true
console.log(strongPassword.test('password')); // false
Cada (?=...) verifica uma condição a partir do início da string, então .{8,} corresponde aos caracteres reais da senha.
Lookahead Negativo
Lookahead negativo (?!...) afirma que o que segue não corresponde:
// Corresponder "java" não seguido de "script"
const javaNotScript = /\bjava(?!script)\b/i;
console.log(javaNotScript.test('I love java'));           // true
console.log(javaNotScript.test('I love javascript'));     // false
Lookbehind Positivo e Negativo
Lookbehind (?<=...) e (?<!...) verificam o que precede a posição atual. Use-os para extrair correspondências dependentes de contexto:
// Extrair valores em dólar após o sinal $
const pricePattern = /(?<=\$)\d+(\.\d{2})?/g;
console.log('$19.99 and $5'.match(pricePattern)); // ["19.99", "5"]

// Corresponder "cat" não precedido de "wild "
const domesticCat = /(?<!wild )cat\b/;
console.log(domesticCat.test('my cat'));         // true
console.log(domesticCat.test('a wild cat'));      // false
O suporte a lookbehind varia entre motores. JavaScript adicionou lookbehind no ES2018, então navegadores e runtimes mais antigos rejeitam padrões com (?<=...). O crate regex do Rust não suporta lookbehind de forma alguma. Se você almeja Rust, peça ao Cursor para reescrever padrões lookbehind sem ele, geralmente capturando o contexto precedente em um grupo.
Gerando Padrões Sensíveis ao Contexto
Peça ao Cursor para construir um padrão com asserções:
Escreva um regex que corresponde a cada palavra em uma frase exceto
as palavras "the", "a" e "an". Use lookahead negativo e limites de
palavra. Forneça casos de teste.
O Cursor retorna:
const contentWord = /\b(?!the\b|a\b|an\b)\b[a-z]+/gi;
const sentence = 'the quick brown fox jumps over a lazy dog';
console.log(sentence.match(contentWord));
// ["quick", "brown", "fox", "jumps", "over", "lazy", "dog"]
Geração de Regex com IA
A capacidade de destaque do Cursor é transformar requisitos em linguagem natural em regex testado. Esta seção mostra fluxos de trabalho práticos.
Gerando a Partir de uma Especificação
Descreva suas regras de correspondência em detalhes, incluindo casos extremos:
Gere um regex que valida uma string de versão semver com uma
tag de pré-lançamento opcional. Requisitos:
- Major, minor e patch são inteiros não negativos sem zeros à esquerda
- Pré-lançamento é opcional, separado por um hífen
- Pré-lançamento pode conter identificadores alfanuméricos separados por ponto
- Exemplos: 1.0.0, 2.14.3-alpha, 3.0.0-beta.1, 0.0.1-rc.2.exp
- Inválidos: 01.0.0, 1.0, 1.0.0-, 2.x.3
O Cursor produz um padrão bem comentado:
// Major: 0 or [1-9]\d*
// Minor and Patch: same as Major
// Prerelease: -(identifier)(.identifier)* where identifier = [0-9A-Za-z-]+
const semverPattern = /^(0|[1-9]\d*)\.(0|[1-9]\d*)\.(0|[1-9]\d*)(?:-([0-9A-Za-z-]+(?:\.[0-9A-Za-z-]+)*))?$/;

const tests = [
  ['1.0.0', true],
  ['2.14.3-alpha', true],
  ['3.0.0-beta.1', true],
  ['0.0.1-rc.2.exp', true],
  ['01.0.0', false],
  ['1.0', false],
  ['1.0.0-', false],
  ['2.x.3', false],
];

tests.forEach(([input, expected]) => {
  console.log(input, semverPattern.test(input) === expected ? 'PASS' : 'FAIL');
});
Explicando Padrões Crípticos
Cole um regex que você encontrou online e peça ao Cursor para explicá-lo:
Explique este regex e reescreva-o com comentários e grupos nomeados:
/^(?:(?:25[0-5]|2[0-4]\d|[01]?\d\d?)\.){3}(?:25[0-5]|2[0-4]\d|[01]?\d\d?)$/
O Cursor o decompõe:
// Validador de endereço IPv4
// Cada octeto corresponde a: 0-9 | 00-99 | 100-199 | 200-249 | 250-255
const octet = '(?:25[0-5]|2[0-4]\\d|[01]?\\d\\d?)';
const ipv4Pattern = new RegExp(`^(?:${octet}\\.){3}${octet}$`);

// Com grupos nomeados para legibilidade
const ipv4Named = /^(?<o1>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o2>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o3>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o4>25[0-5]|2[0-4]\d|[01]?\d\d?)$/;
const m = '192.168.1.1'.match(ipv4Named);
console.log(m.groups); // { o1: "192", o2: "168", o3: "1", o4: "1" }
O Cursor explica que 25[0-5] corresponde a 250 a 255, 2[0-4]\d corresponde a 200 a 249, e [01]?\d\d? corresponde a 0 a 199.
Depurando Padrões Com Falha
Quando um regex não corresponde como esperado, descreva o problema:
Meu regex /^\d{4}-\d{2}-\d{2}$/ deveria corresponder a "2025-08-17"
mas minha função retorna null. Aqui está meu código. Encontre o bug.
O Cursor identifica erros comuns como uma flag g ausente, um objeto regex global reutilizado entre chamadas, ou um problema de caractere escapado, e explica a correção.
Padrões Comuns de Validação
O Cursor pode gerar uma biblioteca reutilizável de padrões validados. Aqui está uma coleção prática.
Validação de Email
// Validação pragmática de email (regex totalmente em conformidade com RFC 5322 é impraticável)
const emailPattern = /^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$/;
console.log(emailPattern.test('invalid@@test')); // false
Não valide excessivamente endereços de email com regex. A única verificação confiável é enviar um email de confirmação. Use um regex permissivo para capturar erros óbvios de digitação, então verifique a entregabilidade. Peça ao Cursor: "Escreva um regex de email permissivo e uma função que também verifica se o registro MX existe," para uma abordagem equilibrada.
Validação de URL
const urlPattern = /^https?:\/\/(www\.)?[-a-zA-Z0-9@:%._+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9@:%_+.~#?&//=]*)$/;
console.log(urlPattern.test('https://www.example.com/path?q=1')); // true
Validação de Slug
// Slug seguro para URL: letras minúsculas, dígitos, hífens, sem hífen inicial ou final
const slugPattern = /^[a-z0-9]+(?:-[a-z0-9]+)*$/;
console.log(slugPattern.test('how-to-use-cursor')); // true
console.log(slugPattern.test('-invalid-slug'));     // false
Cor Hexadecimal
// Hex de 3 ou 6 dígitos com # opcional
const hexPattern = /^#?([0-9a-fA-F]{3}|[0-9a-fA-F]{6})$/;
console.log(hexPattern.test('#fff'));  // true
console.log(hexPattern.test('FF5733')); // true
Senha Forte
// Mínimo 8 caracteres, pelo menos uma maiúscula, minúscula, dígito e símbolo
const passwordPattern = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[^A-Za-z0-9]).{8,}$/;
console.log(passwordPattern.test('Curs0r!de')); // true
Extraindo e Substituindo Texto
Regex não é apenas para validação; ele se destaca em extração e transformação.
Extraindo Todas as Correspondências
// Extrair todas as hashtags de um post de rede social
const hashtagPattern = /#[\w]+/g;
const post = 'Loving #Cursor IDE and #regex today! #coding';
console.log(post.match(hashtagPattern)); // ["#Cursor", "#regex", "#coding"]
Transformando com Replace e Grupos de Captura
// Converter kebab-case para camelCase
const kebabToCamel = /-([a-z])/g;
const result = 'font-size-in-cursor'.replace(kebabToCamel, (_, c) => c.toUpperCase());
console.log(result); // "fontSizeInCursor"
Templates com Grupos Nomeados
// Substituir placeholders {{ var }} por valores de um objeto de contexto
const templatePattern = /{{\s*(?<key>\w+)\s*}}/g;
function render(template, context) {
  return template.replace(templatePattern, (_, key) => context[key] ?? '');
}
console.log(render('Hello {{ name }}, you have {{ count }} tasks', { name: 'Sam', count: 3 }));
// "Hello Sam, you have 3 tasks"
A função de replace do regex executa a substituição para cada correspondência. Se seu objeto de contexto for grande e seu template estiver em um caminho crítico, pré-compile o padrão e armazene em cache a busca de contexto. Também proteja contra valores undefined para evitar que a string literal "undefined" apareça na sua saída.
Desempenho e Segurança
Regex mal escrito pode causar backtracking catastrófico, onde o motor leva tempo exponencial em certas entradas. Isso é um risco real de segurança (ReDoS).
Detectando Backtracking Catastrófico
Peça ao Cursor para analisar um padrão:
Verifique este regex quanto a risco de backtracking catastrófico
(ReDoS) e reescreva-o de forma segura: /^(a+)+$/
O Cursor explica que quantificadores aninhados como (a+)+ criam backtracking exponencial em entradas como aaaaaaaaaaaaaaaaaaaa!, então fornece uma alternativa segura:
// Alternativa segura: quantificador único ancorado
const safePattern = /^a+$/;
Usando Âncoras e Grupos Atômicos
Sempre ancorar padrões quando você espera que a string completa corresponda. Quando suportado, use grupos atômicos (?>...) para evitar backtracking:
// Equivalente ao quantificador possessivo em JS (sem suporte nativo, use truque de lookahead)
const possessiveDigit = /(?=(\d++))\1/;
Para entrada não confiável, sempre defina um tempo limite na execução do regex ou use uma biblioteca que suporte execução limitada. Peça ao Cursor: "Adicione um wrapper de timeout à minha função de teste de regex usando um Web Worker," para impedir que uma entrada maliciosa congele sua aplicação.
Resumo de Melhores Práticas
Mantenha estes princípios em mente ao trabalhar com regex no Cursor:
- Prefira grupos de captura nomeados em vez de numerados para legibilidade.
- Use grupos não capturadores
(?:...)quando não precisar do texto capturado. - Ancore seus padrões com
^e$ao validar strings completas. - Escape caracteres especiais ao interpolar entrada do usuário em um padrão.
- Teste contra casos positivos e negativos para detectar condições extremas.
- Cuidado com backtracking catastrófico em padrões com quantificadores aninhados.
- Adicione comentários a padrões complexos usando a flag
xou grupos nomeados.
Ao combinar fundamentos sólidos de regex com a geração e explicação com IA do Cursor, você pode escrever, testar e manter código de correspondência de padrões com confiança. Descreva sua intenção claramente, deixe o Cursor produzir e explicar o padrão, então valide-o contra um conjunto completo de casos de teste antes de publicar.