Cursor での正規表現とパターンマッチング:構文、キャプチャグループ、AI支援生成
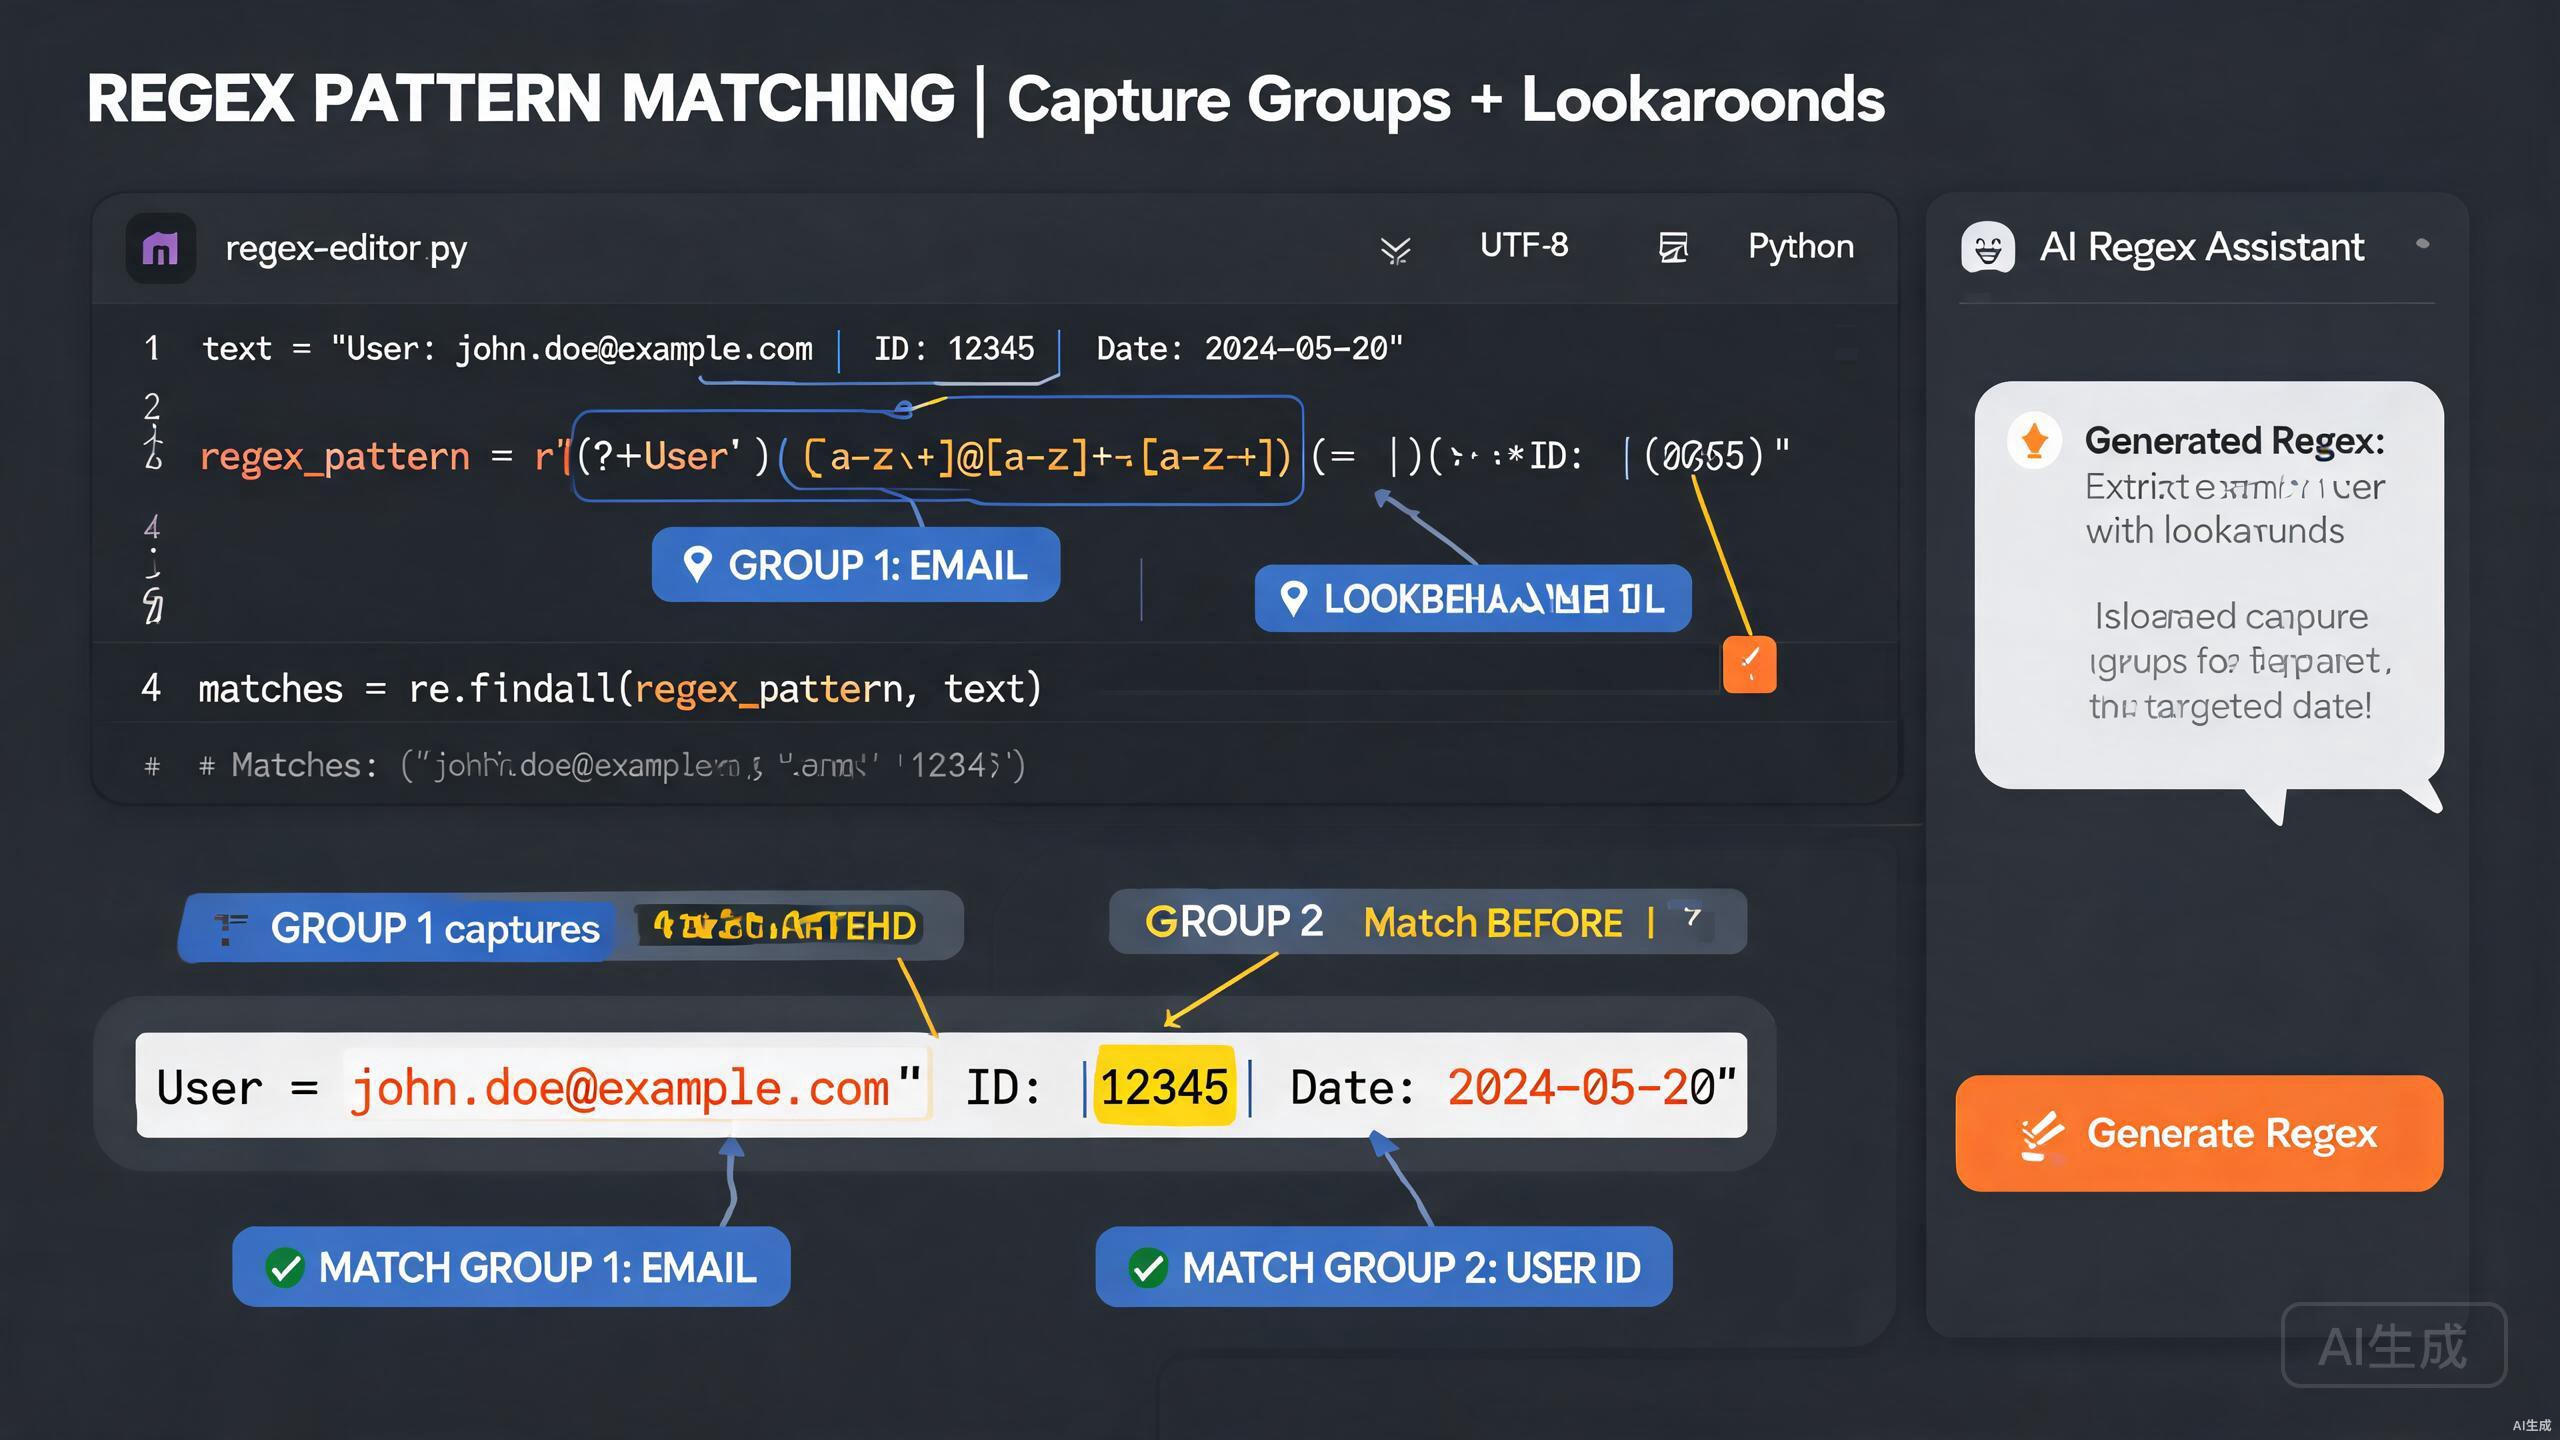
正規表現(regex)は、テキストのマッチング、検証、抽出を行うためのコンパクトで強力な方法です。しかし、読みにくく間違えやすいことでも有名です。AI駆動の IDE エディタである Cursor は、平易な英語の記述からパターンを生成し、難解な表現を説明し、サンプル入力に対してテストすることで、正規表現の操作をはるかに扱いやすくします。このガイドは、正規表現の構文、キャプチャグループ、先読みと後読みのアサーション、AI支援の正規表現生成、一般的な検証パターンのライブラリをカバーします。
前提条件
始める前に、以下のものを用意してください:
- IDE エディタとしての Cursor(最新バージョンを推奨)
- 正規表現エンジンを持つプログラミング環境(JavaScript、Python、または Rust)
- 文字列操作の概念に関する基本的な知識
Cursor の AI は正規表現の説明と生成に優れていますが、基礎の理解の代わりにはなりません。正規表現エンジンは言語によってわずかに異なるため、生成されたパターンは常にテストケースで確認してください。JavaScript で動作するパターンが Python や Rust では異なる動作をする場合があります。
正規表現の構文の基礎
正規表現の構成要素を理解することで、パターンを自信を持って読み、デバッグできます。Cursor は任意のパターンを説明できますが、用語を知っていればより良いプロンプトを書けます。
文字とメタ文字
以下はコアとなる正規表現の構成要素です:
| 構成要素 | 意味 |
|---|---|
. | 改行以外の任意の文字 |
\d | 数字(0 から 9) |
\w | 単語文字(文字、数字、アンダースコア) |
\s | 空白文字(スペース、タブ、改行) |
\D, \W, \S | 上記の否定版 |
^ | 文字列の先頭(複数行モードでは行頭) |
$ | 文字列の末尾(複数行モードでは行末) |
\b | 単語境界 |
量指定子
量指定子はトークンが繰り返せる回数を制御します:
| 量指定子 | 意味 |
|---|---|
* | 0回以上 |
+ | 1回以上 |
? | 0回または1回 |
{n} | 正確に n 回 |
{n,} | n 回以上 |
{n,m} | n 回から m 回 |
文字クラスと選択
角括弧は許可される文字のセットを定義し、パイプは選択肢を定義します:
const vowelPattern = /[aeiou]/;       // any single vowel
const hexPattern = /[0-9a-fA-F]/;     // any hex digit
const colorPattern = /red|green|blue/; // one of three words
最初のパターンの生成
Cursor に記述からパターンの生成を依頼します:
Write a regex that matches a US phone number in the format (XXX) XXX-XXXX
where X is a digit. Add named capture groups for the area code and the
local number. Explain each part.
Cursor は説明付きのパターンを返します:
// Pattern: /^\((?<areaCode>\d{3})\) (?<localNumber>\d{3}-\d{4})$/
const phonePattern = /^\((?<areaCode>\d{3})\) (?<localNumber>\d{3}-\d{4})$/;

const match = '(555) 123-4567'.match(phonePattern);
console.log(match.groups.areaCode);     // "555"
console.log(match.groups.localNumber);   // "123-4567"
Cursor は説明します:\( はリテラルの開き括弧にマッチし、\d{3} は正確に3桁の数字にマッチし、(?<areaCode>...) は名前付きキャプチャグループで、\) は閉じ括弧にマッチします。
正規表現の括弧には2つの意味があります:グループ化とキャプチャです。キャプチャせずにグループ化するには、(?:...) を使用します。?: を忘れると不要なキャプチャグループが作成され、グループインデックスがずれて、番号でグループをインデックスする時に微妙なオフバイワンバグを引き起こす可能性があります。
キャプチャグループと後方参照
キャプチャグループを使用すると、マッチした部分を抽出し、パターンの後で再利用できます。Cursor はキャプチャグループを正確に生成し、洗練させます。
番号付きキャプチャグループ
// Extract date components from YYYY-MM-DD
const datePattern = /(\d{4})-(\d{2})-(\d{2})/;
const match = '2025-08-17'.match(datePattern);
console.log(match[1]); // year: "2025"
console.log(match[2]); // month: "08"
console.log(match[3]); // day: "17"
名前付きキャプチャグループ
名前付きグループは番号付きグループよりもはるかに読みやすく、特に長いパターンではそうです。Cursor にパターンの変換を依頼します:
Convert this regex to use named capture groups instead of numbered ones:
/(\d{4})-(\d{2})-(\d{2})T(\d{2}):(\d{2}):(\d{2})/
Cursor は書き直します:
const isoPattern = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})T(?<hour>\d{2}):(?<minute>\d{2}):(?<second>\d{2})/;
const m = '2025-08-17T14:30:00'.match(isoPattern);
console.log(m.groups.year, m.groups.month, m.groups.day); // "2025" "08" "17"
後方参照
後方参照を使用すると、パターンが以前のグループがキャプチャしたものと同じテキストにマッチできます。古典的な例は繰り返し単語のマッチングです:
// Find doubled words like "the the"
const doubledWord = /\b(\w+)\s+\1\b/gi;
const text = 'I went to the the store and bought a a apple.';
console.log(text.replace(doubledWord, '$1'));
// "I went to the store and bought a apple."
\1 は最初のキャプチャグループがマッチしたものを参照するため、2番目の単語が最初の単語と同じ場合にのみパターンが成功します。
非キャプチャグループ
選択や量指定子のためにグループ化が必要だが、キャプチャしたテキストが不要な場合は、マッチ配列を汚染しないように非キャプチャグループを使用します:
// Match "color" or "colour" without capturing the optional "u"
const colorPattern = /colou?r/;
const ukPattern = /col(?:ou)?r/; // non-capturing variant
Cursor に複雑な正規表現の不要なキャプチャグループの監査を依頼します。プロンプト:「このパターンで使用されていないキャプチャグループを見つけて、非キャプチャグループに変換して。」クリーンなグループにより、コードがより予測可能でわずかに高速になります。
先読みと後読み
先読みと後読みは、文字を消費せずにコンテキストをチェックするゼロ幅アサーションです。抽出を伴わない検証に不可欠です。
肯定先読み
肯定先読み (?=...) は、後に続くものがマッチすることを結果に含めずにアサートします。一般的な用途はパスワード検証です:
// At least 8 chars, one uppercase, one digit
const strongPassword = /^(?=.*[A-Z])(?=.*\d).{8,}$/;
console.log(strongPassword.test('Abcdefg1')); // true
console.log(strongPassword.test('password')); // false
各 (?=...) は文字列の先頭から条件をチェックし、.{8,} が実際のパスワード文字にマッチします。
否定先読み
否定先読み (?!...) は、後に続くものがマッチしないことをアサートします:
// Match "java" not followed by "script"
const javaNotScript = /\bjava(?!script)\b/i;
console.log(javaNotScript.test('I love java'));           // true
console.log(javaNotScript.test('I love javascript'));     // false
肯定および否定後読み
後読み (?<=...) と (?<!...) は現在位置の前にあるものをチェックします。コンテキスト依存のマッチを抽出するために使用します:
// Extract dollar amounts after the $ sign
const pricePattern = /(?<=\$)\d+(\.\d{2})?/g;
console.log('$19.99 and $5'.match(pricePattern)); // ["19.99", "5"]

// Match "cat" not preceded by "wild "
const domesticCat = /(?<!wild )cat\b/;
console.log(domesticCat.test('my cat'));         // true
console.log(domesticCat.test('a wild cat'));      // false
後読みのサポートはエンジンによって異なります。JavaScript は ES2018 で後読みを追加したため、古いブラウザやランタイムは (?<=...) を含むパターンを拒否します。Rust の regex crate は後読みを完全にサポートしていません。Rust をターゲットにする場合、Cursor に後読みなしでパターンを書き直すよう依頼してください。通常は前のコンテキストをグループにキャプチャすることで行います。
コンテキスト依存パターンの生成
Cursor にアサーションを持つパターンの構築を依頼します:
Write a regex that matches every word in a sentence except the
words "the", "a", and "an". Use negative lookahead and word
boundaries. Provide test cases.
Cursor は以下を返します:
const contentWord = /\b(?!the\b|a\b|an\b)\b[a-z]+/gi;
const sentence = 'the quick brown fox jumps over a lazy dog';
console.log(sentence.match(contentWord));
// ["quick", "brown", "fox", "jumps", "over", "lazy", "dog"]
AI 支援の正規表現生成
Cursor の際立った能力は、平易な英語の要件をテスト済みの正規表現に変換することです。このセクションは実践的なワークフローを示します。
仕様からの生成
エッジケースを含めてマッチングルールを詳細に記述します:
Generate a regex that validates a semver version string with an
optional prerelease tag. Requirements:
- Major, minor, and patch are non-negative integers with no leading zeros
- Prerelease is optional, separated by a hyphen
- Prerelease can contain alphanumeric and dot-separated identifiers
- Examples: 1.0.0, 2.14.3-alpha, 3.0.0-beta.1, 0.0.1-rc.2.exp
- Invalid: 01.0.0, 1.0, 1.0.0-, 2.x.3
Cursor はよくコメントされたパターンを生成します:
// Major: 0 or [1-9]\d*
// Minor and Patch: same as Major
// Prerelease: -(identifier)(.identifier)* where identifier = [0-9A-Za-z-]+
const semverPattern = /^(0|[1-9]\d*)\.(0|[1-9]\d*)\.(0|[1-9]\d*)(?:-([0-9A-Za-z-]+(?:\.[0-9A-Za-z-]+)*))?$/;

const tests = [
  ['1.0.0', true],
  ['2.14.3-alpha', true],
  ['3.0.0-beta.1', true],
  ['0.0.1-rc.2.exp', true],
  ['01.0.0', false],
  ['1.0', false],
  ['1.0.0-', false],
  ['2.x.3', false],
];

tests.forEach(([input, expected]) => {
  console.log(input, semverPattern.test(input) === expected ? 'PASS' : 'FAIL');
});
難解なパターンの説明
オンラインで見つけた正規表現を貼り付け、Cursor に説明を依頼します:
Explain this regex and rewrite it with comments and named groups:
/^(?:(?:25[0-5]|2[0-4]\d|[01]?\d\d?)\.){3}(?:25[0-5]|2[0-4]\d|[01]?\d\d?)$/
Cursor は分解します:
// IPv4 address validator
// Each octet matches: 0-9 | 00-99 | 100-199 | 200-249 | 250-255
const octet = '(?:25[0-5]|2[0-4]\\d|[01]?\\d\\d?)';
const ipv4Pattern = new RegExp(`^(?:${octet}\\.){3}${octet}$`);

// With named groups for readability
const ipv4Named = /^(?<o1>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o2>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o3>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o4>25[0-5]|2[0-4]\d|[01]?\d\d?)$/;
const m = '192.168.1.1'.match(ipv4Named);
console.log(m.groups); // { o1: "192", o2: "168", o3: "1", o4: "1" }
Cursor は 25[0-5] が 250 から 255 にマッチし、2[0-4]\d が 200 から 249 にマッチし、[01]?\d\d? が 0 から 199 にマッチすることを説明します。
失敗するパターンのデバッグ
正規表現が期待通りにマッチしない場合、問題を記述します:
My regex /^\d{4}-\d{2}-\d{2}$/ should match "2025-08-17" but my
function returns null. Here is my code. Find the bug.
Cursor は g フラグの欠落、呼び出し間で再利用されるグローバル正規表現オブジェクト、エスケープ文字の問題などの一般的な間違いを見つけ、修正を説明します。
一般的な検証パターン
Cursor は検証済みの再利用可能なパターンのライブラリを生成できます。実用的なコレクションを以下に示します。
メール検証
// Pragmatic email validation (RFC 5322 fully compliant regex is impractical)
const emailPattern = /^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$/;
console.log(emailPattern.test('invalid@@test')); // false
正規表現でメールアドレスを過剰に検証しないでください。唯一の信頼できるチェックは確認メールを送信することです。寛容な正規表現で明らかなタイプミスを捕捉し、配信可能性を検証します。Cursor に「寛容なメール正規表現と、MXレコードの存在もチェックする関数を書いて」と依頼すると、バランスの取れたアプローチが得られます。
URL 検証
const urlPattern = /^https?:\/\/(www\.)?[-a-zA-Z0-9@:%._+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9@:%_+.~#?&//=]*)$/;
console.log(urlPattern.test('https://www.example.com/path?q=1')); // true
スラッグ検証
// URL-safe slug: lowercase letters, digits, hyphens, no leading/trailing hyphen
const slugPattern = /^[a-z0-9]+(?:-[a-z0-9]+)*$/;
console.log(slugPattern.test('how-to-use-cursor')); // true
console.log(slugPattern.test('-invalid-slug'));     // false
16進数カラー
// 3 or 6 digit hex with optional leading #
const hexPattern = /^#?([0-9a-fA-F]{3}|[0-9a-fA-F]{6})$/;
console.log(hexPattern.test('#fff'));  // true
console.log(hexPattern.test('FF5733')); // true
強力なパスワード
// Min 8 chars, at least one uppercase, lowercase, digit, and symbol
const passwordPattern = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[^A-Za-z0-9]).{8,}$/;
console.log(passwordPattern.test('Curs0r!de')); // true
テキストの抽出と置換
正規表現は検証のためだけでなく、抽出と変換にも優れています。
すべてのマッチの抽出
// Extract all hashtags from a social post
const hashtagPattern = /#[\w]+/g;
const post = 'Loving #Cursor IDE and #regex today! #coding';
console.log(post.match(hashtagPattern)); // ["#Cursor", "#regex", "#coding"]
置換とキャプチャグループによる変換
// Convert kebab-case to camelCase
const kebabToCamel = /-([a-z])/g;
const result = 'font-size-in-cursor'.replace(kebabToCamel, (_, c) => c.toUpperCase());
console.log(result); // "fontSizeInCursor"
名前付きグループによるテンプレート化
// Replace {{ var }} placeholders with values from a context object
const templatePattern = /{{\s*(?<key>\w+)\s*}}/g;
function render(template, context) {
  return template.replace(templatePattern, (_, key) => context[key] ?? '');
}
console.log(render('Hello {{ name }}, you have {{ count }} tasks', { name: 'Sam', count: 3 }));
// "Hello Sam, you have 3 tasks"
正規表現の置換関数はマッチごとに置換を実行します。コンテキストオブジェクトが大きく、テンプレートがホットパスにある場合、パターンをプリコンパイルし、コンテキストルックアップをキャッシュしてください。また、undefined 値をガードして、出力にリテラル文字列 "undefined" が表示されないようにします。
パフォーマンスと安全性
不適切に書かれた正規表現は、エンジンが特定の入力で指数関数的な時間を費やす破滅的バックトラッキングを引き起こす可能性があります。これは実際のセキュリティリスク(ReDoS)です。
破滅的バックトラッキングの検出
Cursor にパターンの分析を依頼します:
Check this regex for catastrophic backtracking (ReDoS) risk and
rewrite it safely: /^(a+)+$/
Cursor は (a+)+ のようなネストされた量指定子が aaaaaaaaaaaaaaaaaaaa! のような入力で指数関数的バックトラッキングを作成することを説明し、安全な代替案を提供します:
// Safe alternative: anchored single quantifier
const safePattern = /^a+$/;
アンカーとアトミックグループの使用
文字列全体がマッチすることを期待する場合は、常にパターンをアンカーします。サポートされている場合、アトミックグループ (?>...) を使用してバックトラッキングを防ぎます:
// Possessive quantifier equivalent in JS (no native support, use lookahead trick)
const possessiveDigit = /(?=(\d++))\1/;
信頼できない入力については、常に正規表現の実行にタイムアウトを設定するか、バウンンド実行をサポートするライブラリを使用してください。Cursor に「Web Worker を使用して正規表現テスト関数にタイムアウトラッパーを追加して」と依頼し、悪意のある入力がアプリケーションをフリーズするのを防ぎます。
ベストプラクティスのまとめ
Cursor で正規表現を使用する際、以下の原則を心に留めてください:
- 名前付きキャプチャグループを優先 し、番号付きよりも可読性を高めます。
- キャプチャしたテキストが不要な場合は非キャプチャグループ
(?:...)を使用します。 - 完全な文字列を検証する場合は
^と$でパターンをアンカーします。 - ユーザー入力をパターンに挿入する場合は特殊文字をエスケープします。
- 正負のケースに対してテストし、エッジ条件を捕捉します。
- ネストされた量指定子を持つパターンで破滅的バックトラッキングに注意します。
xフラグまたは名前付きグループを使用して複雑なパターンにコメントを追加します。
確実な正規表現の基礎と Cursor の AI 駆動の生成と説明を組み合わせることで、パターンマッチングコードを自信を持って書き、テスト、保守できます。意図を明確に記述し、Cursor にパターンの生成と説明を任せ、リリース前に徹底したテストケースのセットで検証してください。