Regex und Mustererkennung in Cursor: Syntax, Erfassungsgruppen und KI-gestützte Generierung
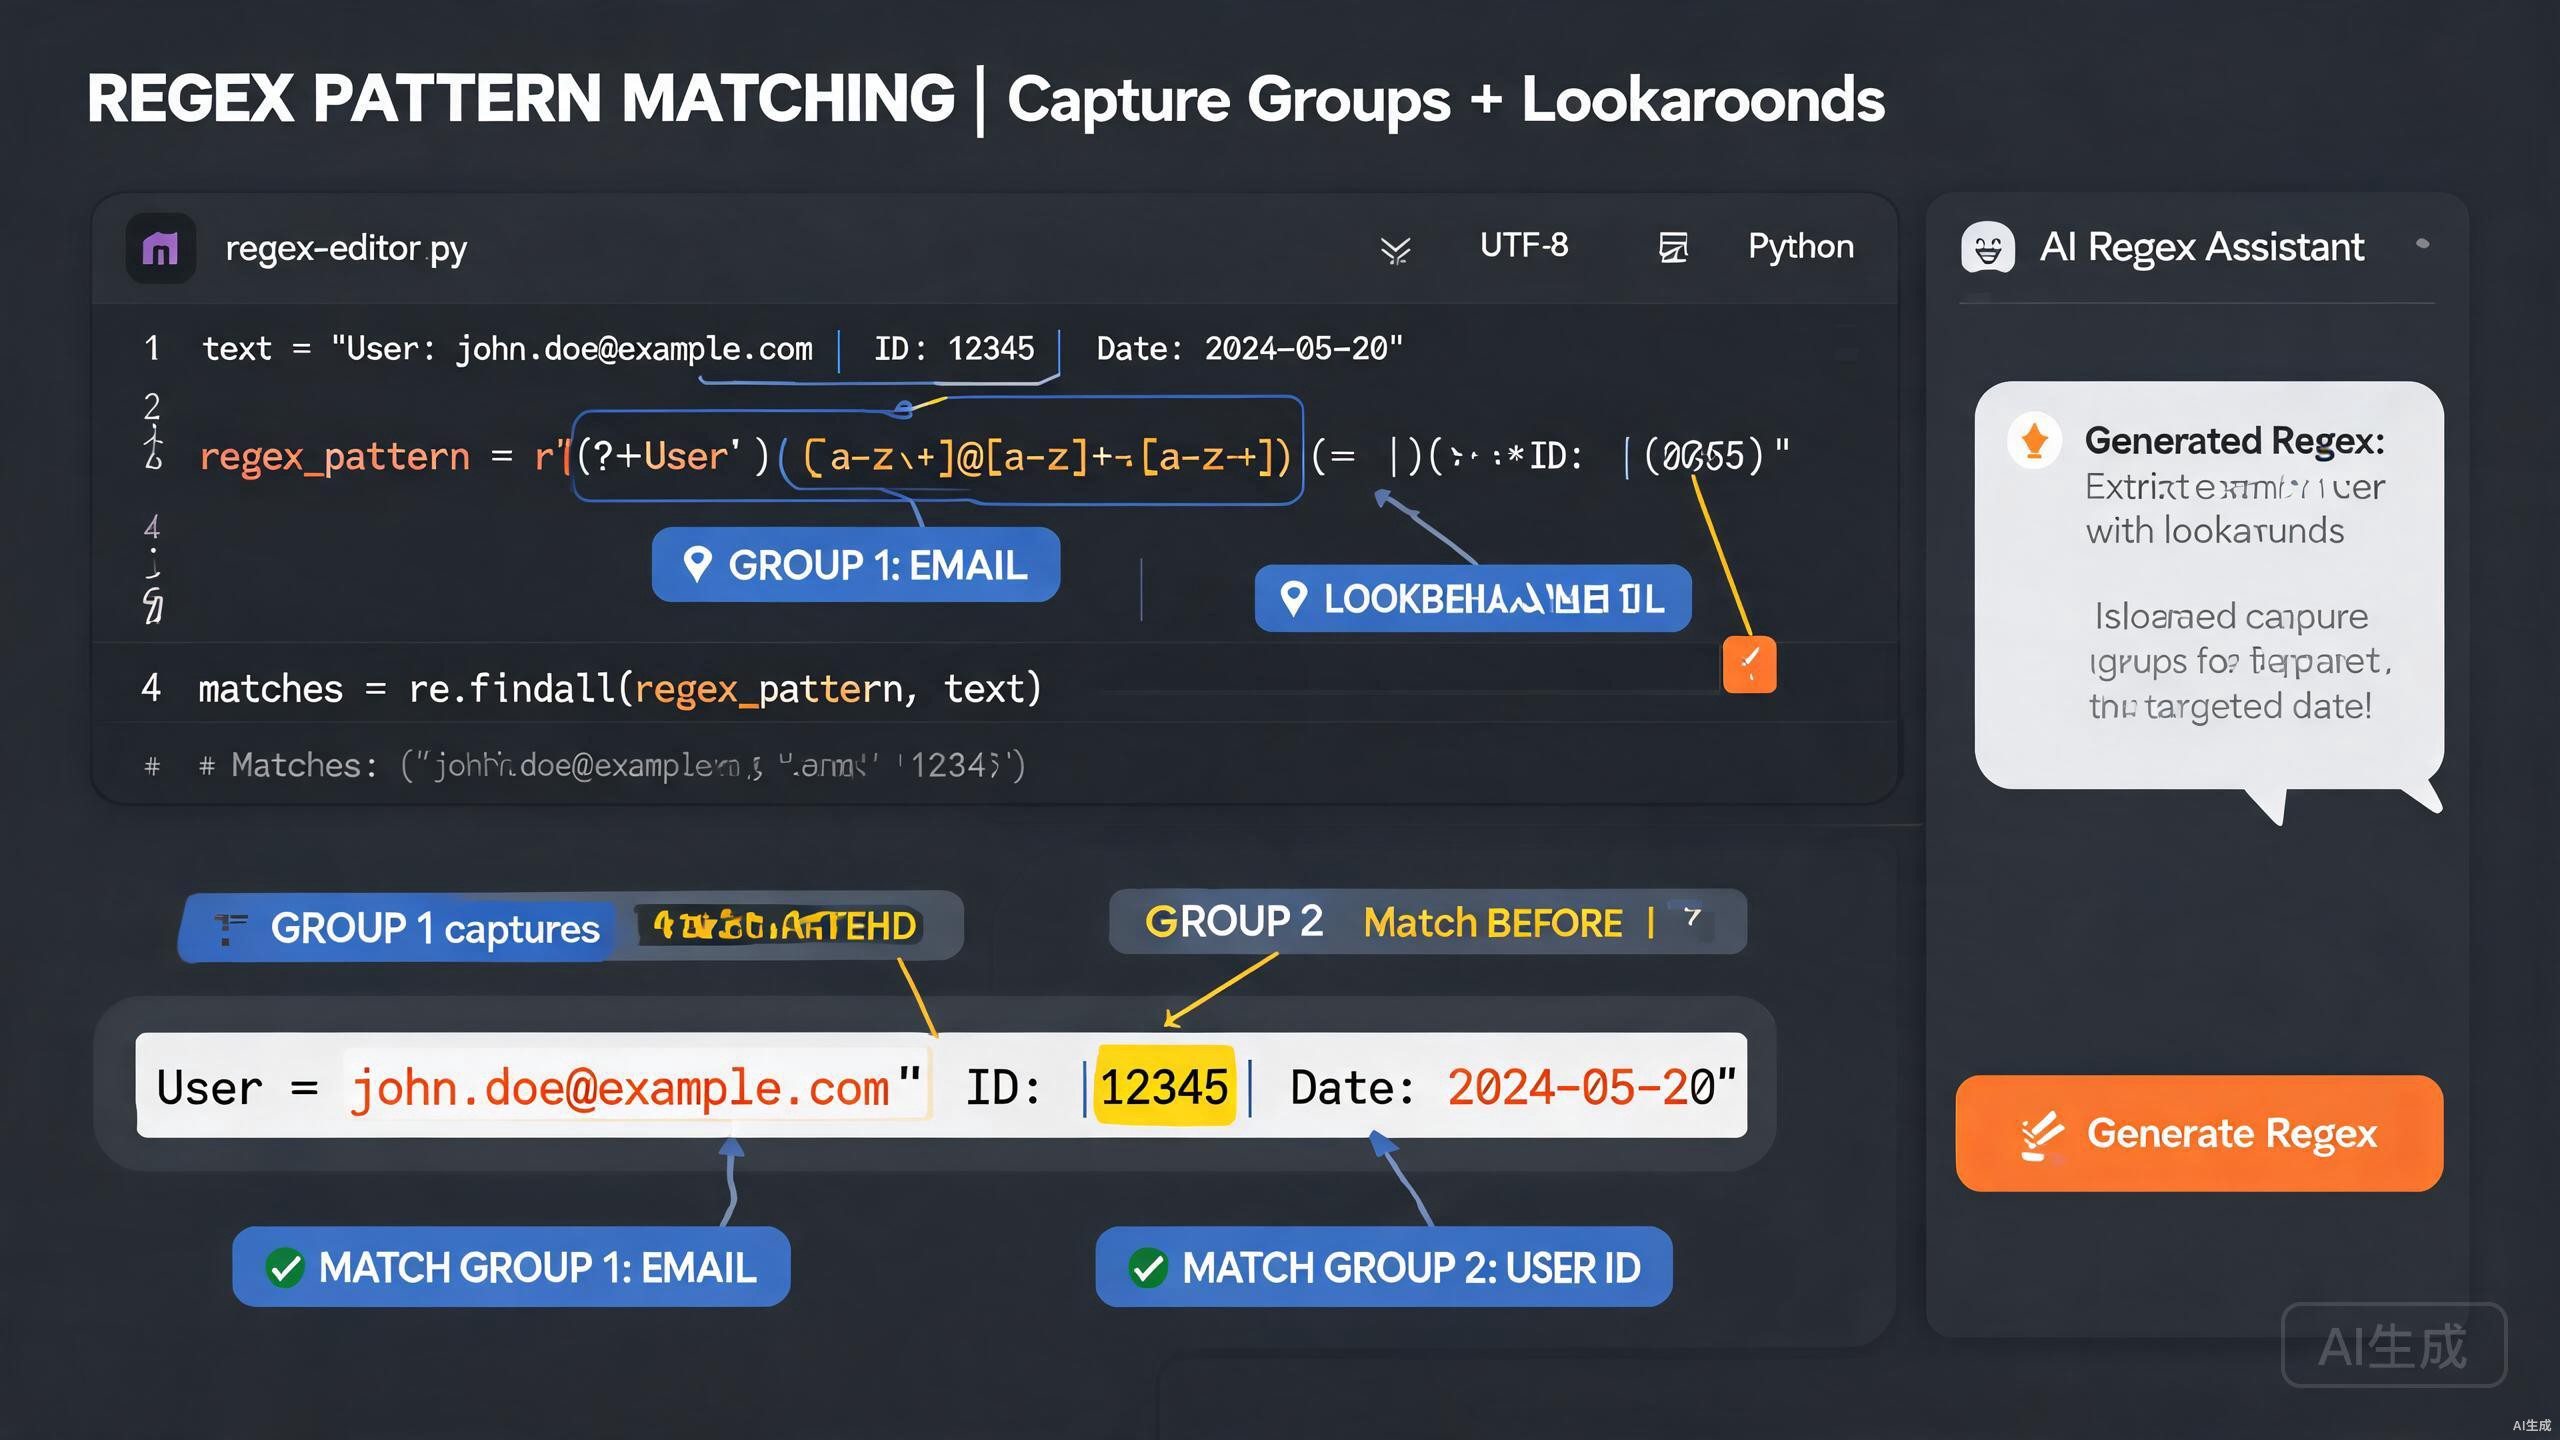
Reguläre Ausdrücke (Regex) sind eine kompakte, leistungsstarke Möglichkeit, Text zu erkennen, zu validieren und zu extrahieren. Sie sind auch notorisch schwer zu lesen und leicht falsch zu verwenden. Cursor, ein KI-gestützter IDE-Editor, macht die Arbeit mit Regex deutlich zugänglicher, indem es Muster aus Klartext-Beschreibungen generiert, kryptische Ausdrücke erklärt und sie an Beispieleingaben testet. Dieser Leitfaden behandelt Regex-Syntax, Erfassungsgruppen, Lookahead- und Lookbehind-Assertionen, KI-gestützte Regex-Generierung und eine Bibliothek häufiger Validierungsmuster.
Voraussetzungen
Bevor Sie beginnen, stellen Sie sicher, dass Sie Folgendes haben:
- Cursor (neueste Version empfohlen) als IDE-Editor
- Eine Programmierumgebung mit einer Regex-Engine (JavaScript, Python oder Rust)
- Grundlegende Vertrautheit mit String-Manipulationskonzepten
Die KI von Cursor ist hervorragend darin, Regex zu erklären und zu generieren, aber sie ist kein Ersatz für das Verständnis der Grundlagen. Überprüfen Sie immer generierte Muster anhand Ihrer Testfälle, da sich Regex-Engines sprachspezifisch leicht unterscheiden. Ein Muster, das in JavaScript funktioniert, kann sich in Python oder Rust anders verhalten.
Grundlagen der Regex-Syntax
Das Verständnis der Bausteine von Regex ermöglicht es Ihnen, Muster selbstbewusst zu lesen und zu debuggen. Cursor kann jedes Muster erklären, aber das Vokabular zu kennen, hilft Ihnen, bessere Prompts zu schreiben.
Zeichen und Metazeichen
Hier sind die wichtigsten Regex-Bausteine:
| Konstrukt | Bedeutung |
|---|---|
. | Beliebiges Zeichen außer Zeilenumbruch |
\d | Eine Ziffer (0 bis 9) |
\w | Ein Wortzeichen (Buchstabe, Ziffer, Unterstrich) |
\s | Leerzeichen (Leertaste, Tab, Zeilenumbruch) |
\D, \W, \S | Negierte Versionen der obigen |
^ | Anfang des Strings (oder Zeile im Multiline-Modus) |
$ | Ende des Strings (oder Zeile im Multiline-Modus) |
\b | Wortgrenze |
Quantifizierer
Quantifizierer steuern, wie oft ein Token wiederholt werden darf:
| Quantifizierer | Bedeutung |
|---|---|
* | Null oder mehr |
+ | Eins oder mehr |
? | Null oder eins |
{n} | Genau n |
{n,} | n oder mehr |
{n,m} | Zwischen n und m |
Zeichenklassen und Alternation
Eckige Klammern definieren eine Menge erlaubter Zeichen und der Pipe definiert Alternativen:
const vowelPattern = /[aeiou]/;       // ein einzelner Vokal
const hexPattern = /[0-9a-fA-F]/;     // eine einzelne Hex-Ziffer
const colorPattern = /red|green|blue/; // eines von drei Wörtern
Ein erstes Muster generieren
Bitten Sie Cursor, ein Muster aus einer Beschreibung zu generieren:
Schreibe eine Regex, die eine US-Telefonnummer im Format (XXX) XXX-XXXX
erkennt, wobei X eine Ziffer ist. Füge benannte Erfassungsgruppen für
die Vorwahl und die lokale Nummer hinzu. Erkläre jeden Teil.
Cursor gibt das Muster mit einer Erklärung zurück:
// Pattern: /^\((?<areaCode>\d{3})\) (?<localNumber>\d{3}-\d{4})$/
const phonePattern = /^\((?<areaCode>\d{3})\) (?<localNumber>\d{3}-\d{4})$/;

const match = '(555) 123-4567'.match(phonePattern);
console.log(match.groups.areaCode);     // "555"
console.log(match.groups.localNumber);   // "123-4567"
Cursor erklärt: \( erkennt ein literales öffnendes Klammerzeichen, \d{3} erkennt genau drei Ziffern, (?<areaCode>...) ist eine benannte Erfassungsgruppe, und \) erkennt die schließende Klammer.
Klammern haben in Regex zwei Bedeutungen: Gruppierung und Erfassung. Um zu gruppieren ohne zu erfassen, verwenden Sie (?:...). Das Vergessen des ?: erstellt unnötige Erfassungsgruppen, die Ihre Gruppenindizes verschieben und subtile Off-by-One-Bugs verursachen können, wenn Sie Gruppen nach Nummer indizieren.
Erfassungsgruppen und Rückverweise
Erfassungsgruppen ermöglichen es Ihnen, Teile einer Übereinstimmung zu extrahieren und später im Muster wiederzuverwenden. Cursor generiert und verfeinert Erfassungsgruppen präzise.
Nummerierte Erfassungsgruppen
// Datumskomponenten aus JJJJ-MM-TT extrahieren
const datePattern = /(\d{4})-(\d{2})-(\d{2})/;
const match = '2025-08-17'.match(datePattern);
console.log(match[1]); // Jahr: "2025"
console.log(match[2]); // Monat: "08"
console.log(match[3]); // Tag: "17"
Benannte Erfassungsgruppen
Benannte Gruppen sind deutlich lesbarer als nummerierte, besonders in langen Mustern. Bitten Sie Cursor, ein Muster zu konvertieren:
Konvertiere diese Regex, um benannte Erfassungsgruppen anstelle von
nummerierten zu verwenden:
/(\d{4})-(\d{2})-(\d{2})T(\d{2}):(\d{2}):(\d{2})/
Cursor schreibt sie um:
const isoPattern = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})T(?<hour>\d{2}):(?<minute>\d{2}):(?<second>\d{2})/;
const m = '2025-08-17T14:30:00'.match(isoPattern);
console.log(m.groups.year, m.groups.month, m.groups.day); // "2025" "08" "17"
Rückverweise
Rückverweise ermöglichen es einem Muster, denselben Text zu erkennen, den eine frühere Gruppe erfasst hat. Ein klassisches Beispiel ist das Erkennen wiederholter Wörter:
// Verdoppelte Wörter wie "the the" finden
const doubledWord = /\b(\w+)\s+\1\b/gi;
const text = 'I went to the the store and bought a a apple.';
console.log(text.replace(doubledWord, '$1'));
// "I went to the store and bought a apple."
Das \1 bezieht sich auf das, was die erste Erfassungsgruppe erkannt hat, sodass das Muster nur erfolgreich ist, wenn das zweite Wort mit dem ersten identisch ist.
Nicht-erfassende Gruppen
Wenn Sie Gruppierung für Alternation oder Quantifizierer benötigen, aber den erfassten Text nicht brauchen, verwenden Sie eine nicht-erfassende Gruppe, um zu vermeiden, das Übereinstimmungs-Array zu verschmutzen:
// "color" oder "colour" erkennen, ohne das optionale "u" zu erfassen
const colorPattern = /colou?r/;
const ukPattern = /col(?:ou)?r/; // nicht-erfassende Variante
Bitten Sie Cursor, eine komplexe Regex auf unnötige Erfassungsgruppen zu auditeren. Prompt: "Finde Erfassungsgruppen in diesem Muster, die nicht verwendet werden, und konvertiere sie in nicht-erfassende Gruppen." Sauberere Gruppen machen Ihren Code vorhersehbarer und minimal schneller.
Lookahead und Lookbehind
Lookahead und Lookbehind sind Assertionen mit der Breite Null, die den Kontext prüfen, ohne Zeichen zu verbrauchen. Sie sind essentiell für Validierung ohne Extraktion.
Positiver Lookahead
Positiver Lookahead (?=...) behauptet, dass das Folgende übereinstimmt, ohne es in das Ergebnis aufzunehmen. Ein häufiger Verwendungszweck ist die Passwortvalidierung:
// Mindestens 8 Zeichen, ein Großbuchstabe, eine Ziffer
const strongPassword = /^(?=.*[A-Z])(?=.*\d).{8,}$/;
console.log(strongPassword.test('Abcdefg1')); // true
console.log(strongPassword.test('password')); // false
Jedes (?=...) prüft eine Bedingung vom Anfang des Strings, dann erkennt .{8,} die tatsächlichen Passwortzeichen.
Negativer Lookahead
Negativer Lookahead (?!...) behauptet, dass das Folgende nicht übereinstimmt:
// "java" erkennen, dem kein "script" folgt
const javaNotScript = /\bjava(?!script)\b/i;
console.log(javaNotScript.test('I love java'));           // true
console.log(javaNotScript.test('I love javascript'));     // false
Positiver und negativer Lookbehind
Lookbehind (?<=...) und (?<!...) prüfen, was der aktuellen Position vorausgeht. Verwenden Sie sie, um kontextabhängige Übereinstimmungen zu extrahieren:
// Dollarbeträge nach dem $-Zeichen extrahieren
const pricePattern = /(?<=\$)\d+(\.\d{2})?/g;
console.log('$19.99 and $5'.match(pricePattern)); // ["19.99", "5"]

// "cat" erkennen, dem kein "wild " vorausgeht
const domesticCat = /(?<!wild )cat\b/;
console.log(domesticCat.test('my cat'));         // true
console.log(domesticCat.test('a wild cat'));      // false
Die Lookbehind-Unterstützung variiert je nach Engine. JavaScript hat Lookbehind in ES2018 hinzugefügt, daher lehnen ältere Browser und Runtimes Muster mit (?<=...) ab. Die regex-Crate von Rust unterstützt gar kein Lookbehind. Wenn Sie Rust anzielen, bitten Sie Cursor, Lookbehind-Muster ohne es neu zu schreiben, normalerweise durch Erfassen des vorhergehenden Kontexts in einer Gruppe.
Kontextsensitive Muster generieren
Bitten Sie Cursor, ein Muster mit Assertionen zu erstellen:
Schreibe eine Regex, die jedes Wort in einem Satz außer den Wörtern
"the", "a" und "an" erkennt. Verwende negativen Lookahead und
Wortgrenzen. Stelle Testfälle bereit.
Cursor gibt zurück:
const contentWord = /\b(?!the\b|a\b|an\b)\b[a-z]+/gi;
const sentence = 'the quick brown fox jumps over a lazy dog';
console.log(sentence.match(contentWord));
// ["quick", "brown", "fox", "jumps", "over", "lazy", "dog"]
KI-gestützte Regex-Generierung
Die herausragende Fähigkeit von Cursor ist es, Klartext-Anforderungen in getestete Regex umzuwandeln. Dieser Abschnitt zeigt praktische Workflows.
Generierung aus einer Spezifikation
Beschreiben Sie Ihre Erkennungsregeln detailliert, einschließlich Randfälle:
Generiere eine Regex, die eine Semver-Versionszeichenkette mit einem
optionalen Pre-Release-Tag validiert. Anforderungen:
- Major, Minor und Patch sind nicht-negative Ganzzahlen ohne führende Nullen
- Pre-Release ist optional, durch einen Bindestrich getrennt
- Pre-Release kann alphanumerische und punktgetrennte Bezeichner enthalten
- Beispiele: 1.0.0, 2.14.3-alpha, 3.0.0-beta.1, 0.0.1-rc.2.exp
- Ungültig: 01.0.0, 1.0, 1.0.0-, 2.x.3
Cursor produziert ein gut kommentiertes Muster:
// Major: 0 oder [1-9]\d*
// Minor und Patch: gleich wie Major
// Pre-Release: -(Bezeichner)(.Bezeichner)* wobei Bezeichner = [0-9A-Za-z-]+
const semverPattern = /^(0|[1-9]\d*)\.(0|[1-9]\d*)\.(0|[1-9]\d*)(?:-([0-9A-Za-z-]+(?:\.[0-9A-Za-z-]+)*))?$/;

const tests = [
  ['1.0.0', true],
  ['2.14.3-alpha', true],
  ['3.0.0-beta.1', true],
  ['0.0.1-rc.2.exp', true],
  ['01.0.0', false],
  ['1.0', false],
  ['1.0.0-', false],
  ['2.x.3', false],
];

tests.forEach(([input, expected]) => {
  console.log(input, semverPattern.test(input) === expected ? 'PASS' : 'FAIL');
});
Kryptische Muster erklären
Fügen Sie eine online gefundene Regex ein und bitten Sie Cursor, sie zu erklären:
Erkläre diese Regex und schreibe sie mit Kommentaren und benannten
Gruppen neu:
/^(?:(?:25[0-5]|2[0-4]\d|[01]?\d\d?)\.){3}(?:25[0-5]|2[0-4]\d|[01]?\d\d?)$/
Cursor zerlegt sie:
// IPv4-Adress-Validator
// Jedes Oktett erkennt: 0-9 | 00-99 | 100-199 | 200-249 | 250-255
const octet = '(?:25[0-5]|2[0-4]\\d|[01]?\\d\\d?)';
const ipv4Pattern = new RegExp(`^(?:${octet}\\.){3}${octet}$`);

// Mit benannten Gruppen für Lesbarkeit
const ipv4Named = /^(?<o1>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o2>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o3>25[0-5]|2[0-4]\d|[01]?\d\d?)\.(?<o4>25[0-5]|2[0-4]\d|[01]?\d\d?)$/;
const m = '192.168.1.1'.match(ipv4Named);
console.log(m.groups); // { o1: "192", o2: "168", o3: "1", o4: "1" }
Cursor erklärt, dass 25[0-5] 250 bis 255 erkennt, 2[0-4]\d 200 bis 249 erkennt und [01]?\d\d? 0 bis 199 erkennt.
Fehlschlagende Muster debuggen
Wenn eine Regex nicht wie erwartet erkennt, beschreiben Sie das Problem:
Meine Regex /^\d{4}-\d{2}-\d{2}$/ sollte "2025-08-17" erkennen, aber
meine Funktion gibt null zurück. Hier ist mein Code. Finde den Bug.
Cursor erkennt häufige Fehler wie ein fehlendes g-Flag, ein globales Regex-Objekt, das über Aufrufe hinweg wiederverwendet wird, oder ein Escape-Zeichen-Problem und erklärt die Korrektur.
Häufige Validierungsmuster
Cursor kann eine wiederverwendbare Bibliothek validierter Muster generieren. Hier ist eine praktische Sammlung.
E-Mail-Validierung
// Pragmatische E-Mail-Validierung (eine vollständig RFC 5322-konforme Regex ist unrealistisch)
const emailPattern = /^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$/;
console.log(emailPattern.test('invalid@@test')); // false
Übervalidieren Sie E-Mail-Adressen nicht mit Regex. Die einzige zuverlässige Prüfung ist das Senden einer Bestätigungs-E-Mail. Verwenden Sie eine permissive Regex, um offensichtliche Tippfehler abzufangen, und überprüfen Sie dann die Zustellbarkeit. Bitten Sie Cursor: "Schreibe eine permissive E-Mail-Regex und eine Funktion, die auch prüft, ob der MX-Eintrag existiert," für einen ausgewogenen Ansatz.
URL-Validierung
const urlPattern = /^https?:\/\/(www\.)?[-a-zA-Z0-9@:%._+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b([-a-zA-Z0-9@:%_+.~#?&//=]*)$/;
console.log(urlPattern.test('https://www.example.com/path?q=1')); // true
Slug-Validierung
// URL-sicherer Slug: Kleinbuchstaben, Ziffern, Bindestriche, kein führendes/abschließendes Minus
const slugPattern = /^[a-z0-9]+(?:-[a-z0-9]+)*$/;
console.log(slugPattern.test('how-to-use-cursor')); // true
console.log(slugPattern.test('-invalid-slug'));     // false
Hex-Farbe
// 3- oder 6-stelliges Hex mit optionalem führendem #
const hexPattern = /^#?([0-9a-fA-F]{3}|[0-9a-fA-F]{6})$/;
console.log(hexPattern.test('#fff'));  // true
console.log(hexPattern.test('FF5733')); // true
Starkes Passwort
// Min 8 Zeichen, mindestens ein Großbuchstabe, Kleinbuchstabe, Ziffer und Symbol
const passwordPattern = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[^A-Za-z0-9]).{8,}$/;
console.log(passwordPattern.test('Curs0r!de')); // true
Text extrahieren und ersetzen
Regex dient nicht nur zur Validierung; sie glänzt bei Extraktion und Transformation.
Alle Übereinstimmungen extrahieren
// Alle Hashtags aus einem Social-Post extrahieren
const hashtagPattern = /#[\w]+/g;
const post = 'Loving #Cursor IDE and #regex today! #coding';
console.log(post.match(hashtagPattern)); // ["#Cursor", "#regex", "#coding"]
Transformation mit Replace und Erfassungsgruppen
// kebab-case in camelCase umwandeln
const kebabToCamel = /-([a-z])/g;
const result = 'font-size-in-cursor'.replace(kebabToCamel, (_, c) => c.toUpperCase());
console.log(result); // "fontSizeInCursor"
Templating mit benannten Gruppen
// {{ var }}-Platzhalter durch Werte aus einem Kontextobjekt ersetzen
const templatePattern = /{{\s*(?<key>\w+)\s*}}/g;
function render(template, context) {
  return template.replace(templatePattern, (_, key) => context[key] ?? '');
}
console.log(render('Hello {{ name }}, you have {{ count }} tasks', { name: 'Sam', count: 3 }));
// "Hello Sam, you have 3 tasks"
Die Regex-Replace-Funktion führt die Ersetzung für jede Übereinstimmung aus. Wenn Ihr Kontextobjekt groß ist und Ihre Vorlage in einem heißen Pfad liegt, präkompilieren Sie das Muster und cachen Sie die Kontextsuche. Schützen Sie sich auch gegen undefined-Werte, um zu vermeiden, dass der literale String "undefined" in Ihrer Ausgabe erscheint.
Performance und Sicherheit
Schlecht geschriebene Regex kann katastrophales Backtracking verursachen, bei dem die Engine bei bestimmten Eingaben exponentielle Zeit benötigt. Dies ist ein echtes Sicherheitsrisiko (ReDoS).
Katastrophales Backtracking erkennen
Bitten Sie Cursor, ein Muster zu analysieren:
Prüfe diese Regex auf katastrophales Backtracking-Risiko (ReDoS)
und schreibe sie sicher um: /^(a+)+$/
Cursor erklärt, dass verschachtelte Quantifizierer wie (a+)+ exponentielles Backtracking bei Eingaben wie aaaaaaaaaaaaaaaaaaaa! erzeugen, und provides dann eine sichere Alternative:
// Sichere Alternative: verankerter einzelner Quantifizierer
const safePattern = /^a+$/;
Anker und atomare Gruppen verwenden
Verankern Sie Muster immer, wenn Sie erwarten, dass der gesamte String übereinstimmt. Verwenden Sie, wenn unterstützt, atomische Gruppen (?>...), um Backtracking zu verhindern:
// Possessive-Quantifizierer-Äquivalent in JS (keine native Unterstützung, Lookahead-Trick)
const possessiveDigit = /(?=(\d++))\1/;
Setzen Sie bei nicht vertrauenswürdigen Eingaben immer ein Timeout für die Regex-Ausführung oder verwenden Sie eine Bibliothek, die begrenzte Ausführung unterstützt. Bitten Sie Cursor: "Füge einen Timeout-Wrapper zu meiner Regex-Test-Funktion mit einem Web Worker hinzu," um zu verhindern, dass eine bösartige Eingabe Ihre Anwendung einfriert.
Zusammenfassung der Best Practices
Beachten Sie diese Prinzipien bei der Arbeit mit Regex in Cursor:
- Bevorzugen Sie benannte Erfassungsgruppen gegenüber nummerierten für Lesbarkeit.
- Verwenden Sie nicht-erfassende Gruppen
(?:...), wenn Sie den erfassten Text nicht benötigen. - Verankern Sie Ihre Muster mit
^und$, wenn Sie vollständige Strings validieren. - Escapen Sie Sonderzeichen, wenn Sie Benutzereingaben in ein Muster interpolieren.
- Testen Sie positive und negative Fälle, um Randbedingungen zu erkennen.
- Achten Sie auf katastrophales Backtracking bei Mustern mit verschachtelten Quantifizierern.
- Fügen Sie Kommentare zu komplexen Mustern mit dem
x-Flag oder benannten Gruppen hinzu.
Durch die Kombination solider Regex-Grundlagen mit der KI-gestützten Generierung und Erklärung von Cursor können Sie Mustererkennungs-Code zuversichtlich schreiben, testen und warten. Beschreiben Sie Ihre Absicht klar, lassen Sie Cursor das Muster produzieren und erklären, und validieren Sie es dann gegen einen gründlichen Satz von Testfällen, bevor Sie es ausliefern.