GraphQL API-Entwicklung in Cursor
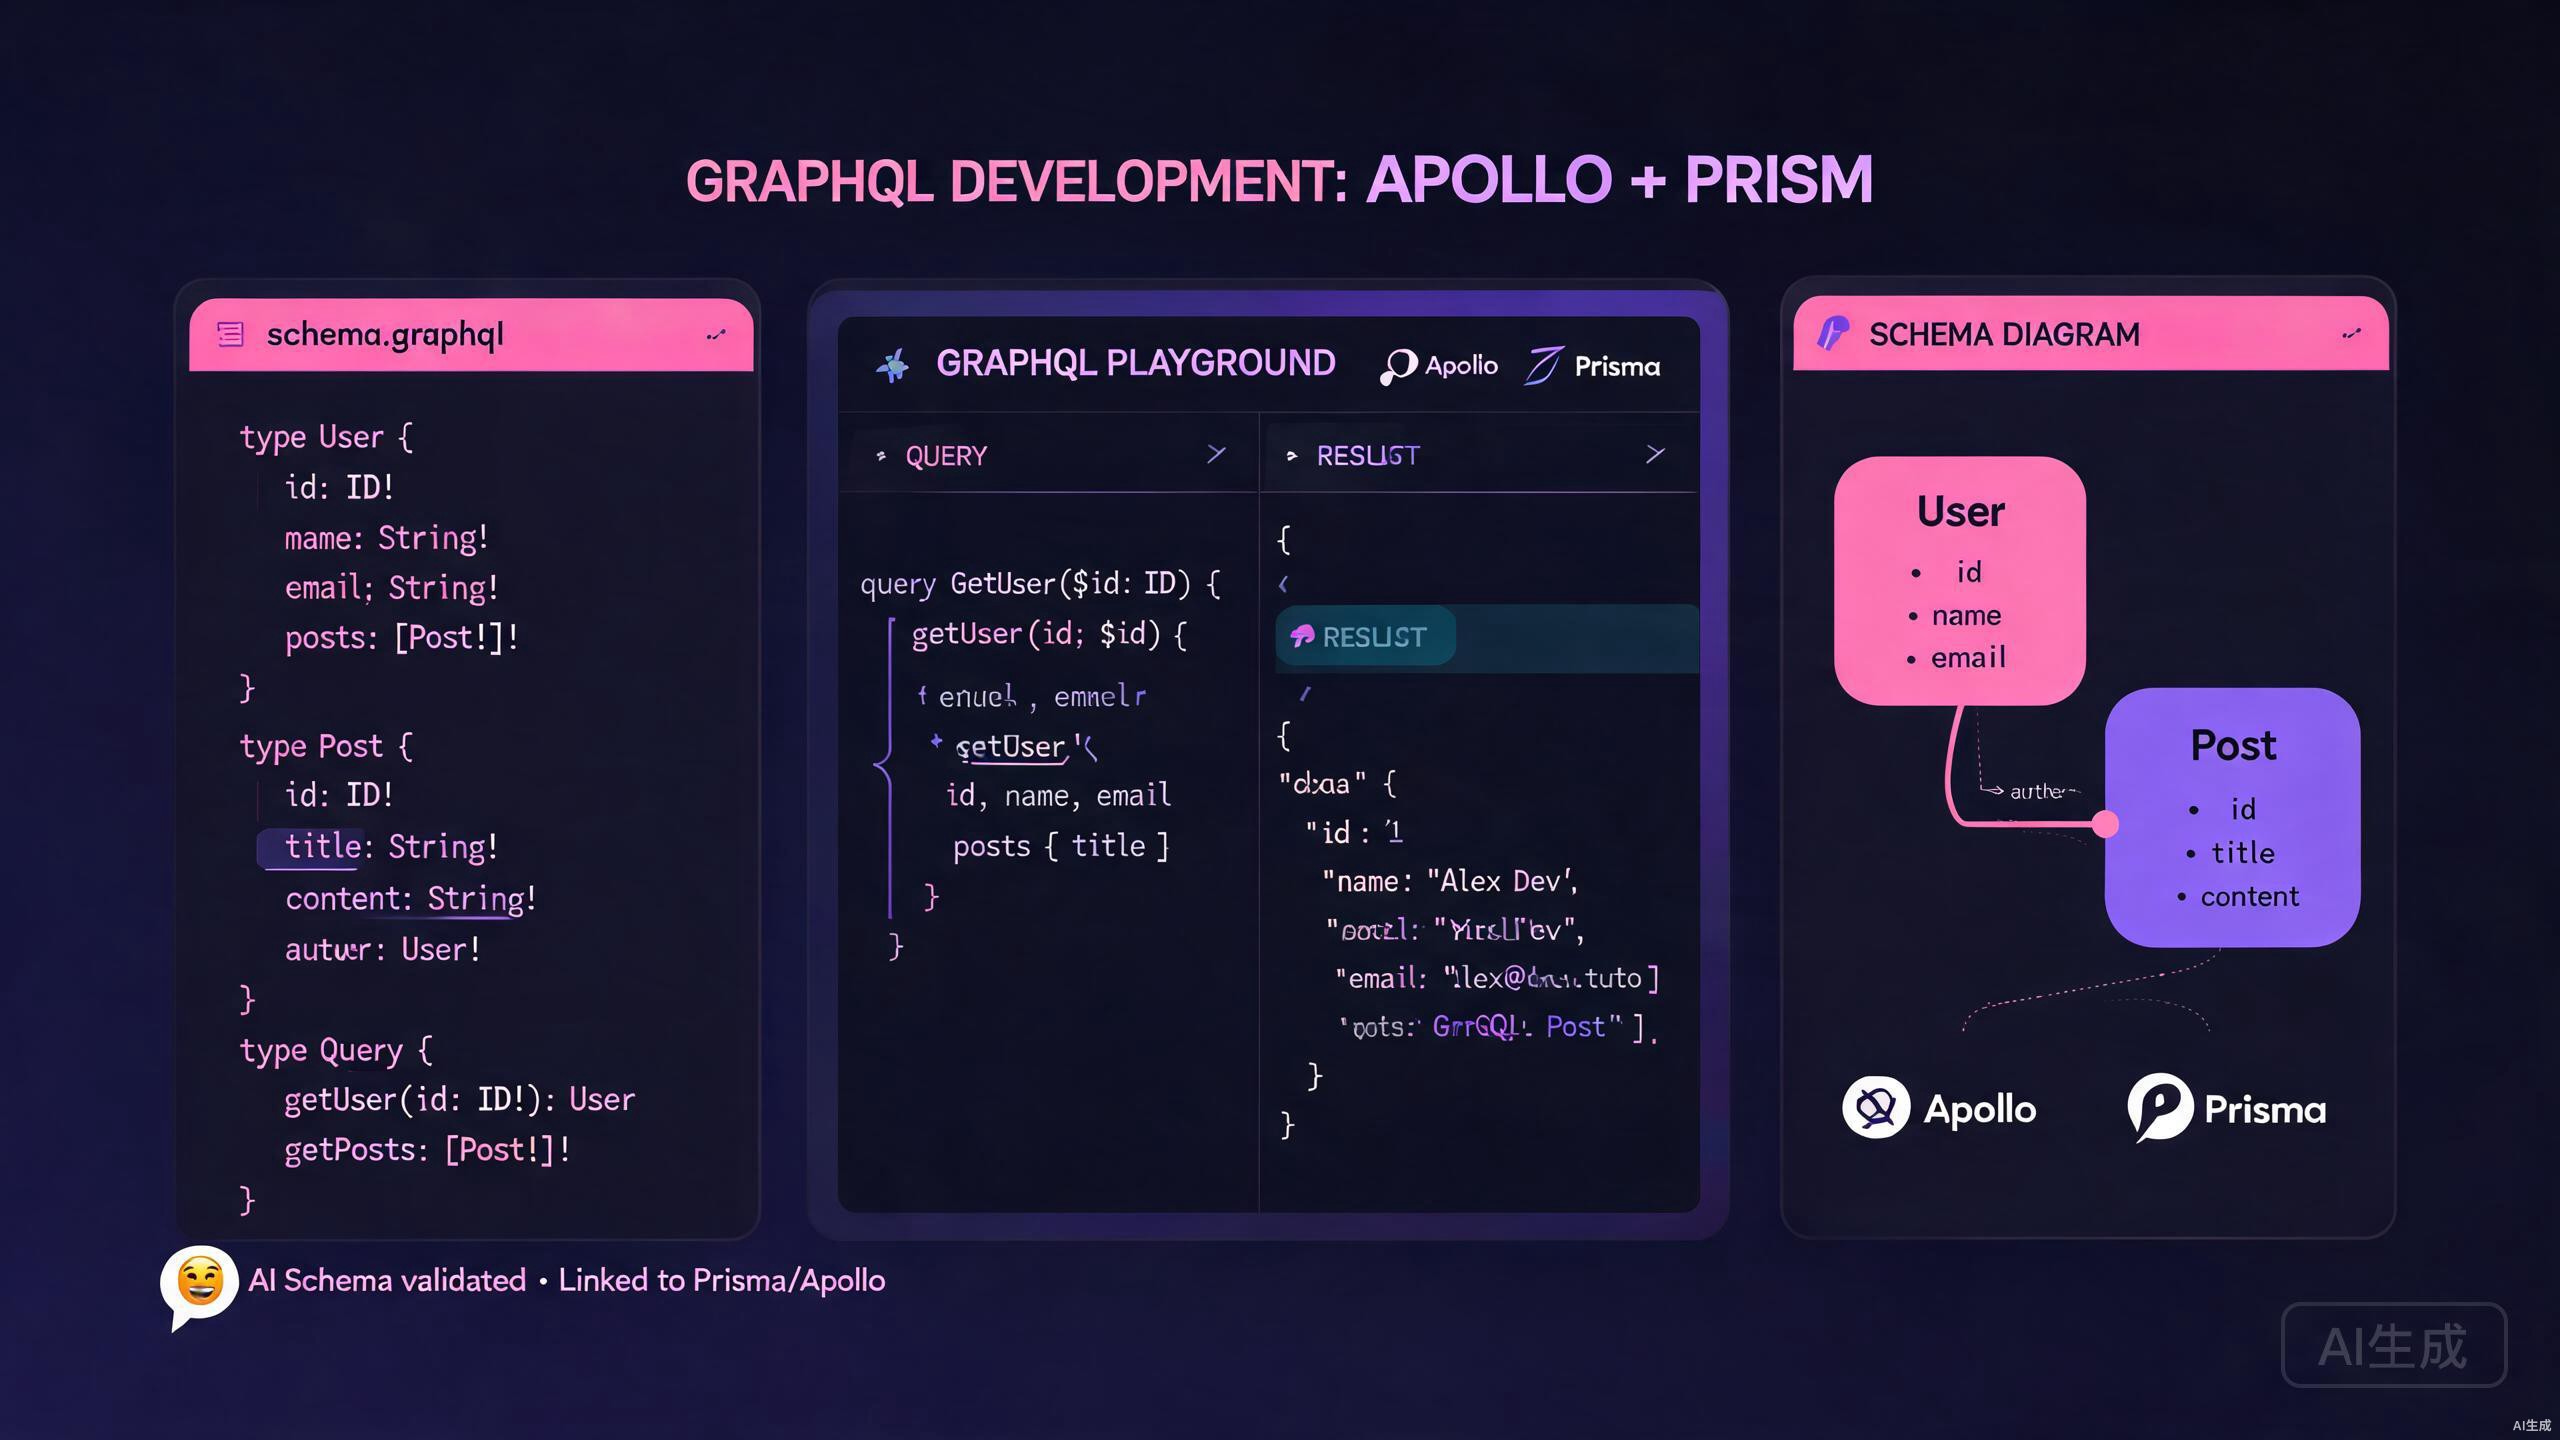
GraphQL hat die Art und Weise revolutioniert, wie wir APIs entwickeln, indem es Clients ermöglicht, genau die Daten anzufordern, die sie benötigen. In Kombination mit Cursor, einem KI-gestützten IDE-Editor, wird Ihr GraphQL-Entwicklungsworkflow erheblich schneller und intelligenter. Dieser Leitfaden behandelt alles vom Schema-Design bis zur produktionsreifen Resolver-Implementierung unter Verwendung der erweiterten Funktionen von Cursor.
Einführung in GraphQL in Cursor
Cursor bietet eine außergewöhnliche Umgebung für die GraphQL-Entwicklung durch intelligente Code-Vervollständigung, KI-gestützte Codegenerierung und ein tiefes Verständnis von Schema-Beziehungen. Ob Sie eine neue API von Grund auf erstellen oder eine bestehende warten, die Funktionen von Cursor helfen Ihnen, besseren GraphQL-Code mit weniger Aufwand zu schreiben.
Die Integration zwischen Cursor und GraphQL-Tooling ermöglicht Ihnen:
- Generierung von Schemas aus TypeScript-Typen automatisch
- Intelligente Vorschläge für Resolver-Implementierungen erhalten
- Validierung von Abfragen gegen Ihr Schema in Echtzeit
- Umgestaltung großer Schemas mit KI-Unterstützung
- Generierung von Dokumentation direkt aus Ihrem Code
Bevor Sie in die Implementierungsdetails eintauchen, stellen Sie sicher, dass Sie die folgenden Tools in Ihrem Arbeitsbereich installiert haben:
- Node.js 18 oder höher
- Cursor IDE (neueste Version empfohlen)
- Eine GraphQL-Client-Erweiterung zum Testen von Abfragen
Einrichten Ihres GraphQL-Projekts
Ein gut strukturiertes Projekt ist für die skalierbare GraphQL-Entwicklung unerlässlich. Cursor hilft Ihnen hervorragend dabei, Ihre Codebasis von Anfang an zu organisieren.
Erstellen Sie zunächst ein neues Projektverzeichnis und initialisieren Sie es mit Ihrem bevorzugten Paketmanager. Öffnen Sie Cursor in diesem Verzeichnis und erstellen Sie die folgende Ordnerstruktur:
src/
  schema/
    typeDefs.ts
    resolvers/
      index.ts
      userResolver.ts
      postResolver.ts
  prisma/
    schema.prisma
  server.ts
Diese Struktur trennt die Zuständigkeiten klar und ermöglicht es der KI von Cursor, die Grenzen zwischen Schema-Definitionen, Resolver-Logik und Datenbankmodellen zu verstehen. Wenn Sie diese Struktur in Cursor öffnen, indiziert der Editor automatisch alle Typ-Beziehungen und bietet dateiübergreifende Vorschläge.
Installieren Sie die Kernabhängigkeiten für ein Apollo Server- und Prisma-Setup:
npm install @apollo/server graphql
npm install @prisma/client
npm install -D prisma typescript ts-node @types/node
Initialisieren Sie nach der Installation Prisma in Ihrem Projekt. Die Terminal-Integration von Cursor macht dies nahtlos, und die KI kann bei der Fehlerbehebung von Konfigurationsproblemen helfen, die während des Setups auftreten.
Verwenden Sie den Inline-Chat von Cursor, um Fragen zur Paketkompatibilität zu stellen. Wählen Sie beispielsweise Ihre package.json aus und fragen Sie: "Sind diese GraphQL-Abhängigkeiten mit der neuesten Apollo Server-Version kompatibel?" Cursor analysiert die Versionen und schlägt Aktualisierungen vor.
Schema-Design mit KI-Unterstützung
Das Schema-Design ist die Grundlage jeder GraphQL-API. Die KI-Fähigkeiten von Cursor machen diesen Prozess intuitiver, indem sie Typen, Felder und Beziehungen basierend auf den Anforderungen Ihrer Anwendung vorschlagen.
Erstellen von Typdefinitionen
Beginnen Sie mit der Definition Ihrer Kerntypen in src/schema/typeDefs.ts. Cursor bietet intelligente Autovervollständigung für die GraphQL SDL (Schema Definition Language)-Syntax, einschließlich eingebauter Skalare, Direktiven und benutzerdefinierter Typen.
export const typeDefs = `#graphql
  type User {
    id: ID!
    email: String!
    name: String
    posts: [Post!]!
    createdAt: String!
    updatedAt: String!
  }

  type Post {
    id: ID!
    title: String!
    content: String!
    published: Boolean!
    author: User!
    createdAt: String!
    updatedAt: String!
  }

  type Query {
    users: [User!]!
    user(id: ID!): User
    posts: [Post!]!
    post(id: ID!): Post
  }

  type Mutation {
    createUser(email: String!, name: String): User!
    createPost(title: String!, content: String!, authorId: ID!): Post!
    publishPost(id: ID!): Post!
    deletePost(id: ID!): Post!
  }
`;
Wenn Sie Typdefinitionen in Cursor eingeben, erkennt der Editor die GraphQL-Syntax und bietet kontextabhängige Vorschläge. Die KI versteht Beziehungen zwischen Typen und kann fehlende Felder vorschlagen, wenn Sie eine neue Entität definieren.
Generieren von Schemas aus Prisma-Modellen
Einer der leistungsstärksten Workflows in Cursor ist die Generierung von GraphQL-Schemas direkt aus Ihren Prisma-Modellen. Nachdem Sie Ihr Datenbankschema in prisma/schema.prisma definiert haben, können Sie den KI-Chat von Cursor verwenden, um diese Modelle in GraphQL-Typdefinitionen zu konvertieren.
Hier ist ein Beispiel für ein Prisma-Schema:
generator client {
  provider = "prisma-client-js"
}

datasource db {
  provider = "postgresql"
  url      = env("DATABASE_URL")
}

model User {
  id        String   @id @default(uuid())
  email     String   @unique
  name      String?
  posts     Post[]
  createdAt DateTime @default(now())
  updatedAt DateTime @updatedAt
}

model Post {
  id        String   @id @default(uuid())
  title     String
  content   String
  published Boolean  @default(false)
  authorId  String
  author    User     @relation(fields: [authorId], references: [id])
  createdAt DateTime @default(now())
  updatedAt DateTime @updatedAt
}
Wählen Sie das Prisma-Schema in Cursor aus und verwenden Sie die KI-Chat-Funktion mit einem Prompt wie: "Generiere entsprechende GraphQL-Typdefinitionen für diese Prisma-Modelle, einschließlich Query- und Mutation-Typen." Cursor erzeugt genaue SDL, die Ihre Datenbankstruktur widerspiegelt.
Überprüfen Sie immer KI-generierte Schemas auf Geschäftslogik-Anforderungen, die möglicherweise nicht in Datenbankmodellen erfasst sind. Die KI versteht die Struktur, kann aber domänenspezifische Validierungsregeln oder benutzerdefinierte Skalare übersehen, die Ihre Anwendung benötigt.
Implementierung von Resolvern in Cursor
Resolver sind der Ort, an dem Ihre GraphQL-API zum Leben erwacht. Die TypeScript-Integration von Cursor macht das Schreiben typsicherer Resolver erheblich produktiver.
Schreiben typsicherer Resolver
Erstellen Sie Ihre Resolver-Dateien mit vollständiger TypeScript-Unterstützung. Cursor versteht die Beziehung zwischen Ihrem Schema und den Resolver-Typen und bietet Autovervollständigung für Elternobjekte, Argumente und Kontext.
import { PrismaClient } from '@prisma/client';

const prisma = new PrismaClient();

export const userResolver = {
  Query: {
    users: async () => {
      return await prisma.user.findMany({
        include: { posts: true },
      });
    },

    user: async (_: unknown, { id }: { id: string }) => {
      return await prisma.user.findUnique({
        where: { id },
        include: { posts: true },
      });
    },
  },

  User: {
    posts: async (parent: { id: string }) => {
      return await prisma.post.findMany({
        where: { authorId: parent.id },
      });
    },
  },

  Mutation: {
    createUser: async (
      _: unknown,
      { email, name }: { email: string; name?: string }
    ) => {
      return await prisma.user.create({
        data: { email, name },
      });
    },
  },
};
Die IntelliSense von Cursor liefert genaue Typinformationen für Resolver-Argumente basierend auf Ihren Schema-Definitionen. Wenn Sie über Parameter oder Rückgabewerte fahren, sehen Sie die exakten GraphQL-Typen, die auf TypeScript abgebildet sind.
Verwenden von KI zur Generierung komplexer Resolver
Für komplexe Resolver-Logik mit Datentransformation, Aggregation oder Drittanbieter-API-Aufrufen ist die KI-Generierung von Cursor von unschätzbarem Wert. Wählen Sie einen Teil Ihres Schemas aus und bitten Sie Cursor, die entsprechende Resolver-Implementierung zu generieren.
Zum Beispiel, gegeben diese erweiterte Schema-Definition:
type Query {
  searchPosts(query: String!, filters: PostFilters): SearchResult!
}

input PostFilters {
  publishedOnly: Boolean
  dateFrom: String
  dateTo: String
  authorIds: [ID!]
}

type SearchResult {
  posts: [Post!]!
  totalCount: Int!
  hasMore: Boolean!
}
Sie können Cursor mit dem Prompt anweisen: "Implementiere einen Resolver für searchPosts, der nach den angegebenen Kriterien filtert, Paginierung mit einem Standardlimit von 20 unterstützt und die Gesamtanzahl sowie das hasMore-Flag zurückgibt." Die KI generiert eine vollständige Implementierung unter Verwendung der Filter-API von Prisma.
searchPosts: async (
  _: unknown,
  {
    query,
    filters,
  }: {
    query: string;
    filters?: {
      publishedOnly?: boolean;
      dateFrom?: string;
      dateTo?: string;
      authorIds?: string[];
    };
  },
  context: { userId?: string }
) => {
  const limit = 20;
  const where: any = {
    OR: [
      { title: { contains: query, mode: 'insensitive' } },
      { content: { contains: query, mode: 'insensitive' } },
    ],
  };

  if (filters?.publishedOnly) {
    where.published = true;
  }

  if (filters?.dateFrom || filters?.dateTo) {
    where.createdAt = {};
    if (filters.dateFrom) where.createdAt.gte = new Date(filters.dateFrom);
    if (filters.dateTo) where.createdAt.lte = new Date(filters.dateTo);
  }

  if (filters?.authorIds?.length) {
    where.authorId = { in: filters.authorIds };
  }

  const [posts, totalCount] = await Promise.all([
    prisma.post.findMany({
      where,
      take: limit,
      include: { author: true },
    }),
    prisma.post.count({ where }),
  ]);

  return {
    posts,
    totalCount,
    hasMore: totalCount > limit,
  };
},
Überprüfen Sie bei der Generierung komplexer Resolver immer die Prisma-Abfragen auf N+1-Probleme. Die KI von Cursor generiert oft grundlegende Implementierungen, die möglicherweise keine DataLoader-Muster für das Batch-Laden verwandter Entitäten enthalten.
Apollo Server Integration
Die Verbindung Ihres Schemas und Ihrer Resolver mit Apollo Server ist mit der Unterstützung von Cursor unkompliziert. Der Editor hilft Ihnen, den Server mit korrekten TypeScript-Typen und Middleware zu konfigurieren.
Einrichten des Servers
Erstellen Sie Ihre server.ts-Datei mit der Apollo Server 4-Konfiguration:
import { ApolloServer } from '@apollo/server';
import { startStandaloneServer } from '@apollo/server/standalone';
import { typeDefs } from './schema/typeDefs';
import { resolvers } from './schema/resolvers';

interface MyContext {
  token?: string;
  userId?: string;
}

const server = new ApolloServer<MyContext>({
  typeDefs,
  resolvers,
});

const { url } = await startStandaloneServer(server, {
  listen: { port: 4000 },
  context: async ({ req }): Promise<MyContext> => {
    const token = req.headers.authorization || '';
    // Fügen Sie hier die Authentifizierungslogik hinzu
    return { token };
  },
});

console.log(`Server ready at: ${url}`);
Cursor bietet Autovervollständigung für Apollo Server-APIs und hilft Ihnen, die korrekte Typisierung in der gesamten Konfiguration beizubehalten. Die KI kann auch Middleware-Muster für Authentifizierung, Protokollierung und Fehlerbehandlung vorschlagen.
Hinzufügen benutzerdefinierter Skalare und Direktiven
Fortgeschrittene GraphQL-APIs erfordern oft benutzerdefinierte Skalare für spezielle Datentypen. Cursor hilft Ihnen, diese mit vollständiger Typsicherheit zu implementieren.
import { GraphQLScalarType, Kind } from 'graphql';

export const dateScalar = new GraphQLScalarType({
  name: 'Date',
  description: 'Custom Date scalar',
  serialize(value: unknown) {
    if (value instanceof Date) {
      return value.toISOString();
    }
    throw Error('GraphQL Date Scalar serializer expected a Date object');
  },
  parseValue(value: unknown) {
    if (typeof value === 'string') {
      return new Date(value);
    }
    throw new Error('GraphQL Date Scalar parser expected a string');
  },
  parseLiteral(ast) {
    if (ast.kind === Kind.STRING) {
      return new Date(ast.value);
    }
    return null;
  },
});
Wenn Sie benutzerdefinierte Skalare definieren, stellt der TypeScript-Sprachserver von Cursor sicher, dass Ihre Serialize- und Parse-Funktionen die korrekten Typen verarbeiten, und verhindert so Laufzeitfehler.
Prisma Integration Best Practices
Die Kombination von Prisma und GraphQL in Cursor schafft eine leistungsstarke Full-Stack-Entwicklungserfahrung. Dieser Abschnitt behandelt Best Practices für die effektive Integration dieser Technologien.
Generieren von Prisma Client-Typen
Führen Sie nach der Änderung Ihres Prisma-Schemas den Generate-Befehl aus. Die Terminal-Integration von Cursor erfasst die Ausgabe, und wenn es Fehler gibt, kann die KI Ihnen helfen, Schema-Syntax-Probleme zu beheben.
npx prisma generate
Die generierten Prisma Client-Typen integrieren sich nahtlos in die IntelliSense von Cursor. Beim Schreiben von Resolvern erhalten Sie vollständige Autovervollständigung für Modellfelder, Filteroptionen und Relationsabfragen.
Behandeln von Relationen mit DataLoader
Um das N+1-Abfrageproblem in GraphQL-Resolver zu vermeiden, integrieren Sie DataLoader in Ihr Cursor-Projekt. Die KI kann Ihnen helfen, Batch-Loading-Funktionen einzurichten, die Prisma effizient ausführt.
import DataLoader from 'dataloader';
import { PrismaClient, User } from '@prisma/client';

const prisma = new PrismaClient();

export const createUserLoader = () => {
  return new DataLoader<string, User | null>(async (userIds) => {
    const users = await prisma.user.findMany({
      where: { id: { in: [...userIds] } },
    });

    const userMap = new Map(users.map((user) => [user.id, user]));
    return userIds.map((id) => userMap.get(id) || null);
  });
};
Initialisieren Sie in Ihrem Serverkontext die Loader und übergeben Sie sie an die Resolver:
interface MyContext {
  userLoader: ReturnType<typeof createUserLoader>;
  postLoader: ReturnType<typeof createPostLoader>;
}

const { url } = await startStandaloneServer(server, {
  listen: { port: 4000 },
  context: async (): Promise<MyContext> => {
    return {
      userLoader: createUserLoader(),
      postLoader: createPostLoader(),
    };
  },
});
DataLoader-Instanzen sollten pro Anfrage erstellt werden, um Caching-Probleme zwischen verschiedenen Benutzern zu vermeiden. Die KI von Cursor schlägt manchmal Singleton-Muster für Loader vor; überprüfen Sie immer, dass Ihre Implementierung frische Instanzen für jede GraphQL-Anfrage erstellt.
KI-Abfragegenerierung und -Test
Eine der herausragenden Funktionen von Cursor ist die Fähigkeit, GraphQL-Abfragen basierend auf Ihrem Schema zu generieren und zu testen. Dies beschleunigt sowohl Entwicklungs- als auch Debugging-Workflows.
Generieren von Abfragen aus dem Schema
Wählen Sie Ihre Typdefinitionen in Cursor aus und bitten Sie die KI, Beispielabfragen und -mutationen zu generieren. Dies ist besonders nützlich für Frontend-Entwickler, die die verfügbare API-Oberfläche verstehen müssen.
Für das obige User- und Post-Schema könnte Cursor Folgendes generieren:
query GetUserWithPosts($userId: ID!) {
  user(id: $userId) {
    id
    email
    name
    posts {
      id
      title
      published
      createdAt
    }
  }
}

mutation CreateNewPost($title: String!, $content: String!, $authorId: ID!) {
  createPost(title: $title, content: $content, authorId: $authorId) {
    id
    title
    author {
      id
      name
    }
  }
}
Diese generierten Abfragen sind vollständig typisiert und gegen Ihr Schema validiert, wodurch die Wahrscheinlichkeit von Frontend-Integrationsfehlern reduziert wird.
Testen von Resolvern mit generierten Abfragen
Verwenden Sie die KI von Cursor, um umfassende Test-Suites für Ihre Resolver zu generieren. Wählen Sie eine Resolver-Funktion aus und geben Sie den Prompt ein: "Generiere Jest-Tests für diesen Resolver, einschließlich gemockter Prisma-Aufrufe und Randfälle."
import { userResolver } from './userResolver';
import { PrismaClient } from '@prisma/client';
jest.mock('@prisma/client', () => {
const mockPrisma = {
user: {
findMany: jest.fn(),
findUnique: jest.fn(),
create: jest.fn(),
},
};
return { PrismaClient: jest.fn(() => mockPrisma) };
});
describe('User Resolver', () => {
const prisma = new PrismaClient();
beforeEach(() => {
jest.clearAllMocks();
});
it('should return all users with their posts', async () => {
const mockUsers = [
];
(prisma.user.findMany as jest.Mock).mockResolvedValue(mockUsers);
const result = await userResolver.Query.users();
expect(prisma.user.findMany).toHaveBeenCalledWith({
include: { posts: true },
});
expect(result).toEqual(mockUsers);
});
it('should return a single user by id', async () => {
(prisma.user.findUnique as jest.Mock).mockResolvedValue(mockUser);
const result = await userResolver.Query.user(null, { id: '1' });
expect(prisma.user.findUnique).toHaveBeenCalledWith({
where: { id: '1' },
include: { posts: true },
});
expect(result).toEqual(mockUser);
});
});
Fehlerbehandlung und Validierung
Robuste GraphQL-APIs erfordern eine umfassende Fehlerbehandlung. Cursor hilft Ihnen, konsistente Fehlermuster in Ihren Resolvern zu implementieren.
Benutzerdefinierte Fehlerklassen
Definieren Sie benutzerdefinierte Fehlerklassen, die die GraphQL-Fehlertypen von Apollo erweitern:
import { GraphQLError } from 'graphql';

export class AuthenticationError extends GraphQLError {
  constructor(message: string = 'Not authenticated') {
    super(message, {
      extensions: { code: 'UNAUTHENTICATED', http: { status: 401 } },
    });
  }
}

export class ValidationError extends GraphQLError {
  constructor(message: string) {
    super(message, {
      extensions: { code: 'VALIDATION_FAILED', http: { status: 400 } },
    });
  }
}

export class NotFoundError extends GraphQLError {
  constructor(resource: string) {
    super(`${resource} not found`, {
      extensions: { code: 'NOT_FOUND', http: { status: 404 } },
    });
  }
}
Verwenden Sie diese Fehler in Ihren Resolvern mit der Autovervollständigungsunterstützung von Cursor:
user: async (_: unknown, { id }: { id: string }) => {
  const user = await prisma.user.findUnique({
    where: { id },
    include: { posts: true },
  });

  if (!user) {
    throw new NotFoundError('User');
  }

  return user;
},
Erstellen Sie ein Fehler-Plugin für Apollo Server, das Fehler protokolliert und für den Client formatiert. Cursor kann dieses Plugin basierend auf Ihren benutzerdefinierten Fehlerklassen generieren.
Fazit
Die Entwicklung von GraphQL-APIs in Cursor kombiniert die Leistungsfähigkeit einer modernen IDE mit intelligenter KI-Unterstützung. Vom Schema-Design über die Resolver-Implementierung, das Testen bis hin zur Bereitstellung optimiert Cursor jeden Aspekt der GraphQL-Entwicklung.
Wichtige Erkenntnisse aus diesem Leitfaden:
- Verwenden Sie die KI von Cursor, um Schemas aus Prisma-Modellen und TypeScript-Typen zu generieren
- Nutzen Sie die TypeScript-Integration für die typsichere Resolver-Entwicklung
- Implementieren Sie DataLoader-Muster, um N+1-Abfragen zu verhindern
- Generieren Sie Tests und Abfragen automatisch aus Ihren Schema-Definitionen
- Behalten Sie eine konsistente Fehlerbehandlung mit benutzerdefinierten Fehlerklassen bei
Während Sie weiter mit GraphQL und Cursor entwickeln, experimentieren Sie mit den KI-Chat-Funktionen für die Umgestaltung großer Schemas, die Optimierung von Datenbankabfragen und die Generierung von Dokumentation. Die Kombination aus menschlicher Expertise und KI-Unterstützung produziert APIs, die robust, leistungsfähig und wartbar sind.