Cursor での Prisma ORM 開発:完全ガイド
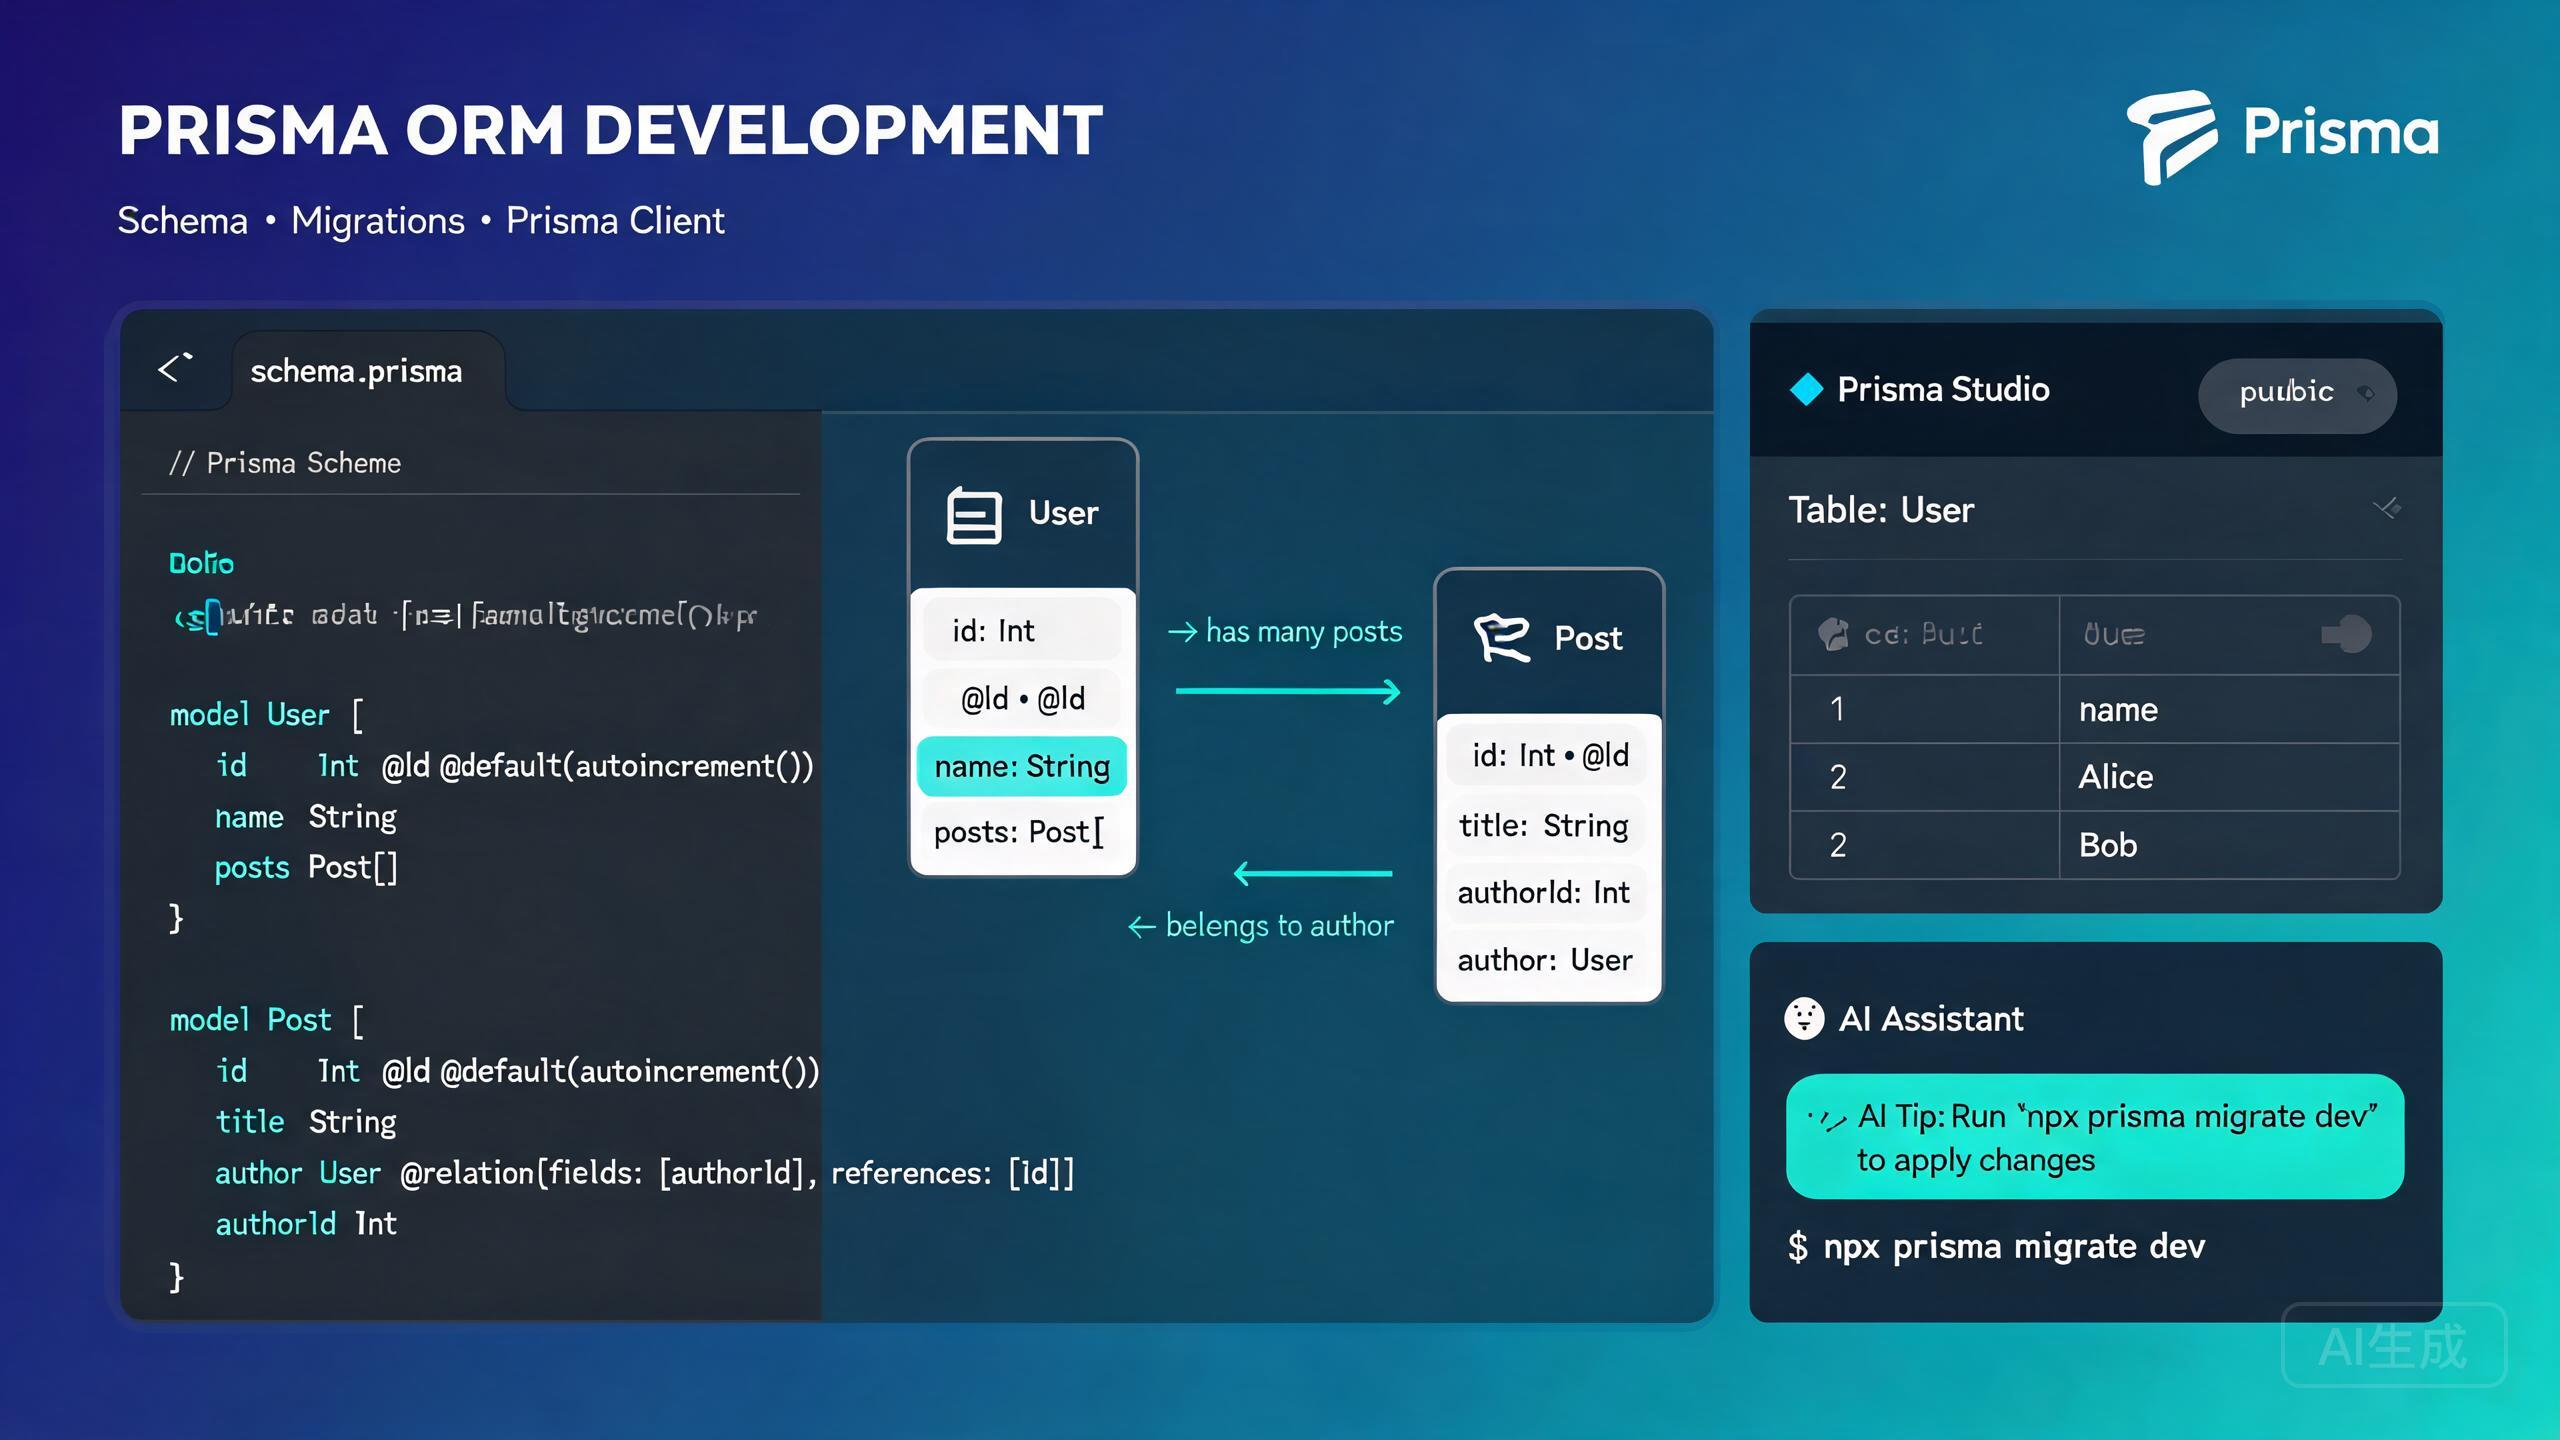
Prisma は、型安全なデータベースクライアント、宣言的スキーママイグレーション、Prisma Studio と呼ばれるビジュアルデータベースブラウザを提供する次世代 TypeScript ORM です。Prisma はボイラープレートのデータベースアクセスコードを排除し、コンパイル時にクエリエラーをキャッチします。Cursor は、統合された AI アシスタントと VS Code 互換の基盤により、Prisma 開発に最適なエディタです。Prisma スキーマ言語の IntelliSense を提供し、Prisma Client クエリを自動補完し、自然言語の記述から完全なスキーマを生成できます。
このガイドでは、Cursor での完全な Prisma 開発ワークフローをカバーします:インストールとセットアップ、スキーマ設計、マイグレーション、Prisma Client クエリ、リレーション、Prisma Studio、AI 支援スキーマ生成。
Cursor での Prisma のインストールとセットアップ
前提条件
Prisma は Node.js 18+ で動作し、PostgreSQL、MySQL、SQLite、MongoDB、SQL Server をサポートしています。Node.js のバージョンを確認:
node --version
Cursor の統合ターミナル(Ctrl+`)はエクスプローラーパネルと同期します。Prisma CLI コマンドを実行し、生成されたファイルがファイルツリーにすぐに表示されます。
Prisma 拡張機能のインストール
Cursor は VS Code 拡張機能の互換性を引き継ぎます。拡張機能ビュー(Ctrl+Shift+X)から公式 Prisma 拡張機能をインストール:
- "Prisma" を検索。
- Prisma が公開している拡張機能をインストール。
- プロンプトが表示されたら Cursor をリロード。
この拡張機能は以下を提供:
.prismaスキーマファイルのシンタックスハイライト。- 保存時の自動フォーマット。
- モデルフィールド、属性、リレーションの IntelliSense。
- スキーマエラーのインラインバリデーション。
- クイックフィックスのコードアクション。
Prisma 拡張機能がインストールされていない場合、Cursor は .prisma ファイルをプレーンテキストとして扱います。シンタックスハイライト、自動補完、エラー検出が失われます。スキーマファイルを編集する前に必ず公式拡張機能をインストールしてください。
プロジェクトでの Prisma の初期化
Prisma CLI をインストールして新しい Prisma セットアップを初期化:
npm install prisma --save-dev
npm install @prisma/client

npx prisma init
これにより以下が作成:
prisma/schema.prisma-- メインスキーマファイル。.env--DATABASE_URLプレースホルダー付き環境ファイル。
.env にデータベース接続文字列を設定:
# .env
DATABASE_URL="postgresql://user:password@localhost:5432/mydb?schema=public"
Cursor に依頼:「PostgreSQL で Prisma をセットアップして。User モデルを含むスキーマファイルを作成し、データベース接続を設定して。」Cursor が init コマンドを実行し、スキーマを生成し、.env ファイルをセットアップします。
スキーマ設計
Prisma スキーマはデータベース構造の唯一の真実の情報源です。モデル、リレーション、列挙型、データソース設定を定義します。
スキーマファイルの理解
// prisma/schema.prisma

// Generator: tells Prisma how to generate the client
generator client {
  provider = "prisma-client-js"
  previewFeatures = ["fullTextSearch", "postgresqlExtensions"]
}

// Datasource: database connection
datasource db {
  provider = "postgresql"
  url      = env("DATABASE_URL")
  extensions = [pgcrypto, postgis]
}

// Model: maps to a database table
model User {
  id        String   @id @default(uuid())
  email     String   @unique
  name      String?
  role      Role     @default(USER)
  posts     Post[]
  profile   Profile?
  createdAt DateTime @default(now())
  updatedAt DateTime @updatedAt
}

model Post {
  id          String   @id @default(uuid())
  title       String
  content     String?
  published   Boolean  @default(false)
  viewCount   Int      @default(0)
  author      User     @relation(fields: [authorId], references: [id])
  authorId    String
  categories  Category[]
  createdAt   DateTime @default(now())
  updatedAt   DateTime @updatedAt

  @@index([authorId])
  @@index([published])
}

model Category {
  id    String @id @default(uuid())
  name  String @unique
  posts Post[]
}

model Profile {
  id      String   @id @default(uuid())
  bio     String?
  user    User     @relation(fields: [userId], references: [id])
  userId  String   @unique
}

enum Role {
  USER
  ADMIN
  EDITOR
}
一般的なフィールド属性
| 属性 | 説明 |
|---|---|
@id | フィールドを主キーとしてマーク |
@default(uuid()) | 挿入時に UUID を自動生成 |
@default(autoincrement()) | 自動増分整数(MySQL/PostgreSQL) |
@unique | フィールドに一意性を強制 |
@updatedAt | レコード更新時にタイムスタンプを自動更新 |
@relation | モデル間のリレーションを定義 |
@map | フィールドを異なる名前の列にマッピング |
@@index | フィールドにデータベースインデックスを作成 |
@@unique | 複合一意制約 |
@@map | モデルを異なる名前のテーブルにマッピング |
Cursor に依頼:「Eコマースプラットフォームの Prisma スキーマを生成して。User、Product、Order、OrderItem、Category モデルを含めて。適切なリレーション、インデックス、注文ステータスと製品可用性の列挙型を含めて。」Cursor が正しいリレーション構文を持つ完全な、検証済みのスキーマを生成します。
リレーション
Prisma は一対一、一対多、多対多のリレーションをサポートしています。
一対一:
model User {
  id      String   @id @default(uuid())
  profile Profile?
}

model Profile {
  id     String @id @default(uuid())
  user   User   @relation(fields: [userId], references: [id])
  userId String @unique
}
一対多:
model User {
  id    String @id @default(uuid())
  posts Post[]
}

model Post {
  id       String @id @default(uuid())
  author   User   @relation(fields: [authorId], references: [id])
  authorId String
}
多対多(暗黙的):
model Post {
  id         String     @id @default(uuid())
  categories Category[]
}

model Category {
  id    String @id @default(uuid())
  posts Post[]
}
多対多(明示的、結合テーブルに追加フィールドあり):
model Post {
  id       String      @id @default(uuid())
  tags     PostTag[]
}

model Tag {
  id    String   @id @default(uuid())
  posts PostTag[]
}

model PostTag {
  post      Post   @relation(fields: [postId], references: [id])
  postId    String
  tag       Tag    @relation(fields: [tagId], references: [id])
  tagId     String
  assignedAt DateTime @default(now())

  @@id([postId, tagId])
}
暗黙的な多対多リレーションを使用する場合、Prisma は非表示の結合テーブルを自動生成します。この非表示テーブルに追加フィールド(assignedAt や createdBy など)を追加することはできません。リレーションにメタデータが必要な場合は、上記のような明示的な結合テーブルを使用してください。
マイグレーション
Prisma Migrate はバージョン管理された、元に戻せる方法でデータベーススキーマの変更を作成して適用します。
最初のマイグレーションの作成
スキーマを定義した後、初期マイグレーションを作成:
npx prisma migrate dev --name init
このコマンドは:
prisma/migrations/に SQL マイグレーションファイルを生成。- データベースにマイグレーションを適用。
- Prisma Client を再生成。
説明的なマイグレーション名を使用:npx prisma migrate dev --name add_order_status_enum。これらの名前はマイグレーション履歴に表示され、スキーマの進化を追跡するのに役立ちます。
スキーマの変更
スキーマを変更したら、新しいマイグレーションを作成:
# After editing schema.prisma
npx prisma migrate dev --name add_post_view_count
Prisma はスキーマとデータベースの差分を検出し、マイグレーションを生成して適用します。
本番環境のマイグレーションワークフロー
本番データベースには prisma migrate deploy を使用します。これはデータをリセットせずに保留中のマイグレーションを適用します:
# Apply migrations in production
npx prisma migrate deploy
本番データベースに対して prisma migrate dev を実行しないでください。dev コマンドはスキーマドリフトを検出した場合、データベースをリセットする可能性があります。本番環境では常に migrate deploy を使用してください。
データベースのリセット
開発中にデータベースをリセットしてすべてのマイグレーションを再適用する必要がある場合:
npx prisma migrate reset
すべてのデータとテーブルを削除し、最初からすべてのマイグレーションを再適用します。
データベースのシード
初期データでデータベースを投入するシードスクリプトを作成:
// prisma/seed.ts
import { PrismaClient } from '@prisma/client';
const prisma = new PrismaClient();
async function main() {
// Create users
const alice = await prisma.user.create({
data: {
name: 'Alice Johnson',
role: 'ADMIN',
profile: {
create: {
bio: 'Software engineer and blogger',
},
},
},
});
const bob = await prisma.user.create({
data: {
name: 'Bob Smith',
role: 'USER',
},
});
// Create posts
const post1 = await prisma.post.create({
data: {
title: 'Getting Started with Prisma',
content: 'Prisma is a type-safe ORM...',
published: true,
author: { connect: { id: alice.id } },
},
});
const post2 = await prisma.post.create({
data: {
title: 'Advanced Prisma Relations',
content: 'Relations in Prisma...',
published: true,
author: { connect: { id: alice.id } },
},
});
console.log('Seed data created successfully');
}
main()
.catch((e) => {
console.error(e);
process.exit(1);
})
.finally(async () => {
await prisma.$disconnect();
});
package.json で seed コマンドを設定:
{
  "prisma": {
    "seed": "tsx prisma/seed.ts"
  }
}
シードを実行:
npx prisma db seed
Cursor に依頼:「Prisma スキーマのシードスクリプトを作成して。5人のユーザー、20件の記事、10個のカテゴリーを含めて。一部の記事は未公開で、一部のユーザーにはプロフィールがあり他にはないようにして。」Cursor がすべてのリレーションタイプを網羅するリアルなシードスクリプトを生成します。
Prisma Client クエリ
Prisma Client は、従来の ORM モデルと生 SQL を置き換える自動生成された型安全なクエリビルダーです。
クライアントのインスタンス化
開発での複数接続を避けるため、シングルトンインスタンスを作成:
// lib/prisma.ts
import { PrismaClient } from '@prisma/client';

const globalForPrisma = globalThis as unknown as {
  prisma: PrismaClient | undefined;
};

export const prisma =
  globalForPrisma.prisma ??
  new PrismaClient({
    log: ['query', 'info', 'warn', 'error'],
  });

if (process.env.NODE_ENV !== 'production') {
  globalForPrisma.prisma = prisma;
}
ホットモジュールリロードを使用する開発環境では、ファイル変更ごとに新しい PrismaClient を作成すると接続プールが枯渇します。上記のシングルトンパターンは globalThis にインスタンスをキャッシュすることでこれを防ぎます。
CRUD 操作
作成:
// Create a single record
const user = await prisma.user.create({
data: {
name: 'Charlie Brown',
profile: {
create: {
bio: 'New user bio',
},
},
},
});
// Create multiple records
const users = await prisma.user.createMany({
data: [
],
});
読み取り:
// Find a single record
const user = await prisma.user.findUnique({
include: { profile: true, posts: true },
});
// Find multiple records with filtering and sorting
const publishedPosts = await prisma.post.findMany({
where: { published: true },
orderBy: { createdAt: 'desc' },
take: 10,
skip: 0,
include: {
author: {
select: { id: true, name: true, email: true },
},
},
});
// Count records
const totalPosts = await prisma.post.count({
where: { published: true },
});
更新:
// Update a single record
const updatedPost = await prisma.post.update({
  where: { id: postId },
  data: {
    title: 'Updated Title',
    viewCount: { increment: 1 },
  },
});

// Update multiple records
const result = await prisma.post.updateMany({
  where: { published: false, authorId: userId },
  data: { published: true },
});
削除:
// Delete a single record
const deletedUser = await prisma.user.delete({
  where: { id: userId },
});

// Delete multiple records
const result = await prisma.post.deleteMany({
  where: { authorId: userId, published: false },
});
高度なフィルタリング
const posts = await prisma.post.findMany({
  where: {
    AND: [
      { published: true },
      {
        OR: [
          { title: { contains: 'prisma', mode: 'insensitive' } },
          { content: { contains: 'orm', mode: 'insensitive' } },
        ],
      },
    ],
    createdAt: {
      gte: new Date('2024-01-01'),
      lte: new Date('2024-12-31'),
    },
    author: {
      role: { in: ['ADMIN', 'EDITOR'] },
    },
  },
  orderBy: [{ viewCount: 'desc' }, { createdAt: 'desc' }],
});
トランザクション
// Interactive transaction
const result = await prisma.$transaction(async (tx) => {
const author = await tx.user.create({
});
const post = await tx.post.create({
data: {
title: 'My First Post',
content: 'Hello world',
authorId: author.id,
},
});
await tx.profile.create({
data: {
bio: 'New author profile',
userId: author.id,
},
});
return { author, post };
});
Cursor に依頼:「2人のユーザー間でクレジットを移転する Prisma トランザクションを書いて。送信者から差し引き、受信者に追加し、移転レコードを作成して。送信者の残高が不足している場合はロールバックして。」Cursor が適切なエラー処理付きのインタラクティブトランザクションを生成します。
ページネーション
// Offset-based pagination
const page = 1;
const pageSize = 10;

const [posts, totalCount] = await prisma.$transaction([
  prisma.post.findMany({
    where: { published: true },
    orderBy: { createdAt: 'desc' },
    skip: (page - 1) * pageSize,
    take: pageSize,
    include: { author: true },
  }),
  prisma.post.count({ where: { published: true } }),
]);

const totalPages = Math.ceil(totalCount / pageSize);
Prisma Studio
Prisma Studio はブラウザで実行されるビジュアルデータベースブラウザです。クエリを書くことなくレコードの表示、作成、更新、削除ができます。
Prisma Studio の起動
npx prisma studio
http://localhost:5555 でブラウザインターフェースが開き、以下ができます:
- スキーマで定義されたすべてのモデルの閲覧。
- ソート可能、フィルタ可能なテーブルでのレコード表示。
- フォームインターフェースでの新規レコード作成。
- セルのクリックによる既存レコードの編集。
- 確認ダイアログでのレコード削除。
- フィールド値によるレコードのフィルタリングと検索。
Prisma Studio は開発中のデバッグに非常に役立ちます。使い捨てのクエリを書く代わりに、Studio を起動してデータを検査し、素早く編集できます。変更がリアルタイムに反映されます。
Prisma Studio はデータベースに直接書き込みます。本番データベースに対して使用する際は注意してください。削除や編集の取り消しはできません。Studio で手動変更を行う前に必ずデータをバックアップしてください。
Studio でのフィルタリング
Prisma Studio は以下によるフィルタリングをサポート:
- フィールド名(任意の列を選択)。
- フィルタ演算子(等しい、等しくない、含む、で始まる、で終わるなど)。
- AND/OR ロジックで組み合わせた複数フィルタ。
Cursor での AI 支援スキーマ生成
Cursor の AI アシスタントは、自然言語の記述から Prisma スキーマ、クエリ、マイグレーション戦略を生成するのに優れています。
記述からのスキーマ生成
Cursor Chat(Ctrl+L)を開いてデータモデルを記述:
Generate a Prisma schema for a project management application with these models:
- User (id, email, name, avatar, role enum: ADMIN/MEMBER/VIEWER)
- Workspace (id, name, slug, ownerId)
- Project (id, name, description, workspaceId, status enum)
- Task (id, title, description, status, priority, assigneeId, projectId, dueDate)
- Comment (id, content, authorId, taskId)
- Label (id, name, color, projectId)
Include all necessary relations, indexes on foreign keys, and timestamps.
Use PostgreSQL with UUID primary keys.
Cursor はすべてのモデル、リレーション、列挙型、インデックスを含む完全なスキーマを生成します。生成されたスキーマには User、Workspace、Project、Task、Comment、Label モデルが含まれ、適切な外部キーリレーション、複合一意制約、すべての外部キー列のデータベースインデックスが含まれます。
Cursor にスキーマの生成を依頼する際は、データベースプロバイダー(PostgreSQL、MySQL など)、主キーの型(UUID か自動増分か)、インデックスが必要かどうかを指定してください。これにより生成されたスキーマがデータベース固有の機能を正しく使用します。
AI 支援クエリ生成
Cursor に複雑なクエリの作成を依頼:
Write a Prisma query to fetch the top 5 most active users in a workspace,
sorted by the number of completed tasks. Include each user's name, email,
avatar, and task count. Only count tasks created in the last 30 days.
const thirtyDaysAgo = new Date();
thirtyDaysAgo.setDate(thirtyDaysAgo.getDate() - 30);

const topUsers = await prisma.user.findMany({
  where: {
    assignedTasks: {
      some: {
        status: 'DONE',
        createdAt: { gte: thirtyDaysAgo },
        project: { workspaceId },
      },
    },
  },
  select: {
    id: true,
    name: true,
    email: true,
    avatar: true,
    _count: {
      select: {
        assignedTasks: {
          where: {
            status: 'DONE',
            createdAt: { gte: thirtyDaysAgo },
          },
        },
      },
    },
  },
  orderBy: {
    assignedTasks: {
      _count: 'desc',
    },
  },
  take: 5,
});
Prisma の _count をネストフィルタリングと組み合わせると、高コストな SQL クエリが生成される可能性があります。常に生成された SQL を確認し(new PrismaClient({ log: ['query'] }) でクエリログを有効化)、フルテーブルスキャンを避けるための適切なデータベースインデックスを追加してください。
まとめ
Prisma と Cursor の組み合わせにより、合理化されたデータベース開発体験が生まれます。宣言的スキーマファイルが唯一の真実の情報源として機能し、マイグレーションがスキーマ進化のための安全なパスを提供し、型安全な Prisma Client がコンパイル時にクエリエラーをキャッチし、Prisma Studio がデータ検査のためのビジュアルインターフェースを提供します。Cursor の AI アシスタントは、複雑なドメインモデルの完全なスキーマの生成から、ネストされたインクルードと集計を含む最適化されたクエリの作成まで、すべてのステップを加速します。Prisma 拡張機能をインストールし、適切なリレーションとインデックスでモデルを定義し、開発中は migrate dev を、本番では migrate deploy を使用し、Cursor に反復的なボイラープレートを生成させて、アプリケーションのデータ層に集中しましょう。