Cursor 中 Context Sync 的故障排除与优化
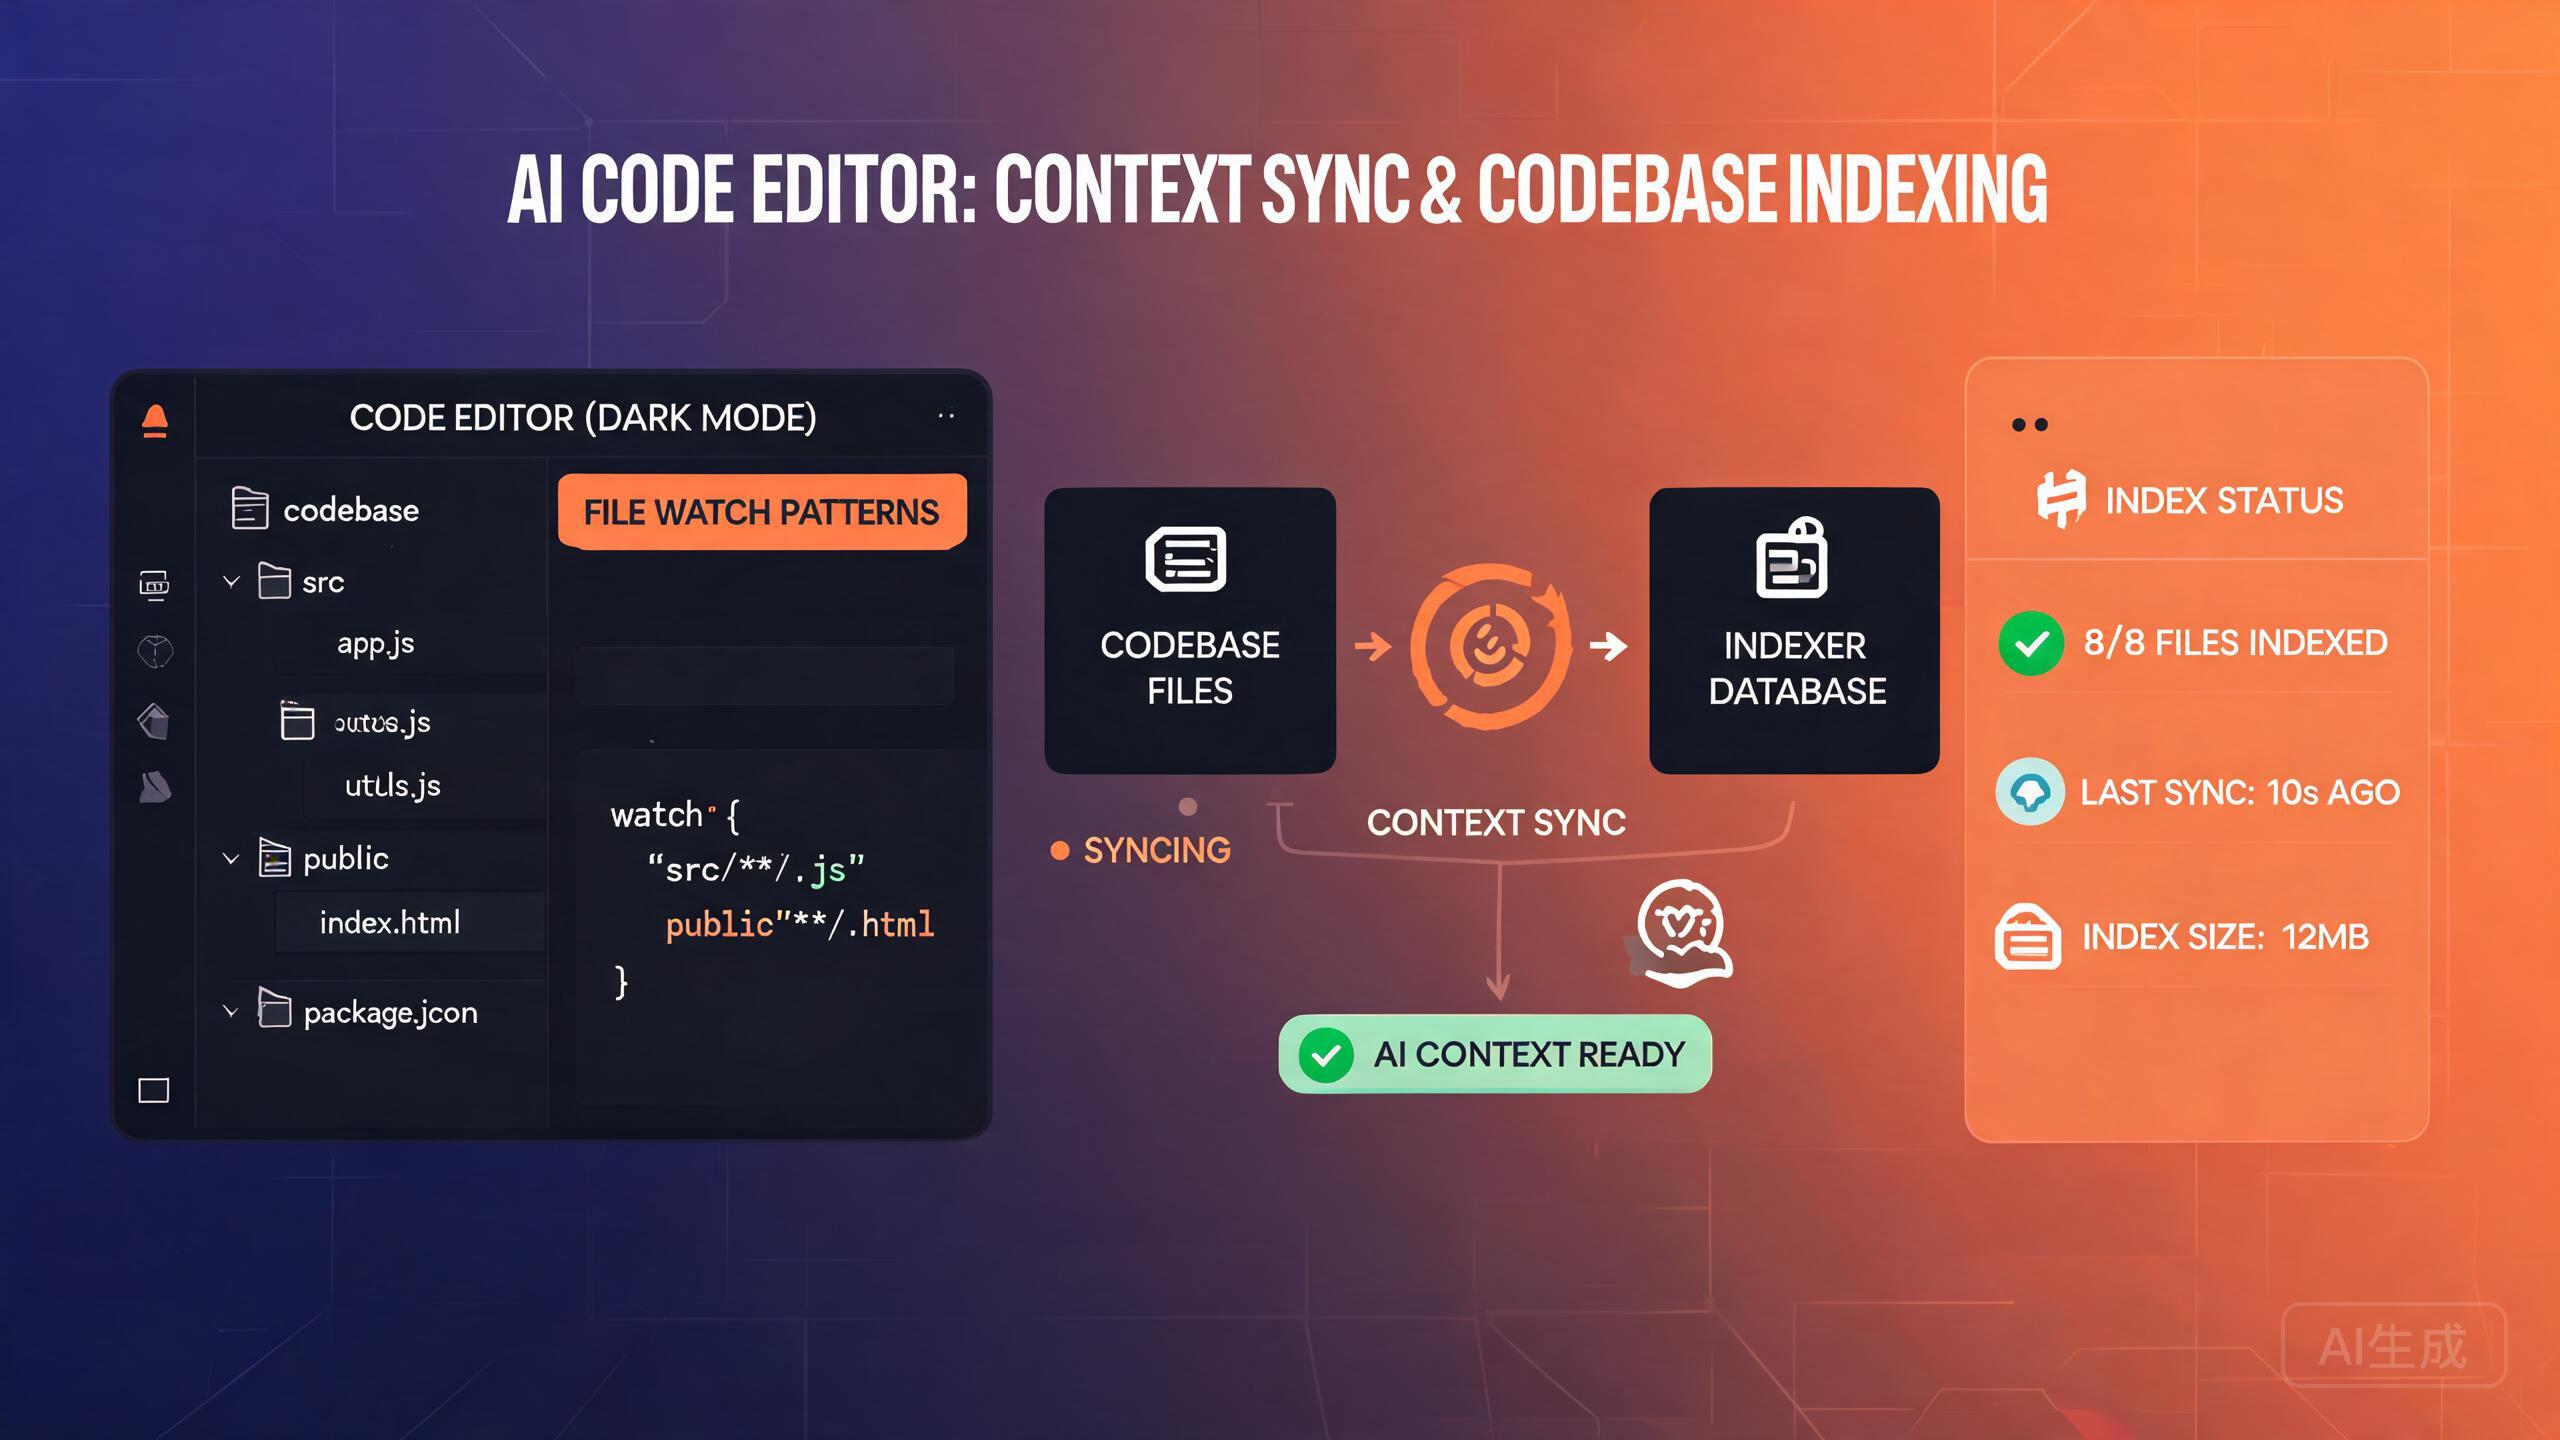
Context Sync 是 Cursor 用来索引你的代码库并向 AI 助手提供相关上下文的机制。当它正常工作时,它能实现准确的代码建议、精确的文件引用和智能的项目感知响应。当它出现问题时,你可能会遇到过时的建议、缺失的文件引用或可怕的"Context Sync 未运行"错误。本指南将带你了解诊断、修复和优化。
理解 Context Sync
Context Sync 在后台运行,持续扫描你的项目文件并构建可搜索的索引。这个索引让 AI 能够理解你的项目结构、找到相关文件并提供上下文准确的响应。
索引的工作原理
索引过程遵循以下阶段:
- 发现:Cursor 扫描工作区中的所有文件,遵循
.gitignore和自定义排除规则 - 解析:每个文件被解析以提取符号、导入和结构元数据
- 嵌入:代码块被转换为向量嵌入以进行语义搜索
- 存储:索引存储在本地,可选同步到云端
- 更新:文件更改触发增量索引更新
大型代码库的首次索引可能需要几分钟时间。在此期间,你可能会注意到较高的 CPU 使用率和较慢的 AI 响应。这是正常的,在初始索引完成后会恢复正常。
上下文窗口管理
上下文窗口决定了 AI 一次可以处理的信息量。Cursor 会自动管理此过程,但了解限制有助于你优化工作流程:
| 计划 | 上下文窗口 | 最大索引文件数 |
|---|---|---|
| Free | 25,000 tokens | 500 个文件 |
| Pro | 200,000 tokens | 5,000 个文件 |
| Business | 200,000 tokens | 25,000 个文件 |
| Enterprise | 自定义 | 自定义 |
诊断 Context Sync 问题
检查同步状态
故障排除的第一步是检查当前的 Context Sync 状态。Cursor 提供了几种方法来做到这一点:
方法 1:状态栏
查看 Cursor 窗口的右下角。旋转图标表示正在同步,勾选标记表示同步已更新。如果你看到错误图标,将鼠标悬停在上面查看详情。
方法 2:命令面板
# 打开命令面板(Ctrl+Shift+P / Cmd+Shift+P)
# 输入:Cursor: Show Context Sync Status
这会打开一个详细面板,显示:
- 当前同步状态(运行中、已暂停、错误)
- 已索引文件数
- 上次同步时间戳
- 任何错误消息
- 磁盘上的索引大小
方法 3:输出面板
# View > Output
# 从下拉菜单中选择 "Cursor Indexing"
输出面板显示实时索引日志,包括逐文件进度和错误消息。
如果 Context Sync 状态显示"未运行"且没有可见错误,这可能表示静默失败。请检查输出面板中可能未显示到 UI 的错误消息。查找包含"ERROR"或"FATAL"的行。
常见错误消息
以下是最常遇到的 Context Sync 错误及其含义:
"Context Sync is not running"
这是一个通用错误,可能有多种原因。同步进程已停止,需要重新启动。请参阅下方的修复部分获取分步说明。
"Index corruption detected"
本地索引文件已损坏,通常是由于意外关闭或磁盘错误导致的。解决方案是删除索引并从头重建。
"File watcher limit reached"
操作系统的文件监视器限制已被超出。这在拥有大型工作区的 Linux 系统上很常见。解决方案是增加系统的 inotify 限制。
"Embedding service unavailable"
云嵌入服务暂时不可用。这通常是暂时的,会在几分钟内自行解决。
"Rate limit exceeded for indexing"
你已达到索引速率限制。这在短时间内修改过多文件时发生。等待几分钟后同步将自动恢复。
修复 Context Sync
快速修复:重启 Context Sync
大多数 Context Sync 问题的最简单修复方法是重启同步进程:
# 命令面板(Ctrl+Shift+P / Cmd+Shift+P)
# 输入:Cursor: Restart Context Sync
或者,你可以使用设置强制重启:
// 在 settings.json 中
{
  "cursor.contextSync.forceRestart": true
}
保存此设置后,Cursor 将在下次窗口重新加载时重启同步进程。
完全重建索引
当快速重启无法解决问题时,需要进行完全重建索引。这会删除现有索引并从头重建。
# 步骤 1:清除索引缓存
# 命令面板:Cursor: Clear Index Cache

# 步骤 2:触发完全重建索引
# 命令面板:Cursor: Reindex Workspace
在大型代码库上进行完全重建索引可能需要 10-30 分钟。在此期间,AI 功能的上下文将受限或不可用。请在休息时或不需要立即使用 AI 辅助时规划重建索引。
手动索引修复
如果内置命令不起作用,你可以手动清除索引文件:
在 Windows 上:
# 先关闭 Cursor
# 清除索引目录
Remove-Item -Recurse -Force "$env:APPDATA\Cursor\index"
Remove-Item -Recurse -Force "$env:APPDATA\Cursor\codebase-index"

# 清除缓存
Remove-Item -Recurse -Force "$env:APPDATA\Cursor\cache"

# 重启 Cursor 并让它重建索引
在 macOS 上:
# 先关闭 Cursor
rm -rf ~/Library/Application\ Support/Cursor/index
rm -rf ~/Library/Application\ Support/Cursor/codebase-index
rm -rf ~/Library/Application\ Support/Cursor/cache

# 重启 Cursor
在 Linux 上:
# 先关闭 Cursor
rm -rf ~/.config/Cursor/index
rm -rf ~/.config/Cursor/codebase-index
rm -rf ~/.config/Cursor/cache

# 重启 Cursor
在删除索引之前,检查其大小。如果索引目录异常大(小型项目达到数 GB),则很可能已损坏。在删除前记录大小以便重建后比较。
索引配置
优化索引范围
控制哪些文件被索引是提高 Context Sync 性能的最有效方法。默认情况下,Cursor 遵循 .gitignore,但你可以添加自定义排除。
// 在 settings.json 中
{
  "cursor.contextSync.exclude": [
    "**/node_modules/**",
    "**/dist/**",
    "**/build/**",
    "**/.next/**",
    "**/coverage/**",
    "**/*.min.js",
    "**/*.map",
    "**/vendor/**",
    "**/.cache/**",
    "**/*.lock",
    "**/package-lock.json",
    "**/yarn.lock",
    "**/*.png",
    "**/*.jpg",
    "**/*.gif",
    "**/*.svg"
  ],
  "cursor.contextSync.include": [
    "**/*.ts",
    "**/*.tsx",
    "**/*.js",
    "**/*.jsx",
    "**/*.py",
    "**/*.go",
    "**/*.rs",
    "**/README.md",
    "**/*.json"
  ]
}
在索引中包含二进制文件(图像、编译后的二进制文件、锁文件)会浪费空间并降低搜索质量。始终从索引中排除二进制和生成的文件。AI 无法有意义地处理二进制内容,这些文件会给索引增加噪声。
设置索引限制
对于非常大的代码库,你可以限制将被索引的最大文件数和最大文件大小:
{
  "cursor.contextSync.maxFiles": 10000,
  "cursor.contextSync.maxFileSize": 1048576,
  "cursor.contextSync.maxLinesPerFile": 5000
}
这些限制防止索引不受控制地增长,并确保最重要的文件被优先处理。
文件监视器配置
在 Linux 系统上,默认的 inotify 监视器限制对于大型项目通常太低。增加它以防止"file watcher limit reached"错误:
# 检查当前限制
cat /proc/sys/fs/inotify/max_user_watches

# 临时增加限制
sudo sysctl fs.inotify.max_user_watches=524288

# 永久增加限制
echo "fs.inotify.max_user_watches=524288" | sudo tee -a /etc/sysctl.conf
sudo sysctl -p
在 Windows 上,等效设置是 MaxExtendedTdiHandleCount 注册表值,但很少需要调整。
性能调优
测量索引性能
在优化之前,先建立当前索引性能的基准测量:
# 命令面板:Cursor: Show Index Statistics
这会显示:
Index Statistics
================
Total files:      3,247
Indexed files:    2,891 (89%)
Excluded files:   356
Index size:       142 MB
Last full index:  2026-09-14 14:30:22
Index duration:   4m 32s
Incremental updates today: 127
Average update time: 1.2s
Embedding cache hit rate: 87%
高嵌入缓存命中率(80% 以上)意味着大多数文件更改不需要新的嵌入。如果命中率低,可能表明文件被修改得太频繁或缓存太小。
针对大型 Monorepo 的优化
大型 monorepo 给 Context Sync 带来了独特的挑战。以下是处理它们的策略:
策略 1:项目特定索引
不要索引整个 monorepo,而是只索引你当前正在处理的项目:
{
  "cursor.contextSync.workspaceRoot": "packages/web-app",
  "cursor.contextSync.exclude": [
    "packages/**",
    "!packages/web-app/**"
  ]
}
这告诉 Cursor 排除所有包,但你正在积极处理的那个除外。
策略 2:基于符号的索引
启用基于符号的索引,它专注于函数和类定义而非完整文件内容:
{
  "cursor.contextSync.indexingMode": "symbols",
  "cursor.contextSync.symbolTypes": [
    "function",
    "class",
    "interface",
    "type",
    "method",
    "variable"
  ]
}
策略 3:基于优先级的索引
为不同目录分配优先级,以便关键代码先被索引:
{
  "cursor.contextSync.priority": {
    "src/core/**": "high",
    "src/api/**": "high",
    "src/components/**": "medium",
    "src/utils/**": "medium",
    "src/tests/**": "low",
    "docs/**": "low"
  }
}
基于优先级的索引不会排除低优先级文件,只是最后才索引它们。在初始索引阶段,高优先级文件最先变得可用,这在完整索引完成之前需要开始工作时很有用。
优化增量更新
增量更新在文件更改时触发。你可以控制这些更新的积极程度:
{
  "cursor.contextSync.incremental": {
    "enabled": true,
    "debounceMs": 2000,
    "batchSize": 10,
    "maxConcurrentUpdates": 3
  }
}
debounceMs:在最后一次文件更改后等待这么长时间再更新索引。值越高可减少更新频率但批量处理更多更改。batchSize:每个更新批次中处理的文件数。maxConcurrentUpdates:最大并行更新工作线程数。
云同步优化
如果你启用了云同步,它可能会在较慢的连接上影响性能:
{
  "cursor.contextSync.cloud": {
    "enabled": true,
    "syncInterval": 300000,
    "compressBeforeSync": true,
    "maxSyncSize": 50000000
  }
}
如果你经常离线工作,请增加同步间隔以避免不必要的连接尝试。本地索引在没有云同步的情况下完全可用,只是不会跨设备共享。
高级故障排除
诊断陈旧索引
如果 AI 引用了过时的代码或遗漏了最近的更改,索引可能已陈旧:
# 命令面板:Cursor: Validate Index Integrity
此命令检查:
- 索引中存在但磁盘上已不存在的文件
- 磁盘上存在但索引中不存在的文件
- 内容哈希与索引版本不匹配的文件
- 孤立的索引条目
# 示例输出
Index Integrity Report
======================
Total discrepancies: 14
  Missing from index:      3 files
  Stale entries:          8 files
  Orphaned entries:       3 files

Recommended action: Run "Cursor: Reindex Workspace" to fix all discrepancies.
调试文件监视器问题
如果文件更改未被 Context Sync 捕获,文件监视器可能未正常工作:
# 命令面板:Cursor: Test File Watcher
此命令创建一个临时测试文件并监视监视器是否检测到它:
File Watcher Test
=================
Creating test file: .cursor-test-watcher-12345.txt
Waiting for watcher response...
Watcher detected change: YES (after 0.3s)
File watcher is functioning correctly.

If you are experiencing sync issues, the problem may be with
specific directories. Check your exclude patterns.
检查嵌入服务健康状态
// 在 settings.json 中,启用嵌入诊断
{
  "cursor.contextSync.debugEmbeddings": true
}
启用后,输出面板将显示详细的嵌入信息:
[DEBUG] Embedding request: file=src/auth/login.ts, chunks=3, tokens=1842
[DEBUG] Embedding response: success, cache=hit, duration=12ms
[DEBUG] Embedding request: file=src/auth/register.ts, chunks=4, tokens=2103
[DEBUG] Embedding response: success, cache=miss, duration=894ms
[DEBUG] Embedding batch complete: 7 files, 24 chunks, 6 cache hits
如果所有嵌入请求都显示 cache=miss 且持续时间很长,嵌入缓存可能已损坏或太小。尝试在设置中增加缓存大小或完全清除缓存。
日志分析
对于持续性问题,收集诊断日志并进行分析:
# 命令面板:Cursor: Generate Diagnostic Report
这会创建一份综合报告,包括:
- Context Sync 配置
- 索引统计信息
- 最近的错误日志
- 文件监视器状态
- 嵌入服务健康状态
- 系统信息
报告保存到:
# Windows
%USERPROFILE%\Desktop\cursor-diagnostic-report.txt

# macOS / Linux
~/Desktop/cursor-diagnostic-report.txt
Context Sync 最佳实践
定期维护
- 每周:运行"Validate Index Integrity"以及早发现差异
- 每月:根据项目变更审查和更新排除模式
- 重大重构后:触发完全重建索引以确保结构性变更被捕获
- 依赖更新后:清除缓存以防止陈旧嵌入
工作区组织
// 大多数项目的推荐设置
{
  "cursor.contextSync.exclude": [
    "**/node_modules/**",
    "**/dist/**",
    "**/build/**",
    "**/.git/**",
    "**/*.log",
    "**/*.min.*",
    "**/coverage/**"
  ],
  "cursor.contextSync.maxFileSize": 1048576,
  "cursor.contextSync.incremental": {
    "enabled": true,
    "debounceMs": 2000
  }
}
如果你在同一工作区中处理多个项目,请使用多根工作区文件来分离索引上下文。每个根文件夹获得自己的索引,这提高了相关性并减少了索引大小。
处理大型生成文件
生成的文件如类型定义、编译输出和自动生成的 API 客户端会使索引膨胀。使用单独的 .cursorignore 文件进行精细控制:
# .cursorignore
# 排除所有生成的类型文件
src/types/generated/**
# 排除大型 schema 文件
schema/**/*.json
# 排除测试夹具
test/fixtures/**
# 排除迁移文件(它们很少需要用于 AI 上下文)
migrations/**
如果你排除了迁移文件,在处理数据库相关任务时请确保包含它们。你可以临时移除排除或使用 Cursor: Index File 命令按需索引特定文件。
总结
Context Sync 是 Cursor 智能代码辅助的骨干。通过理解索引的工作原理、知道如何诊断和修复常见问题,以及应用本指南中的优化策略,你可以确保 AI 助手始终拥有关于你代码库的准确、最新的上下文。
关键要点是:保持排除模式更新、定期执行完整性检查,在事情看起来不对时不要犹豫进行完全重建索引。健康的索引意味着更快、更准确的 AI 响应,这直接转化为开发者生产力的提升。